Βιογραφικό Data Engineer
Ταιριάζει σε: Για υποψηφίους που διεκδικούν ρόλους Data Engineer.
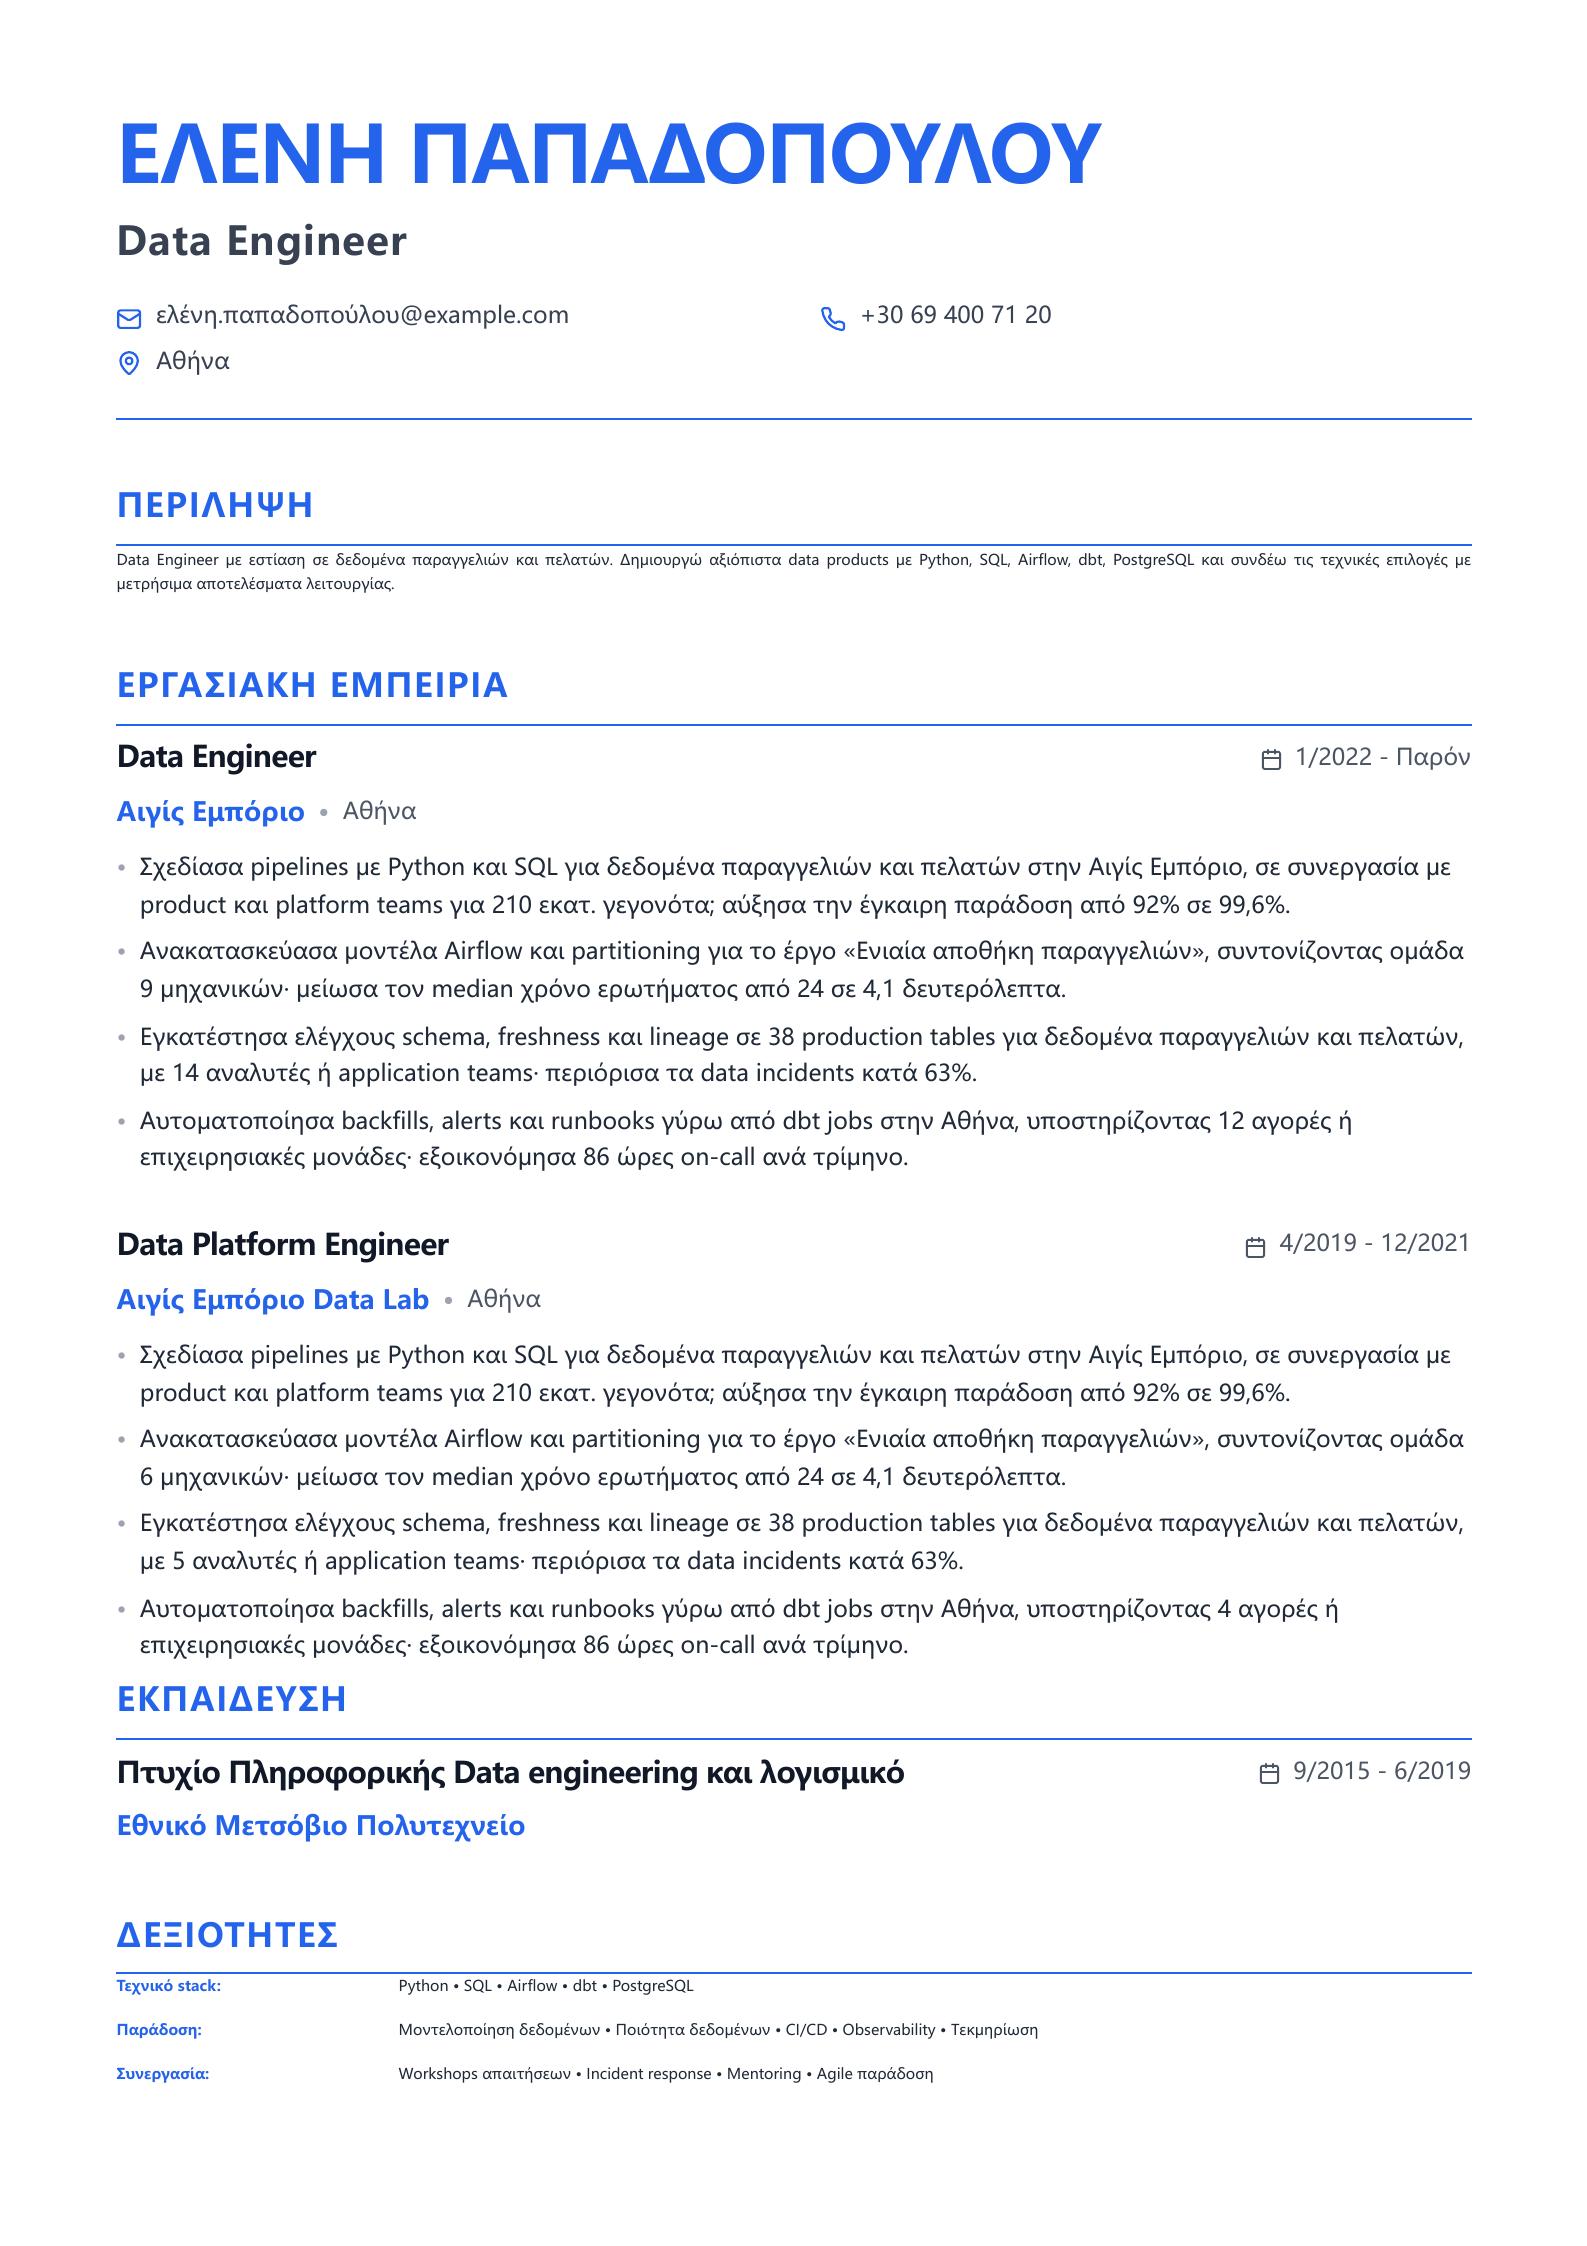
Πρωτότυπο ελληνικό παράδειγμα Data Engineer με pipelines παραγωγής, συνεργασία μεταξύ ομάδων και μετρήσιμες βελτιώσεις.
Συγκρίνετε ολοκληρωμένα ελληνικά βιογραφικά για cloud, warehouse, streaming, ETL, analytics και computer vision. Κάθε παράδειγμα συνδέει την τεχνική ενέργεια με την κλίμακα, τη συνεργασία και ένα αποτέλεσμα που μπορείτε να εξηγήσετε σε συνέντευξη.
Επιλέξτε ανά cloud πλατφόρμα, εμπειρία ή ειδίκευση, δείτε την πρώτη σελίδα και επεξεργαστείτε το πρότυπο.
Ταιριάζει σε: Για υποψηφίους που διεκδικούν ρόλους Data Engineer.
Πρωτότυπο ελληνικό παράδειγμα Data Engineer με pipelines παραγωγής, συνεργασία μεταξύ ομάδων και μετρήσιμες βελτιώσεις.
Ταιριάζει σε: Για υποψηφίους που διεκδικούν ρόλους Azure Data Engineer.
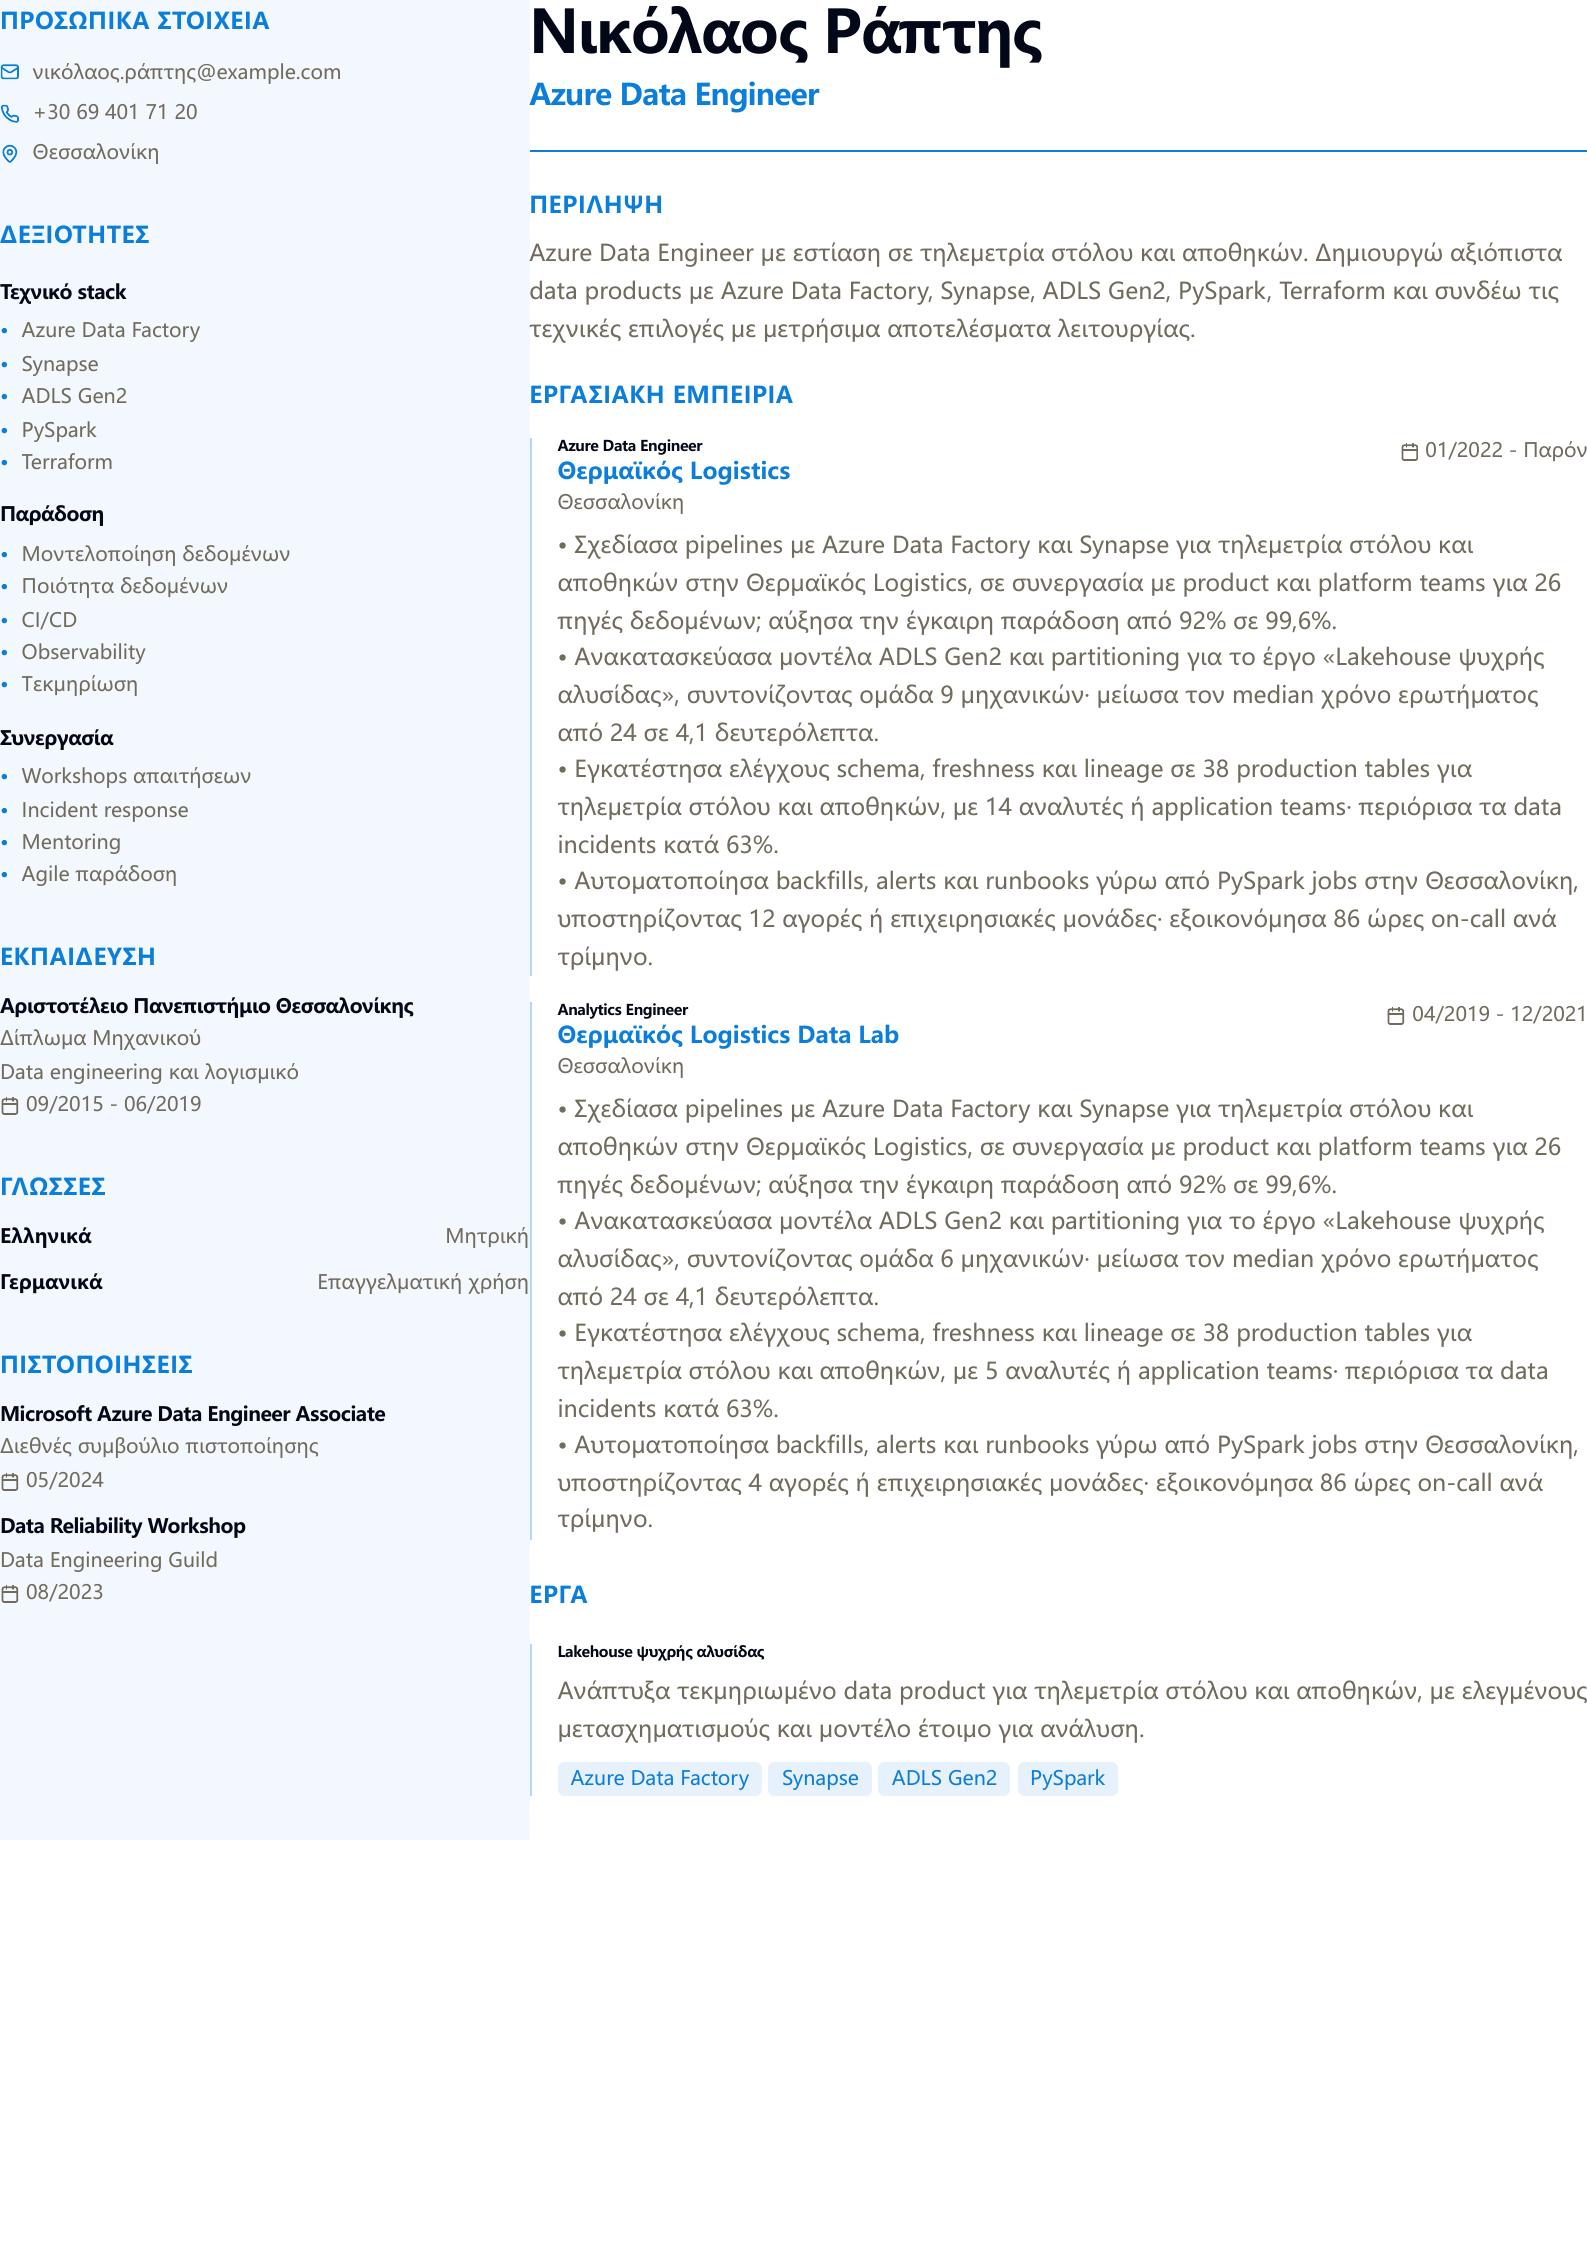
Πρωτότυπο ελληνικό παράδειγμα Azure Data Engineer με pipelines παραγωγής, συνεργασία μεταξύ ομάδων και μετρήσιμες βελτιώσεις.
Ταιριάζει σε: Για υποψηφίους που διεκδικούν ρόλους AWS Data Engineer.
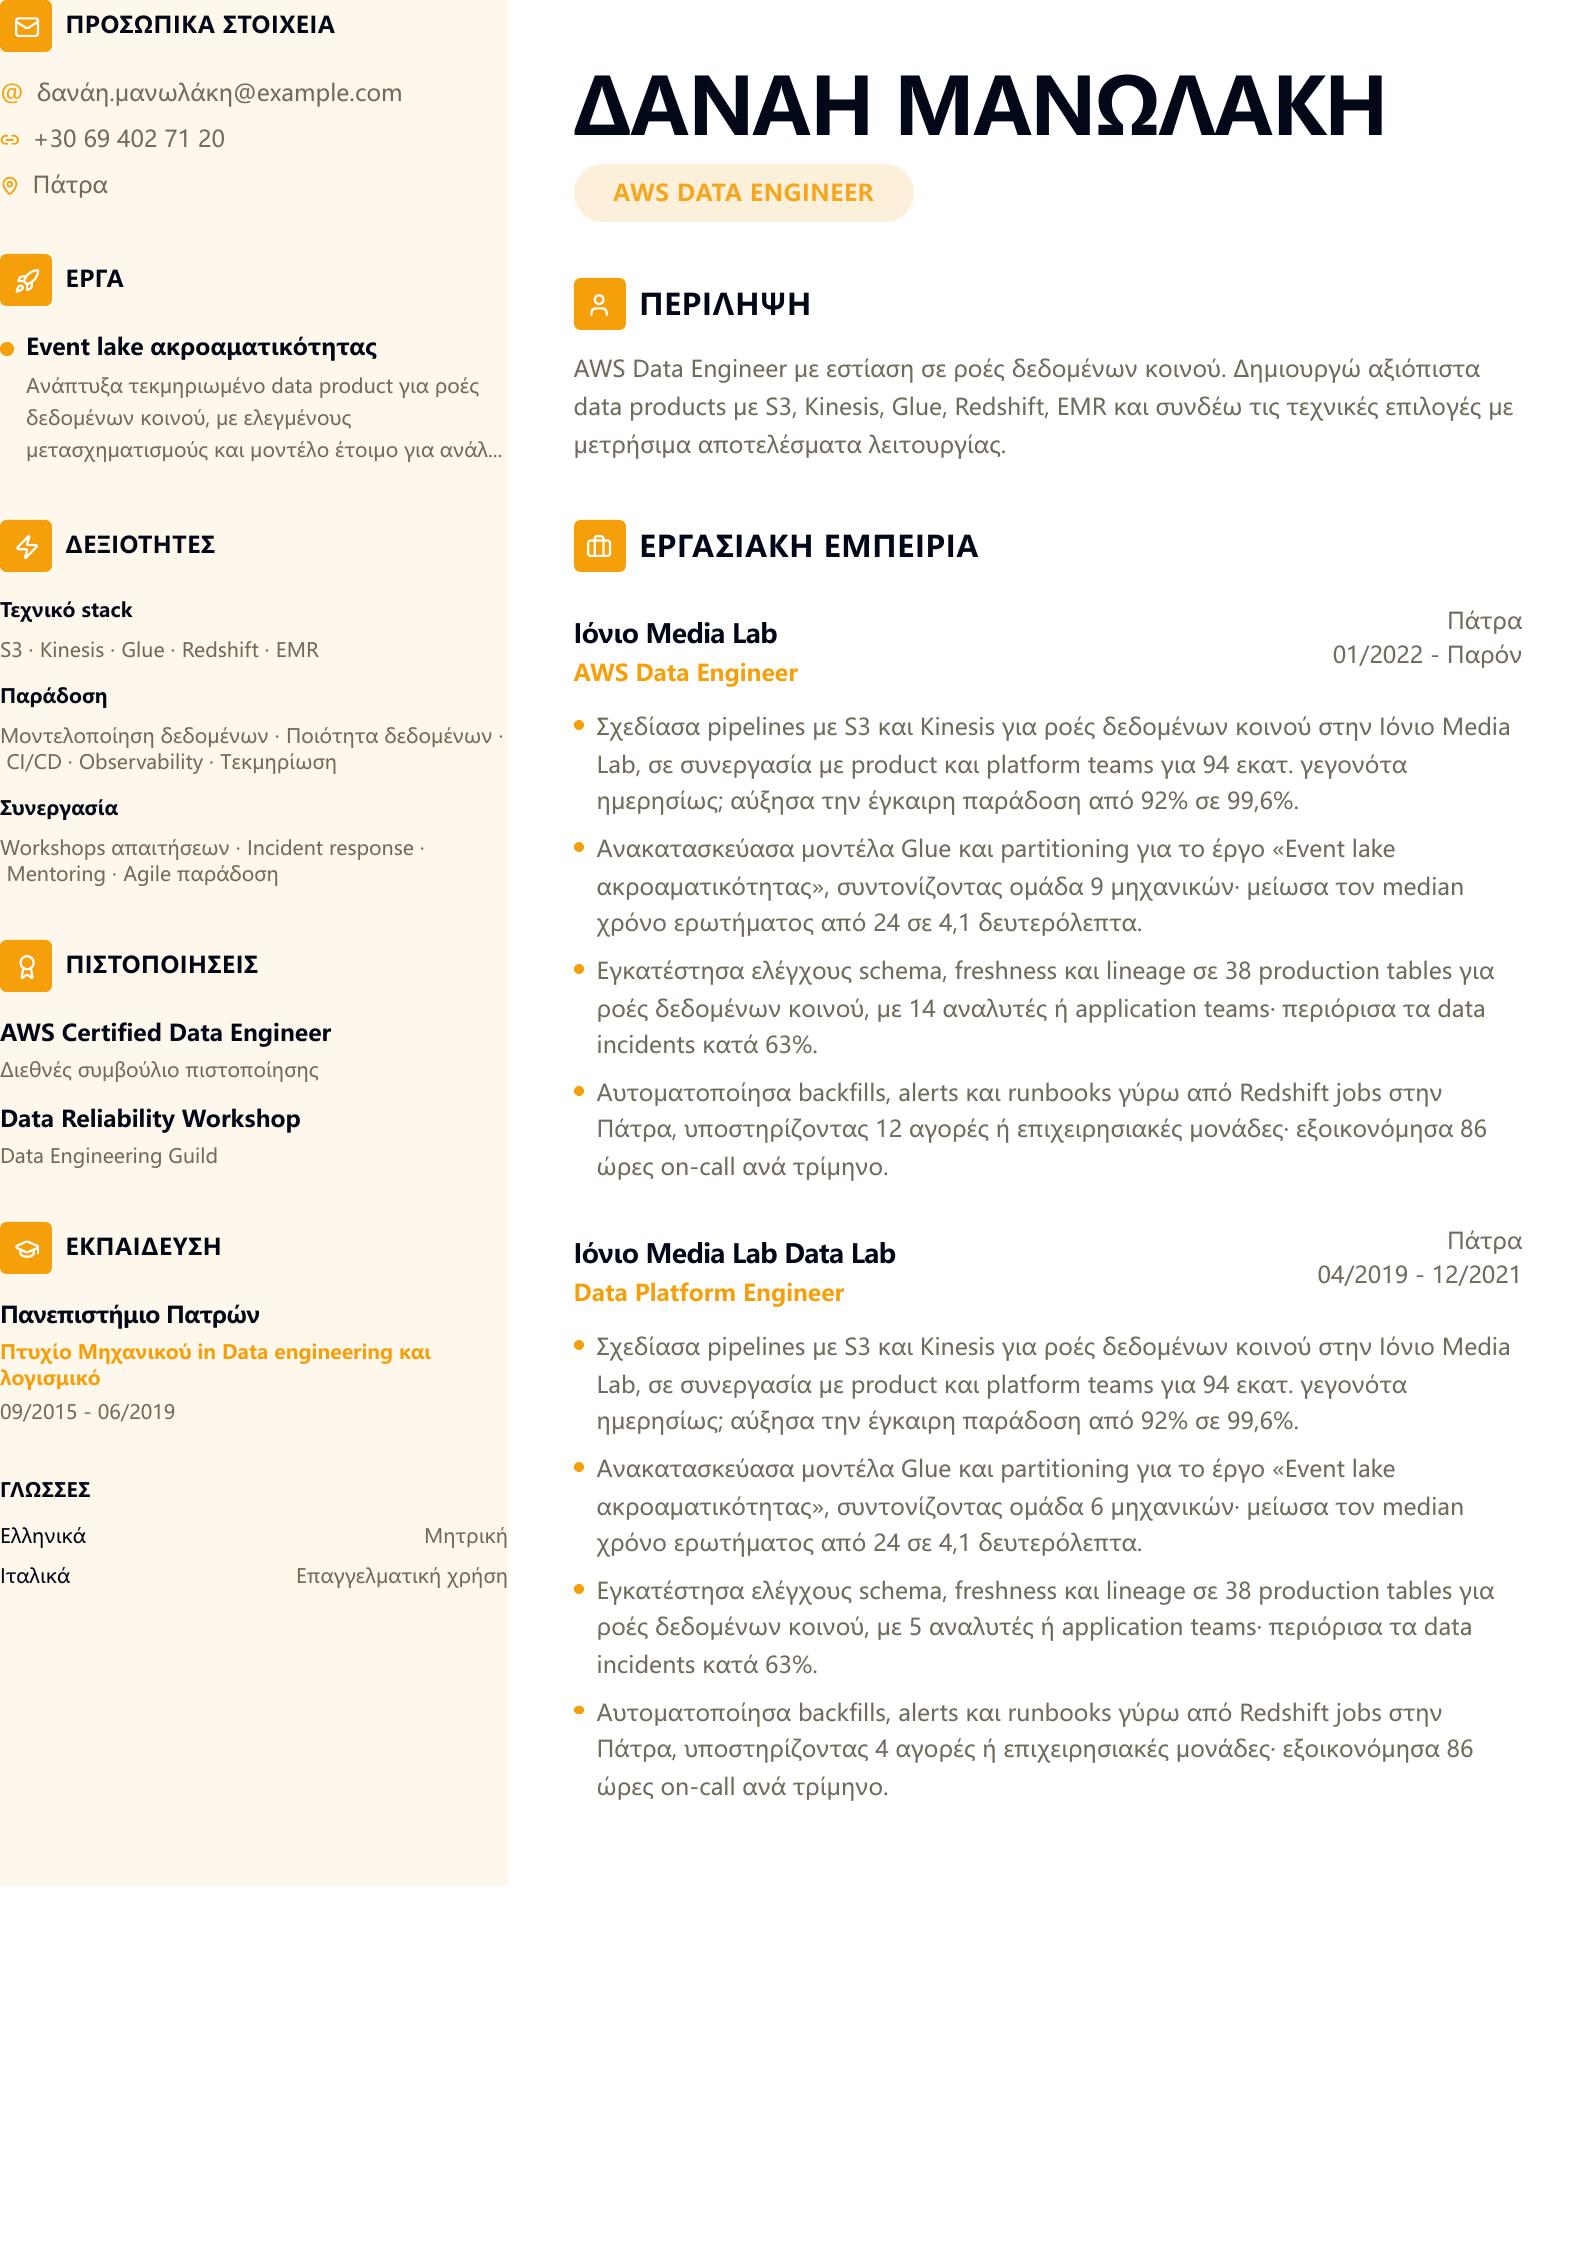
Πρωτότυπο ελληνικό παράδειγμα AWS Data Engineer με pipelines παραγωγής, συνεργασία μεταξύ ομάδων και μετρήσιμες βελτιώσεις.
Ταιριάζει σε: Για υποψηφίους που διεκδικούν ρόλους GCP Data Engineer.
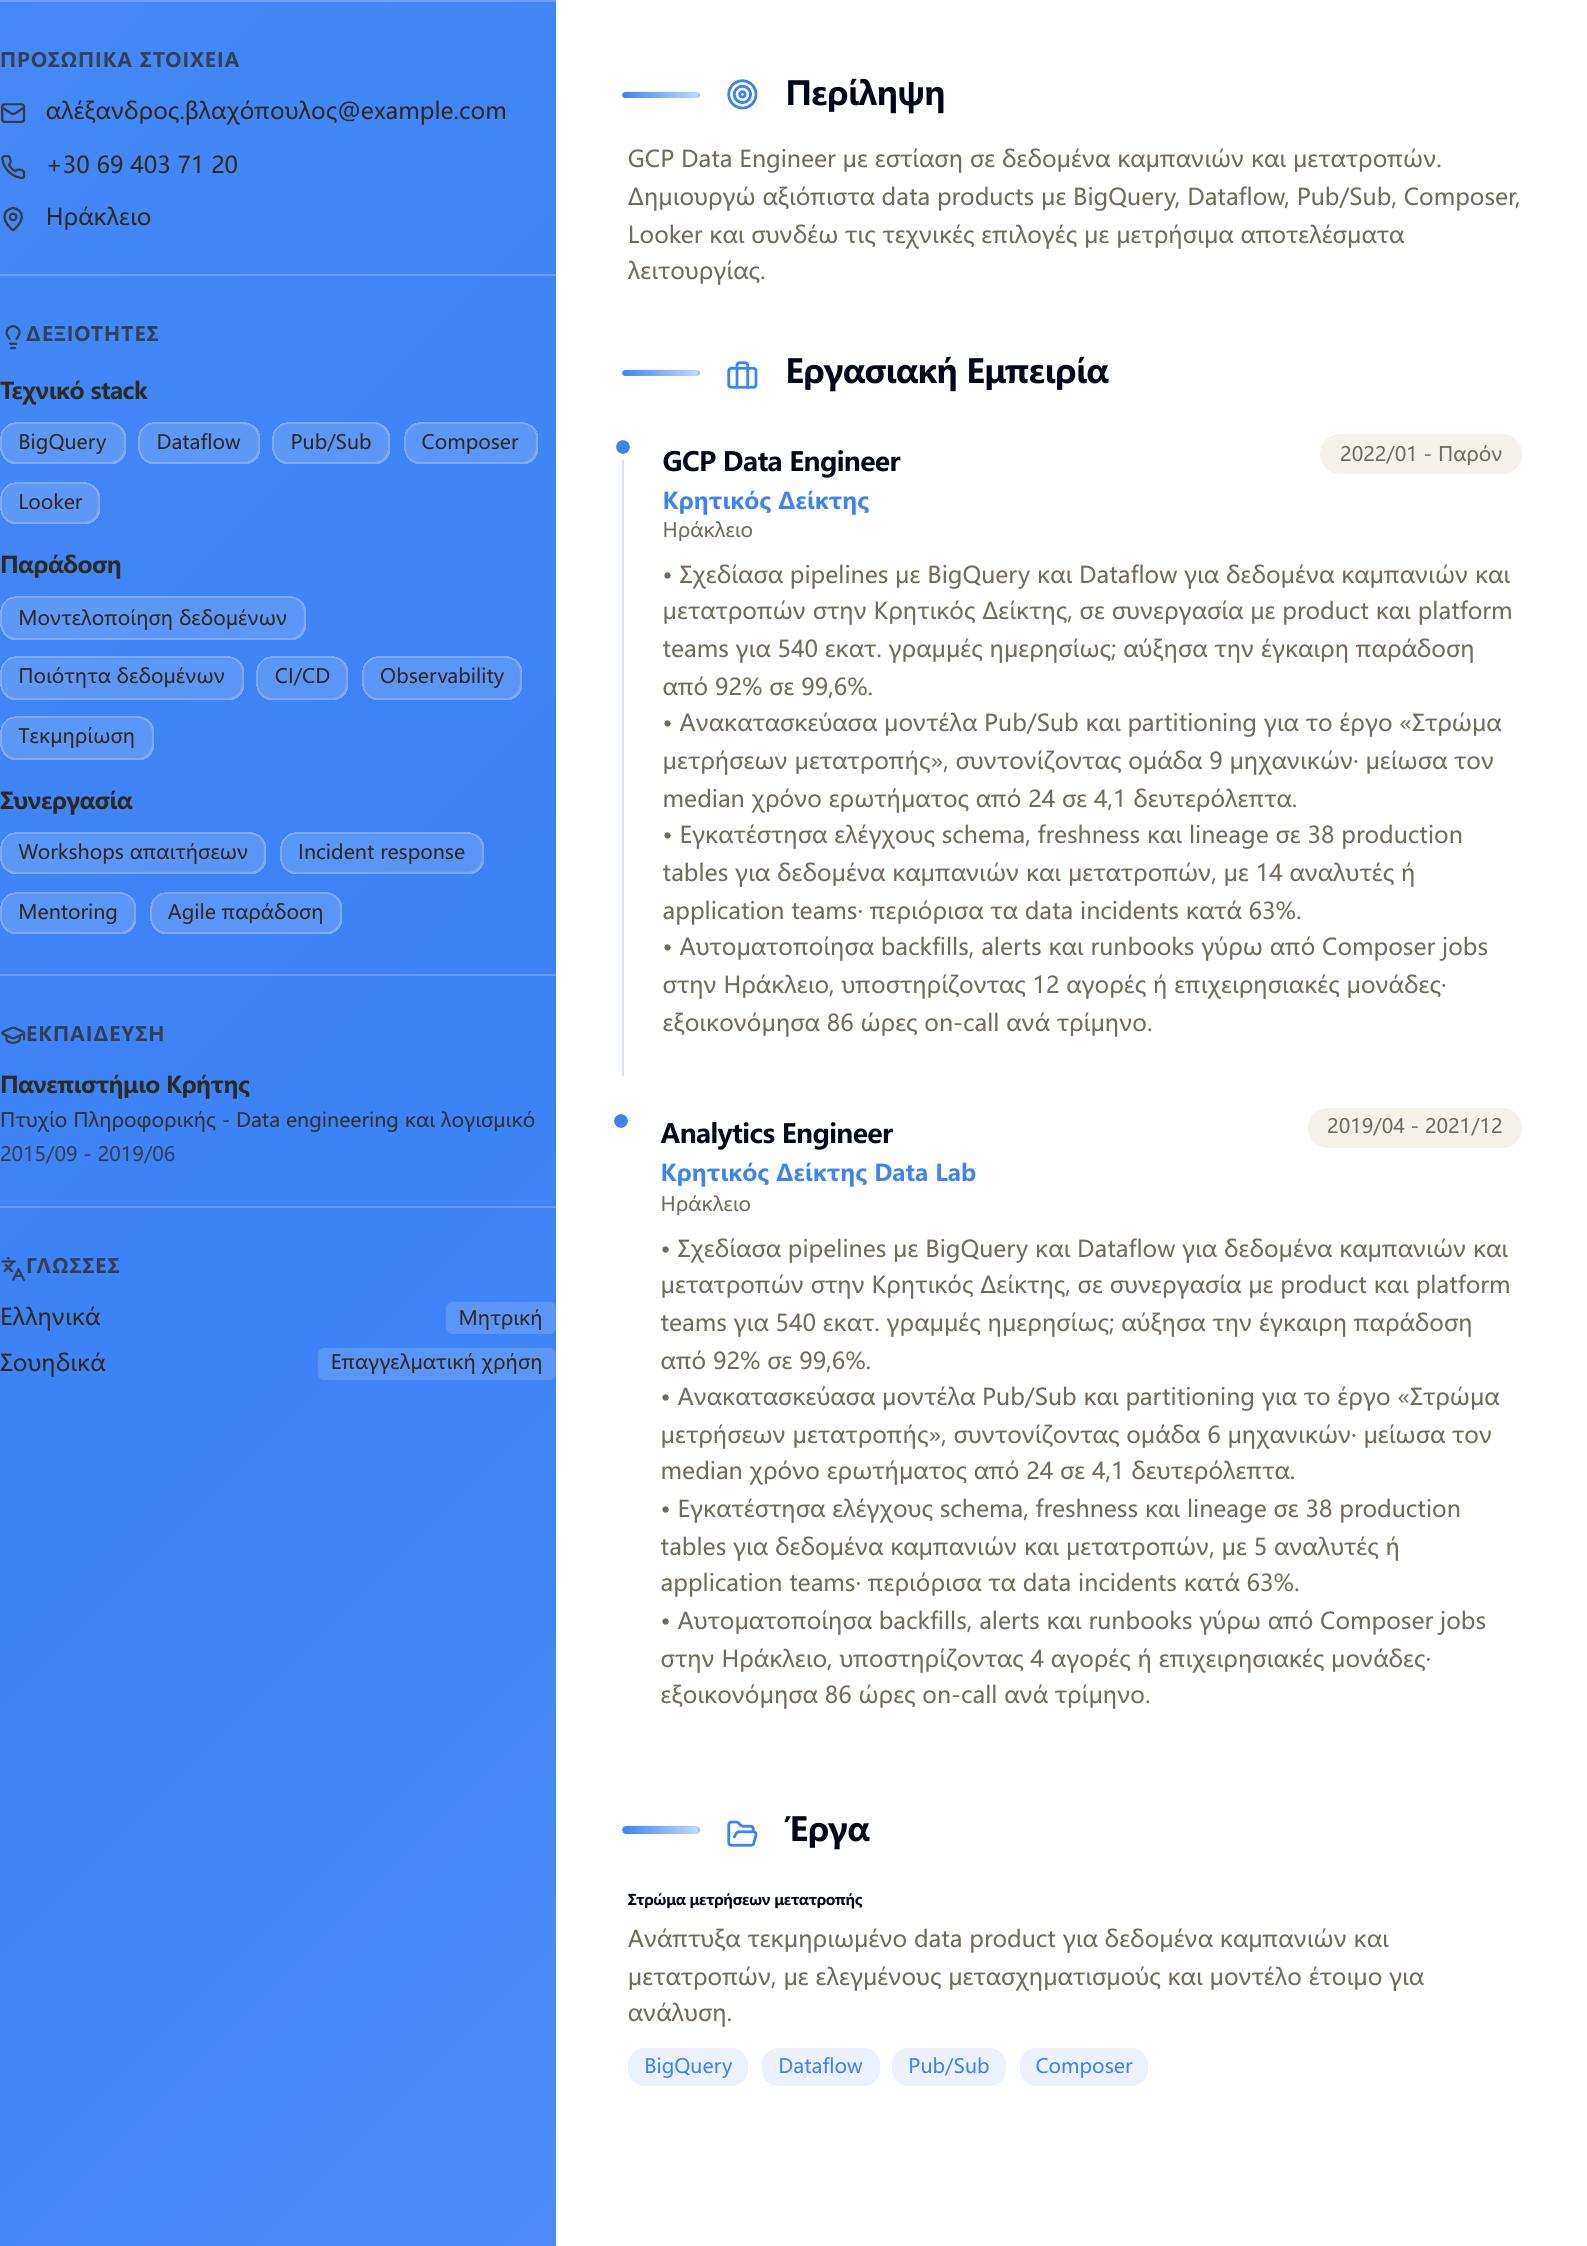
Πρωτότυπο ελληνικό παράδειγμα GCP Data Engineer με pipelines παραγωγής, συνεργασία μεταξύ ομάδων και μετρήσιμες βελτιώσεις.
Ταιριάζει σε: Για υποψηφίους που διεκδικούν ρόλους Snowflake Data Engineer.
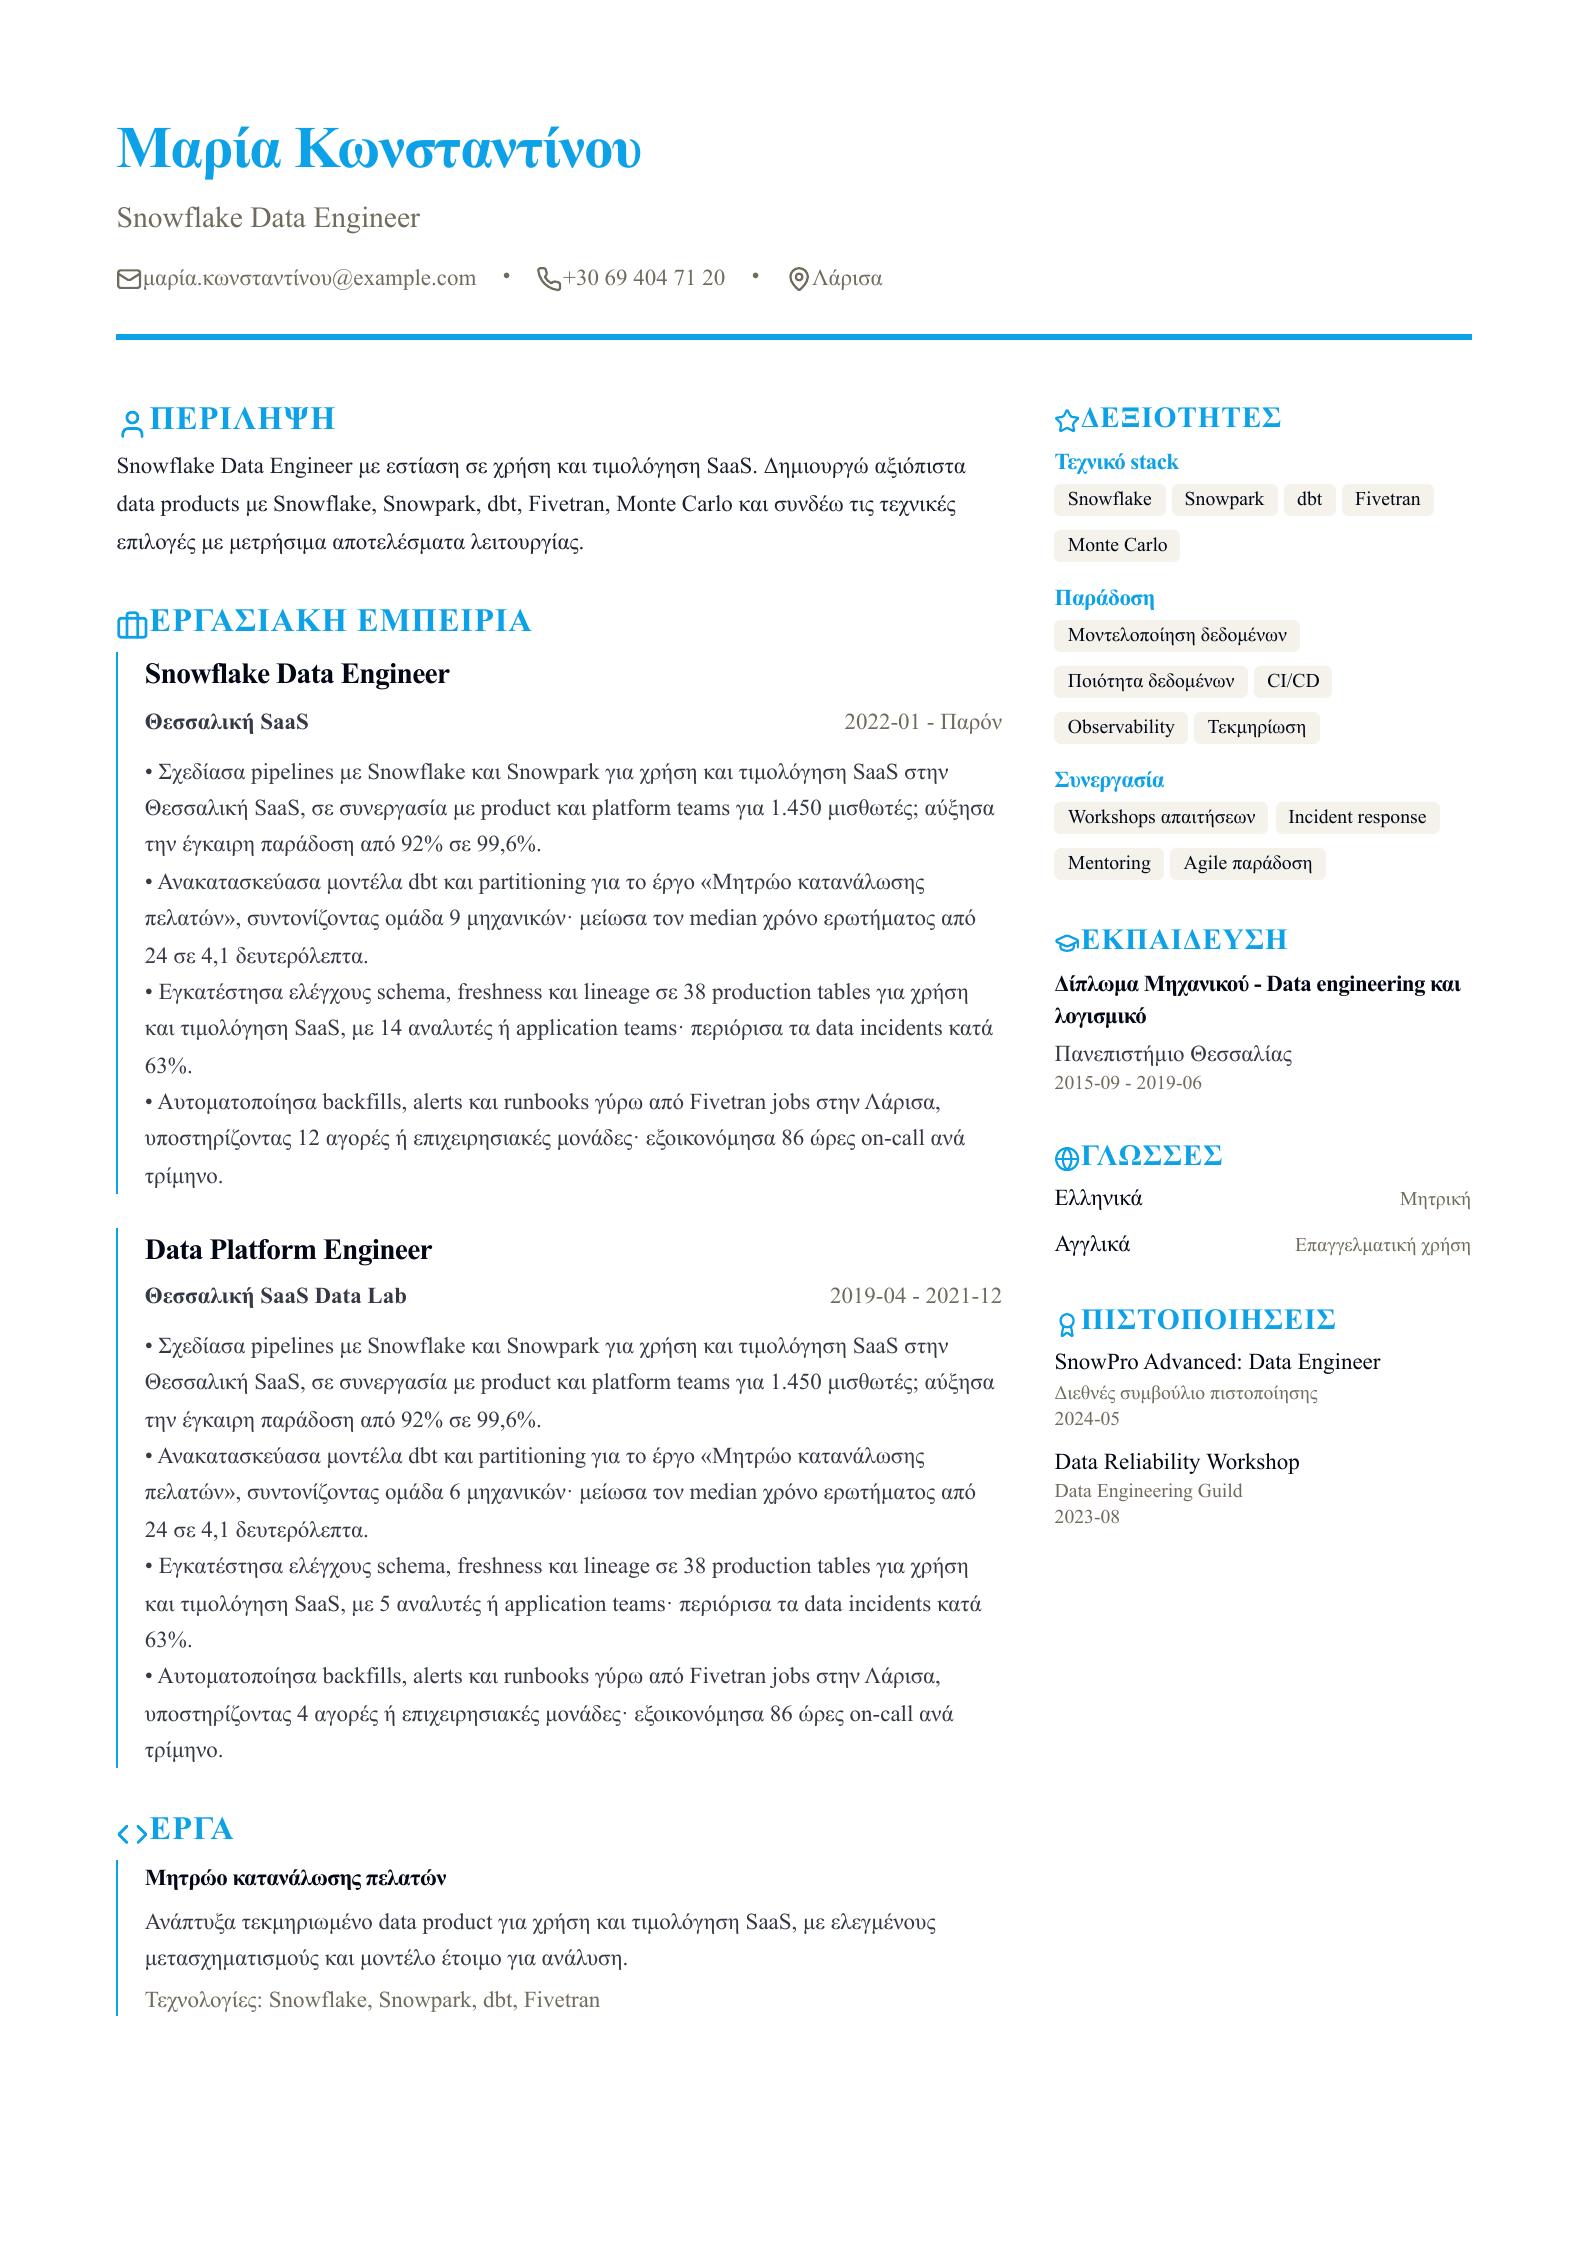
Πρωτότυπο ελληνικό παράδειγμα Snowflake Data Engineer με pipelines παραγωγής, συνεργασία μεταξύ ομάδων και μετρήσιμες βελτιώσεις.
Ταιριάζει σε: Για υποψηφίους που διεκδικούν ρόλους Big Data Engineer.
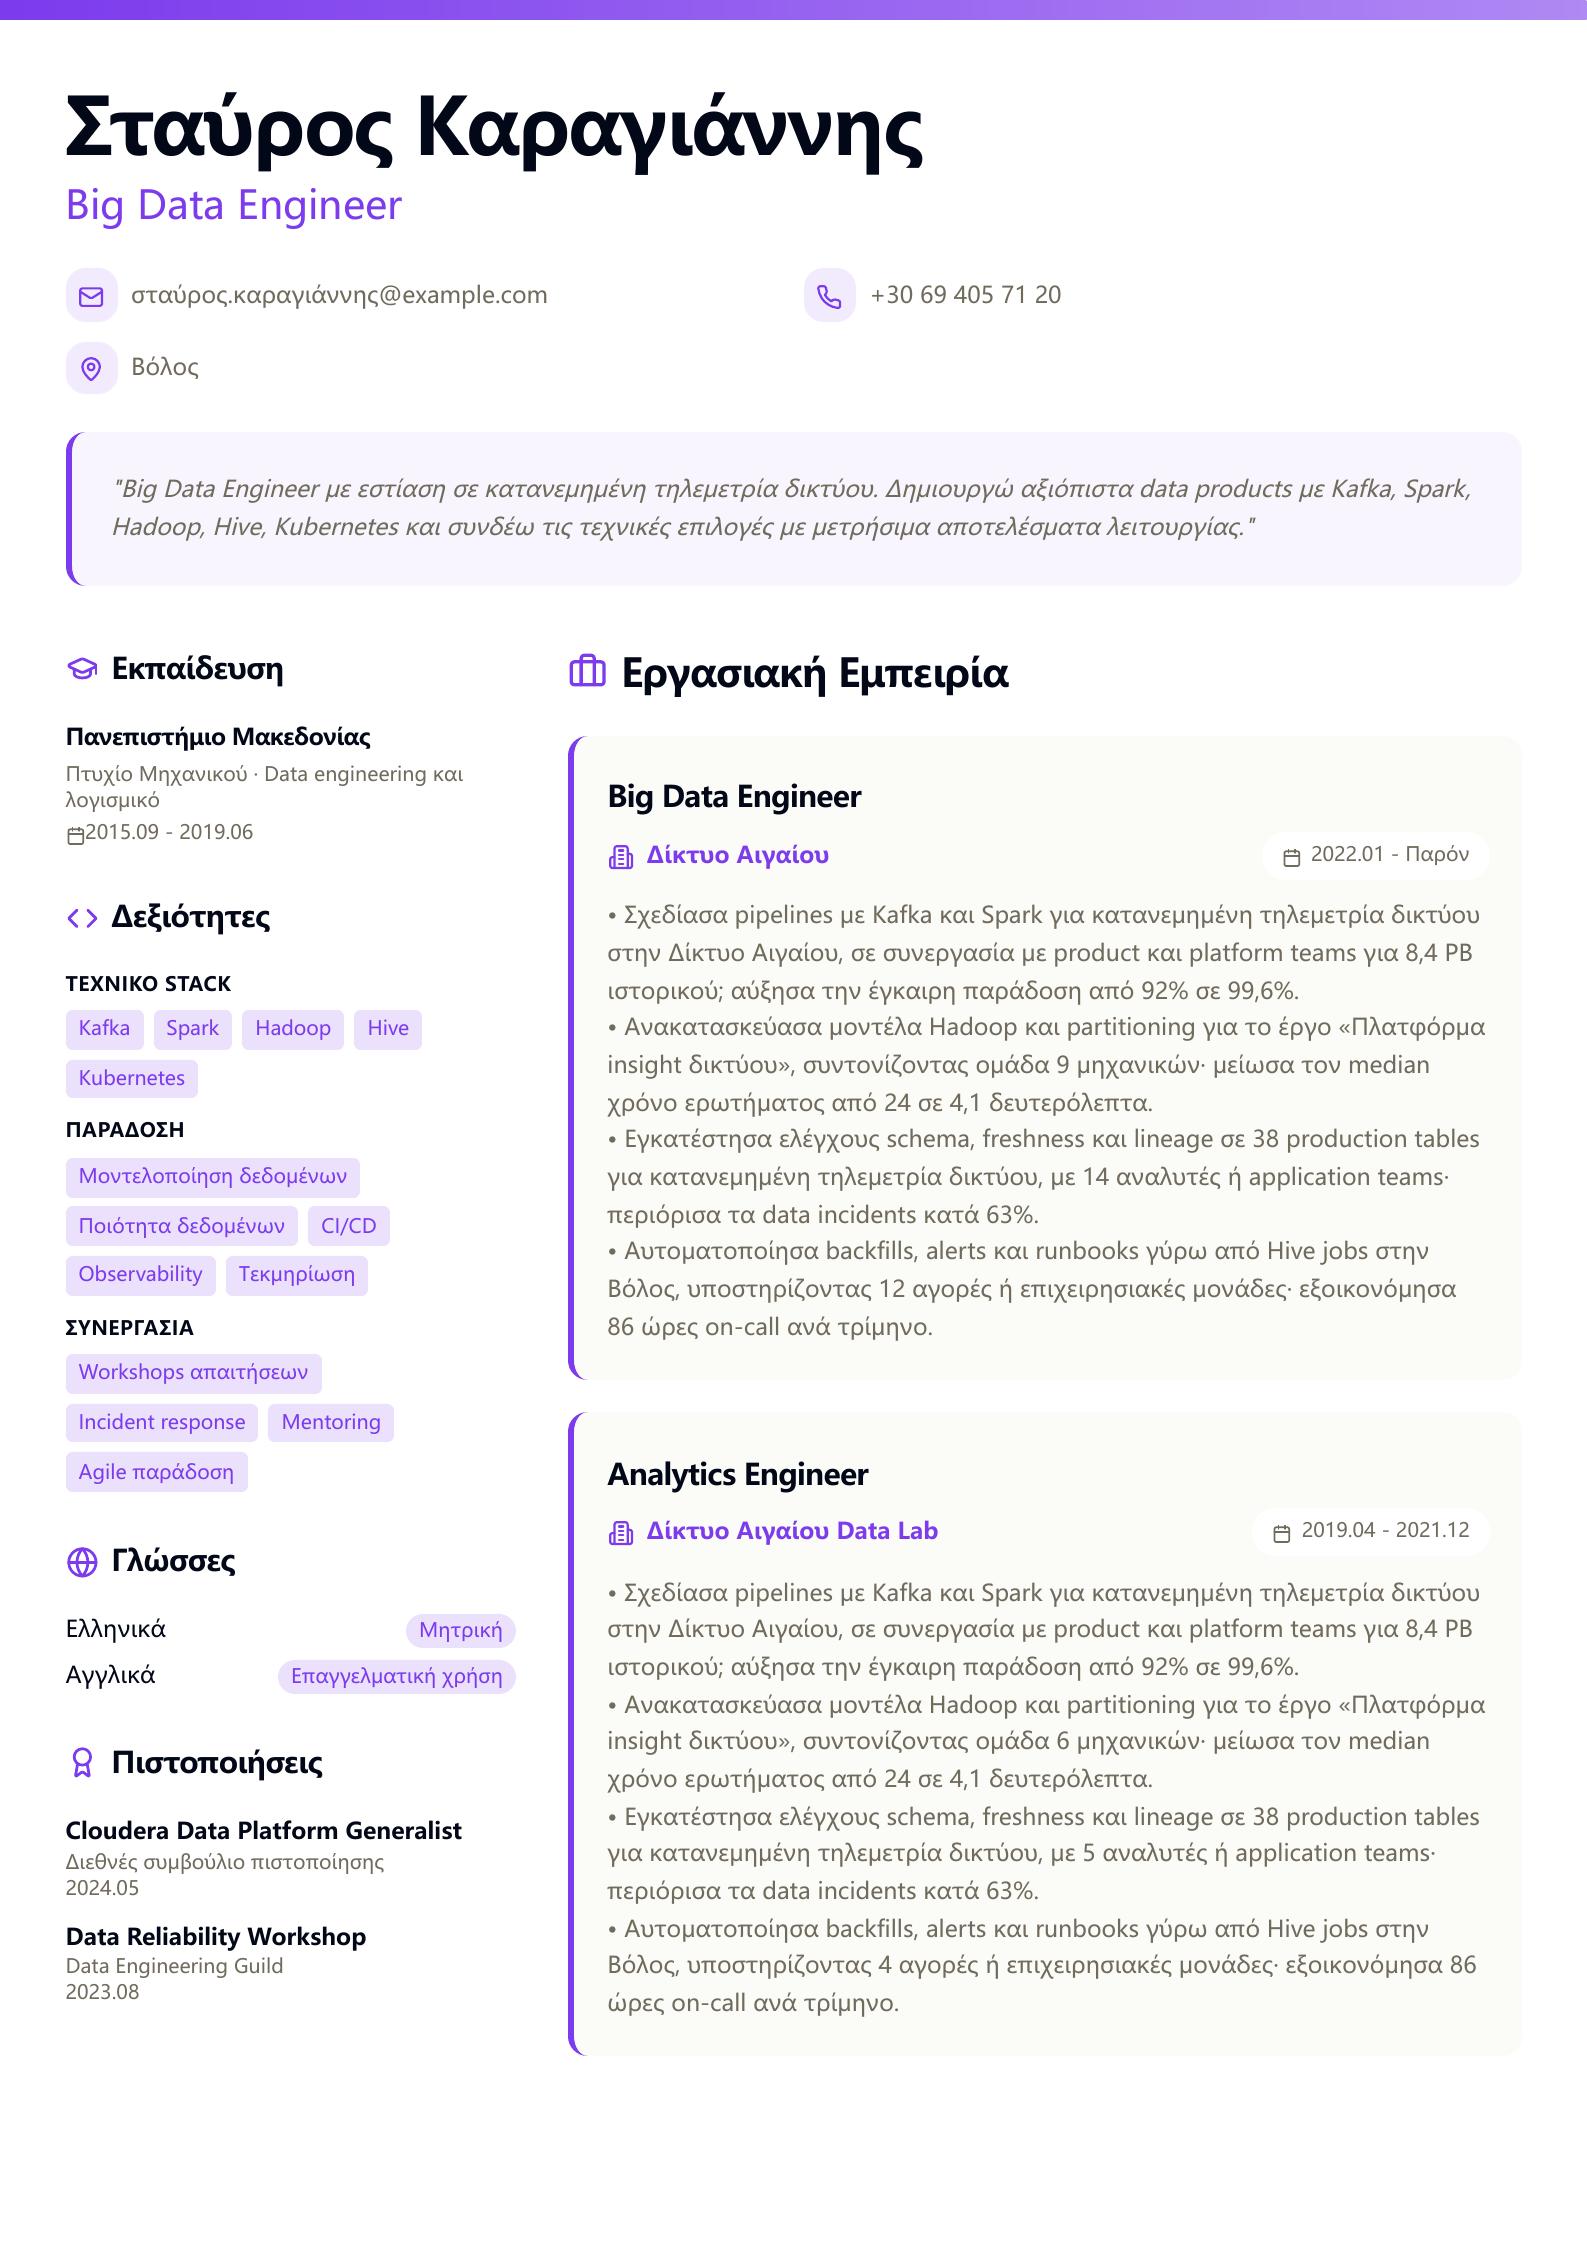
Πρωτότυπο ελληνικό παράδειγμα Big Data Engineer με pipelines παραγωγής, συνεργασία μεταξύ ομάδων και μετρήσιμες βελτιώσεις.
Ταιριάζει σε: Για υποψηφίους που διεκδικούν ρόλους Data Center Engineer.
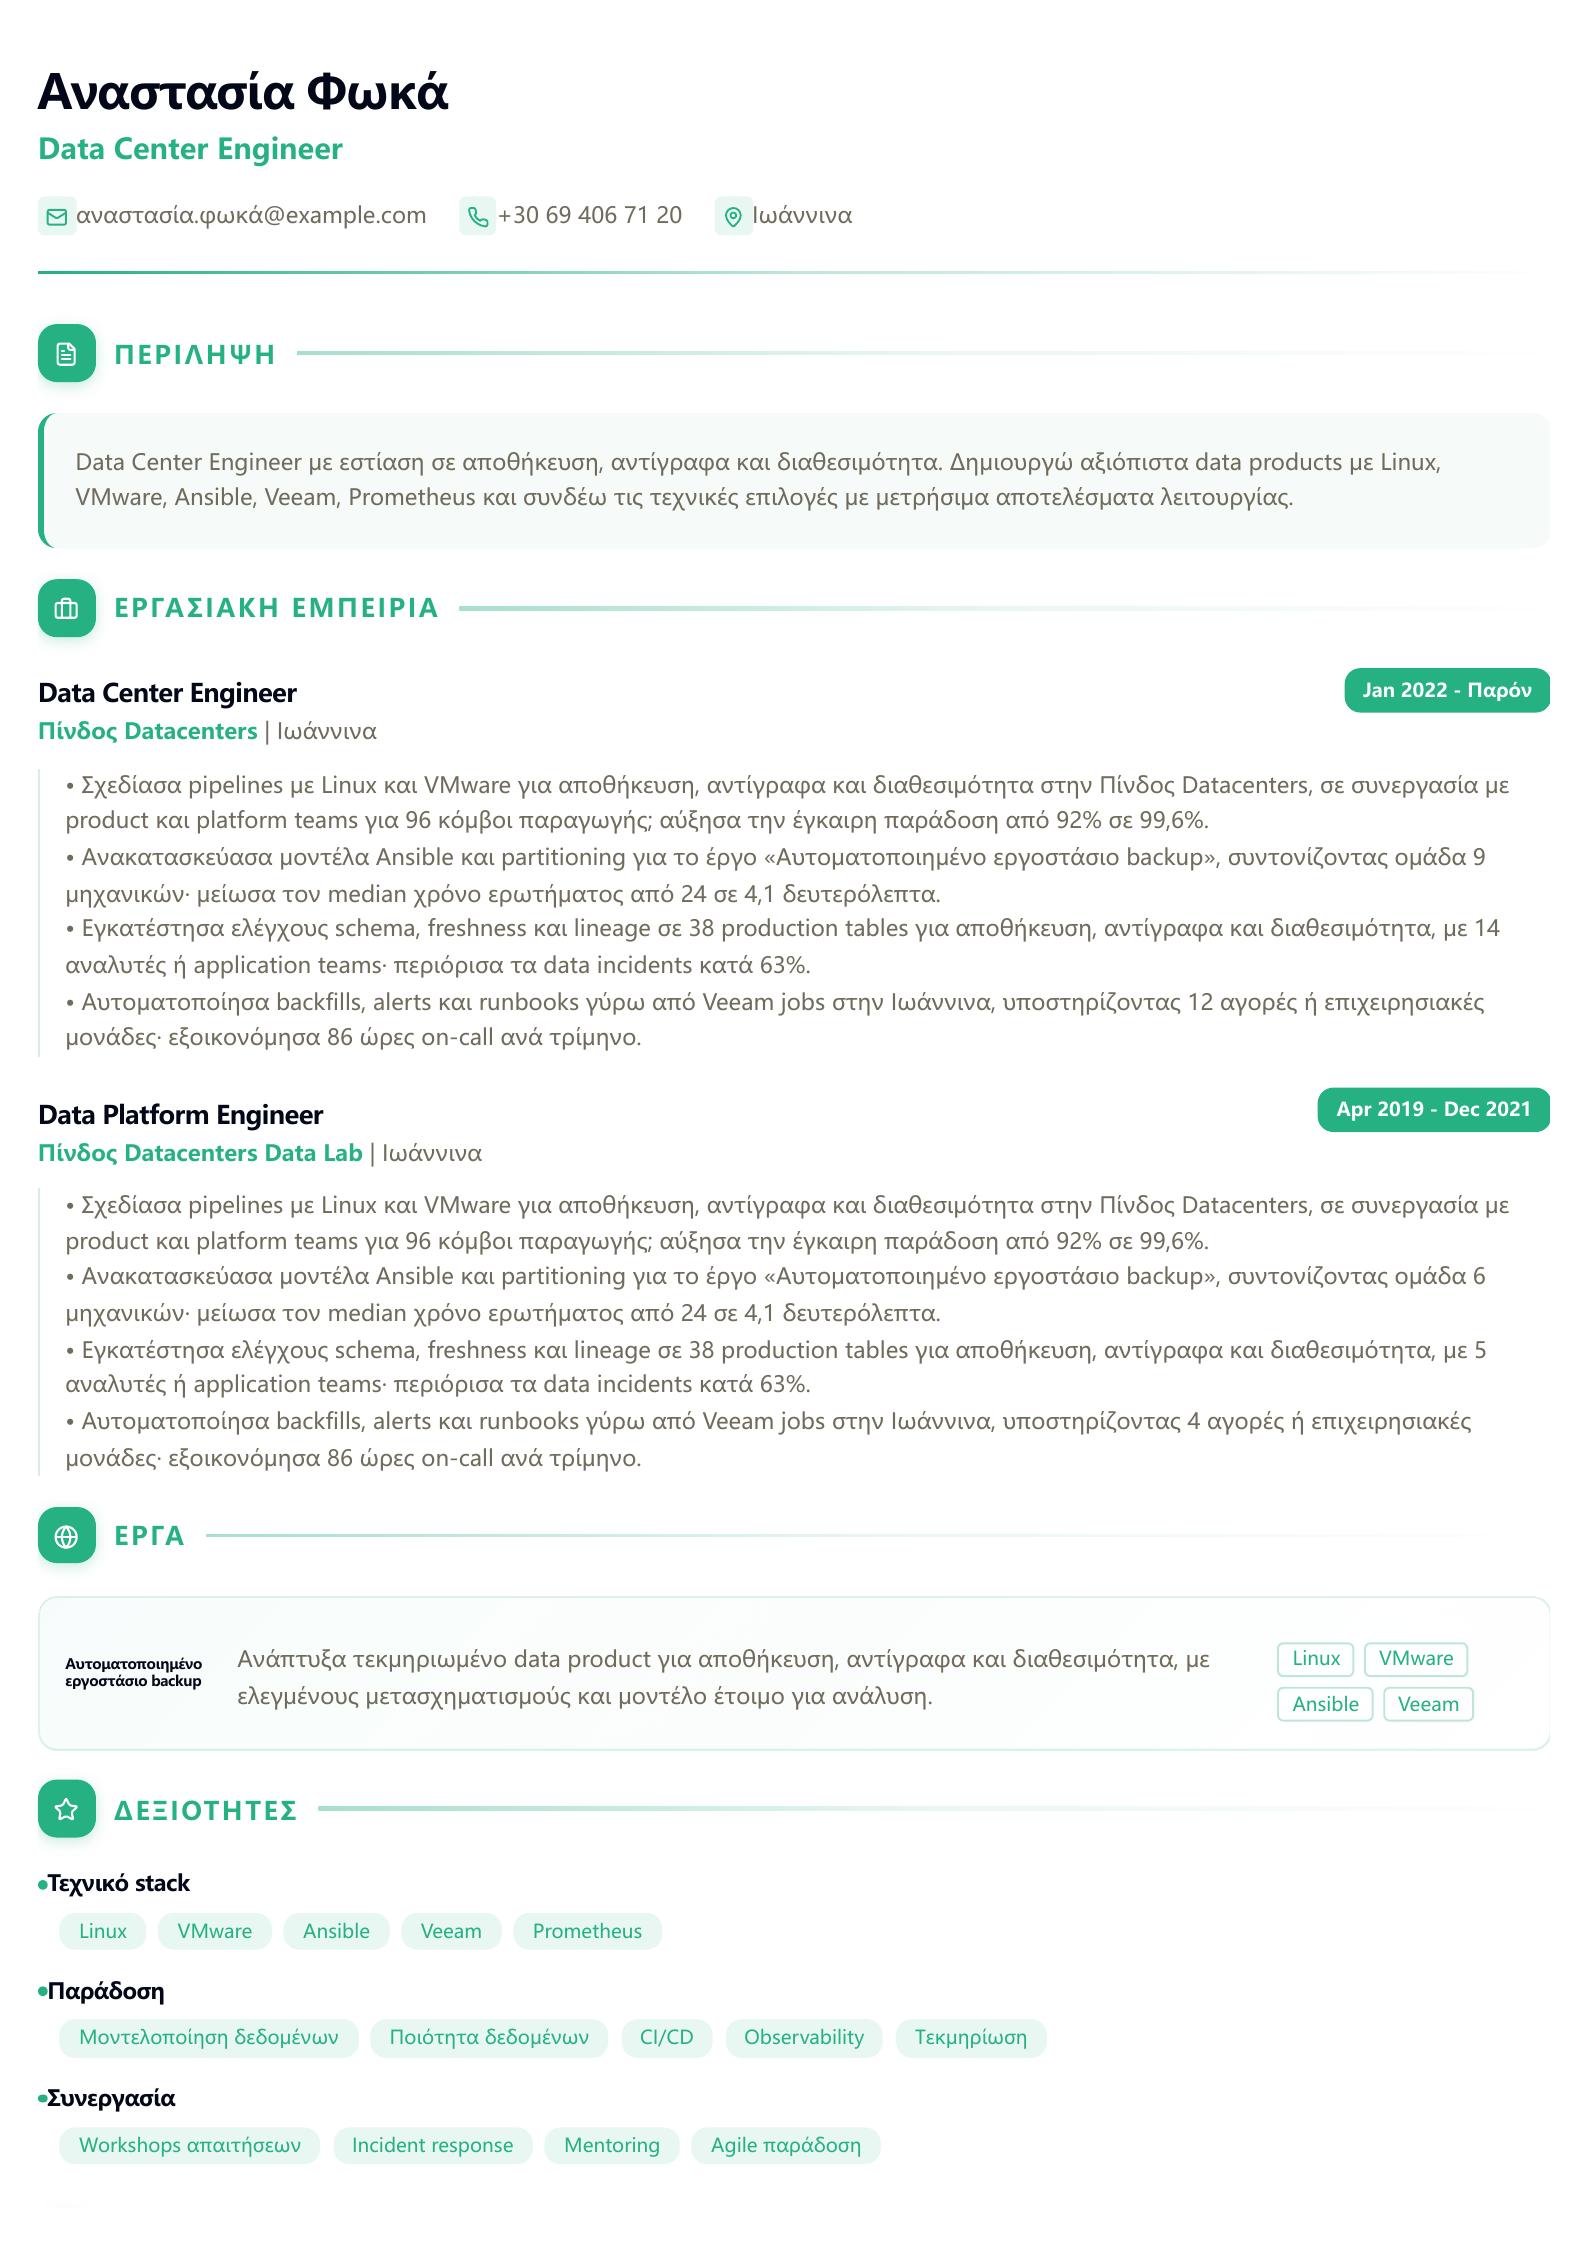
Πρωτότυπο ελληνικό παράδειγμα Data Center Engineer με pipelines παραγωγής, συνεργασία μεταξύ ομάδων και μετρήσιμες βελτιώσεις.
Ταιριάζει σε: Για υποψηφίους που διεκδικούν ρόλους Databricks Data Engineer.
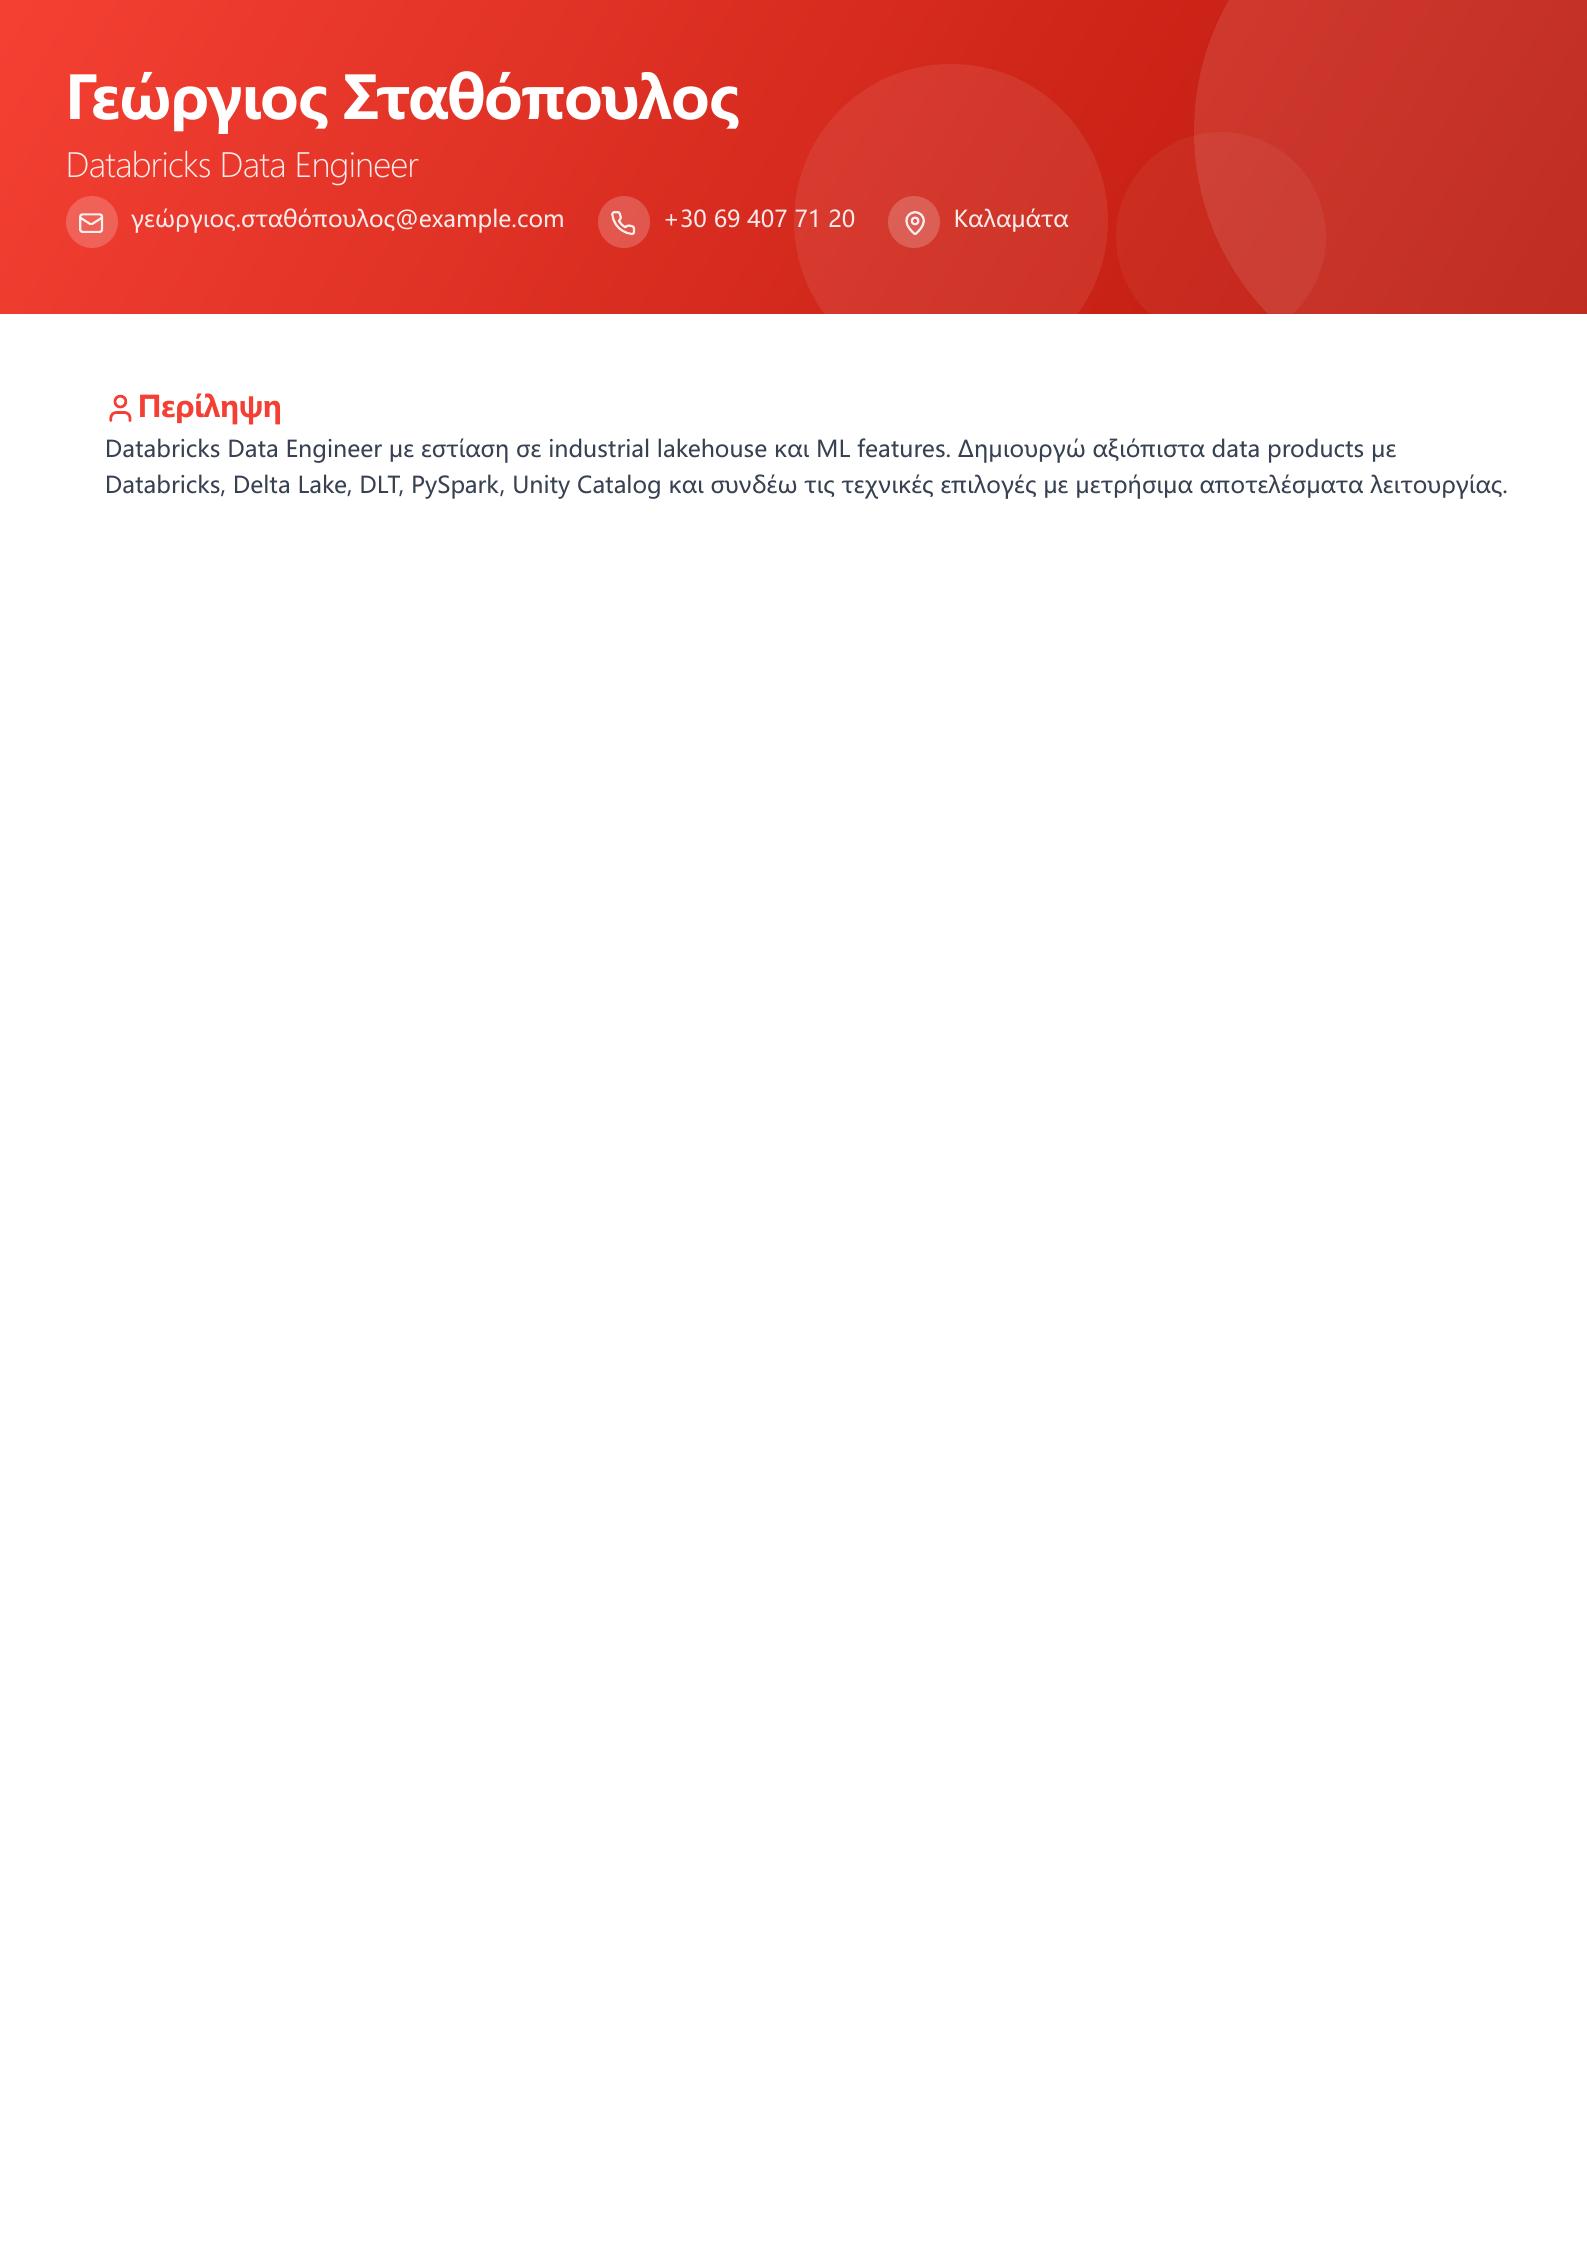
Πρωτότυπο ελληνικό παράδειγμα Databricks Data Engineer με pipelines παραγωγής, συνεργασία μεταξύ ομάδων και μετρήσιμες βελτιώσεις.
Ταιριάζει σε: Για υποψηφίους που διεκδικούν ρόλους Data Engineer Intern.
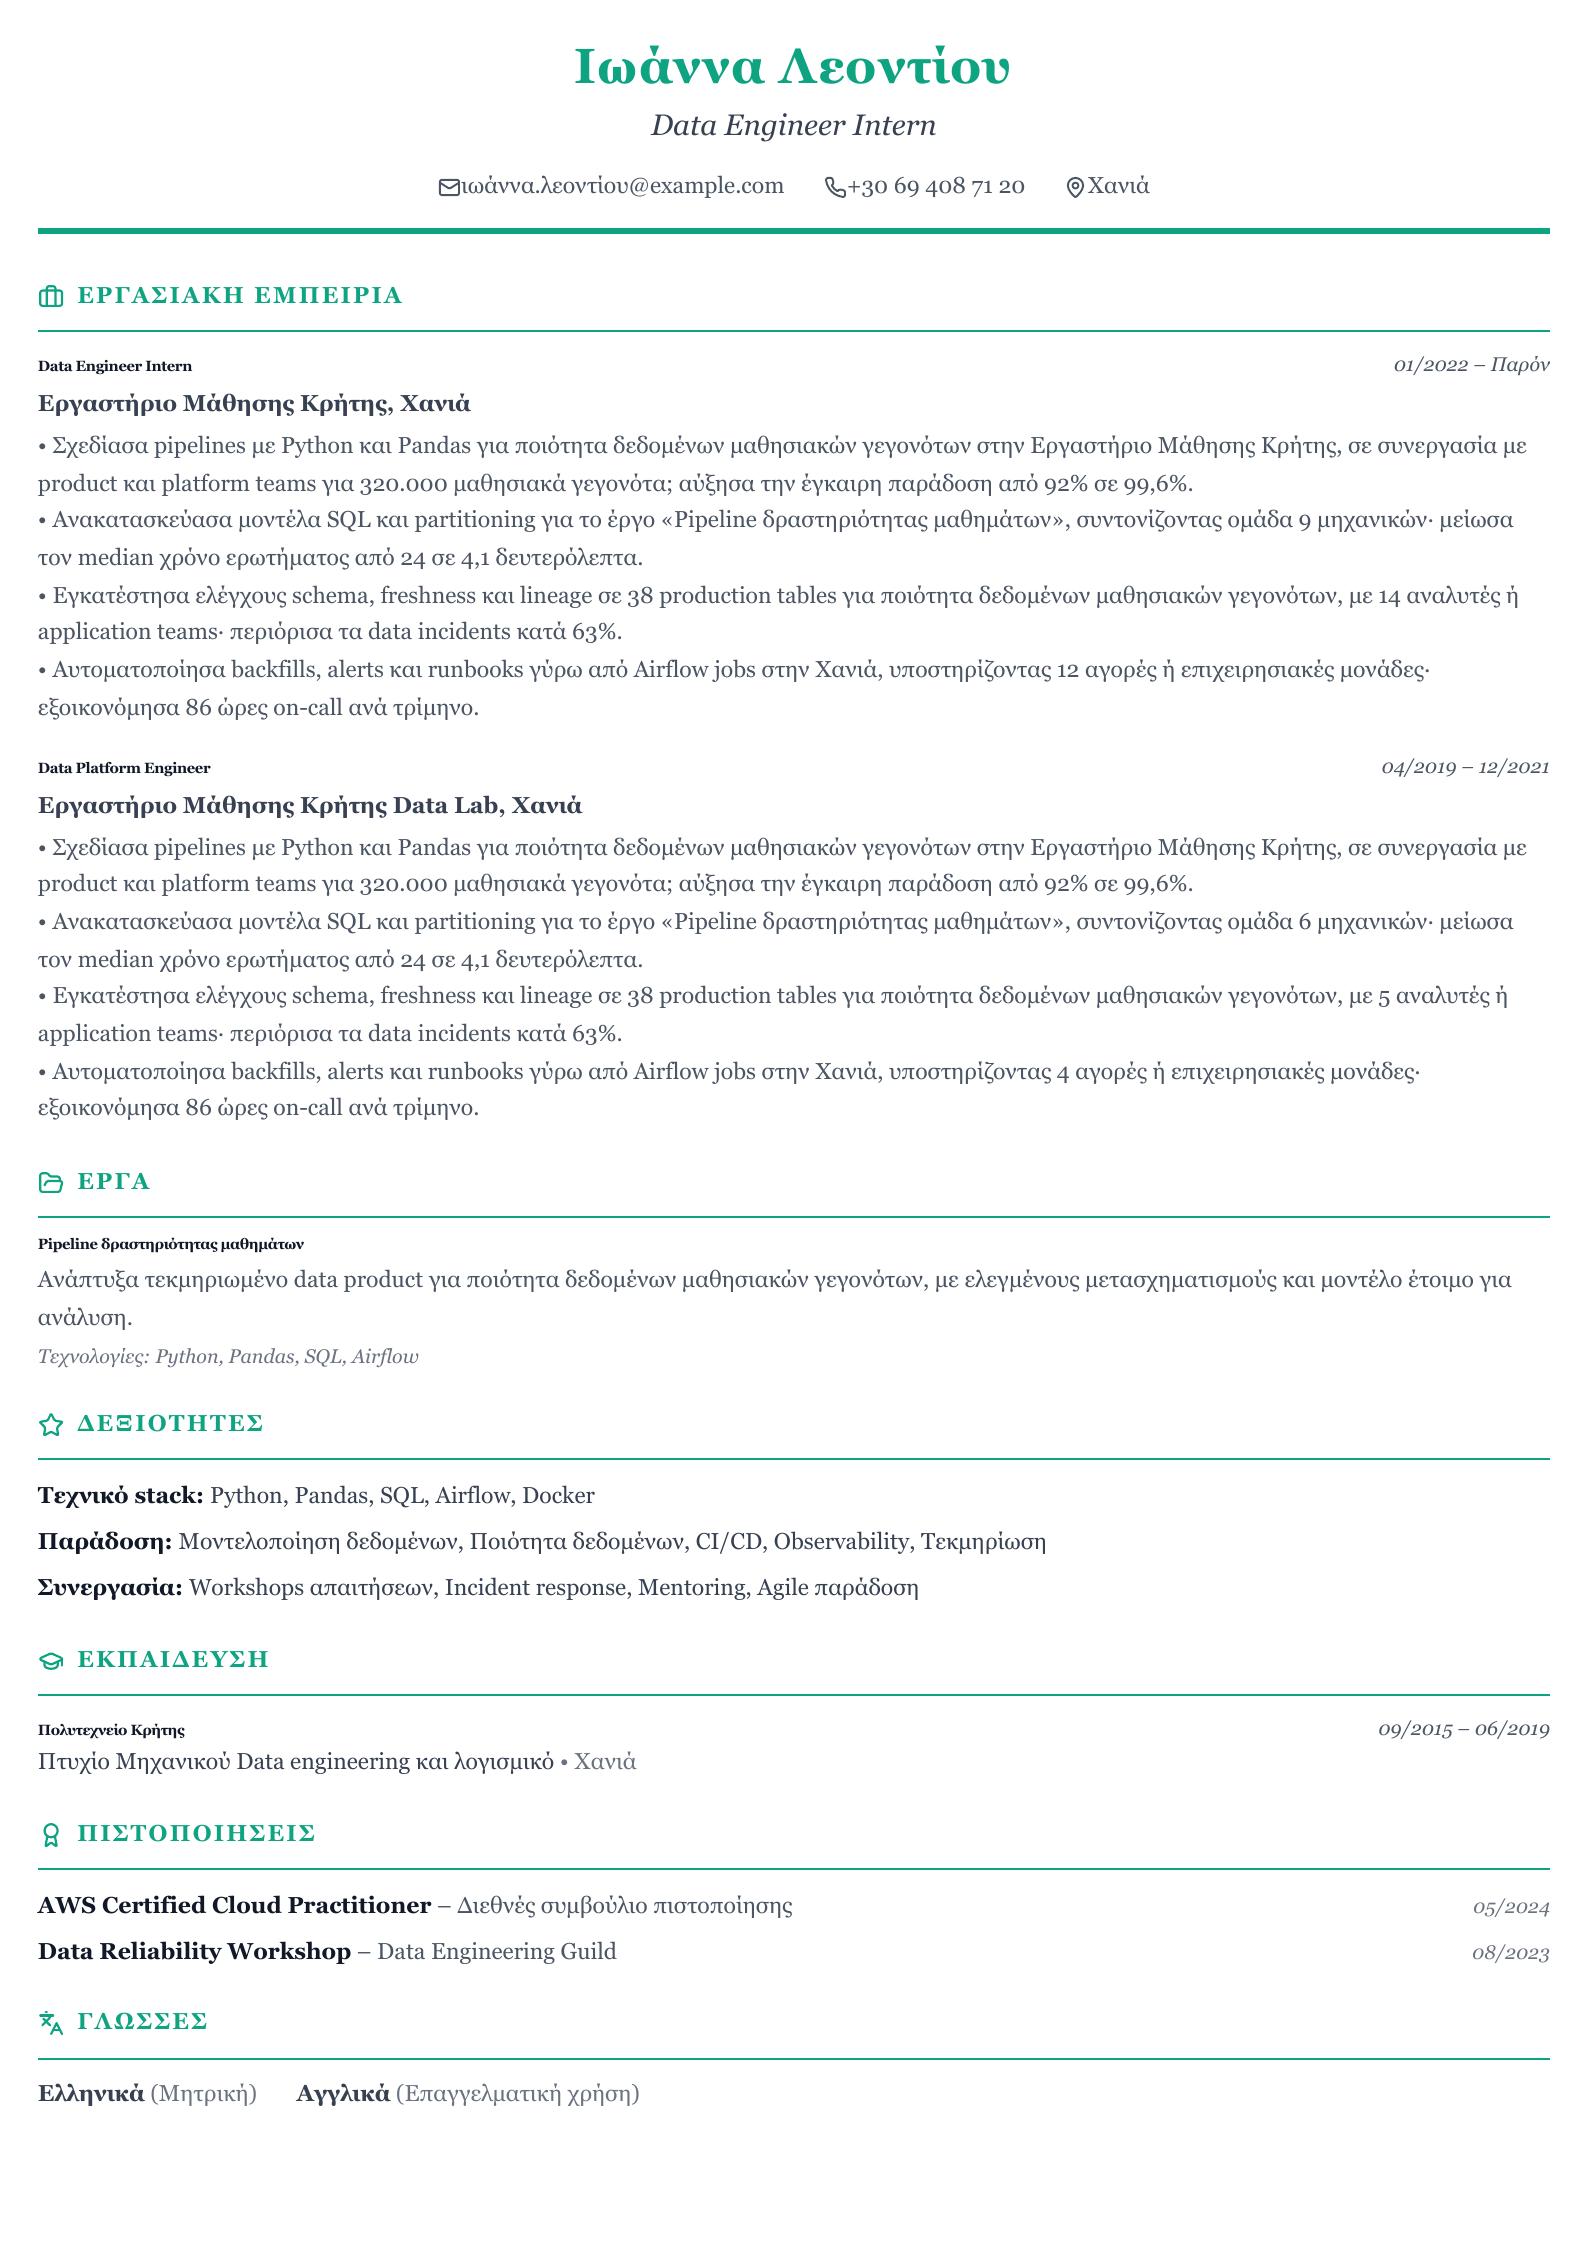
Πρωτότυπο ελληνικό παράδειγμα Data Engineer Intern με pipelines παραγωγής, συνεργασία μεταξύ ομάδων και μετρήσιμες βελτιώσεις.
Ταιριάζει σε: Για υποψηφίους που διεκδικούν ρόλους Junior Data Engineer.
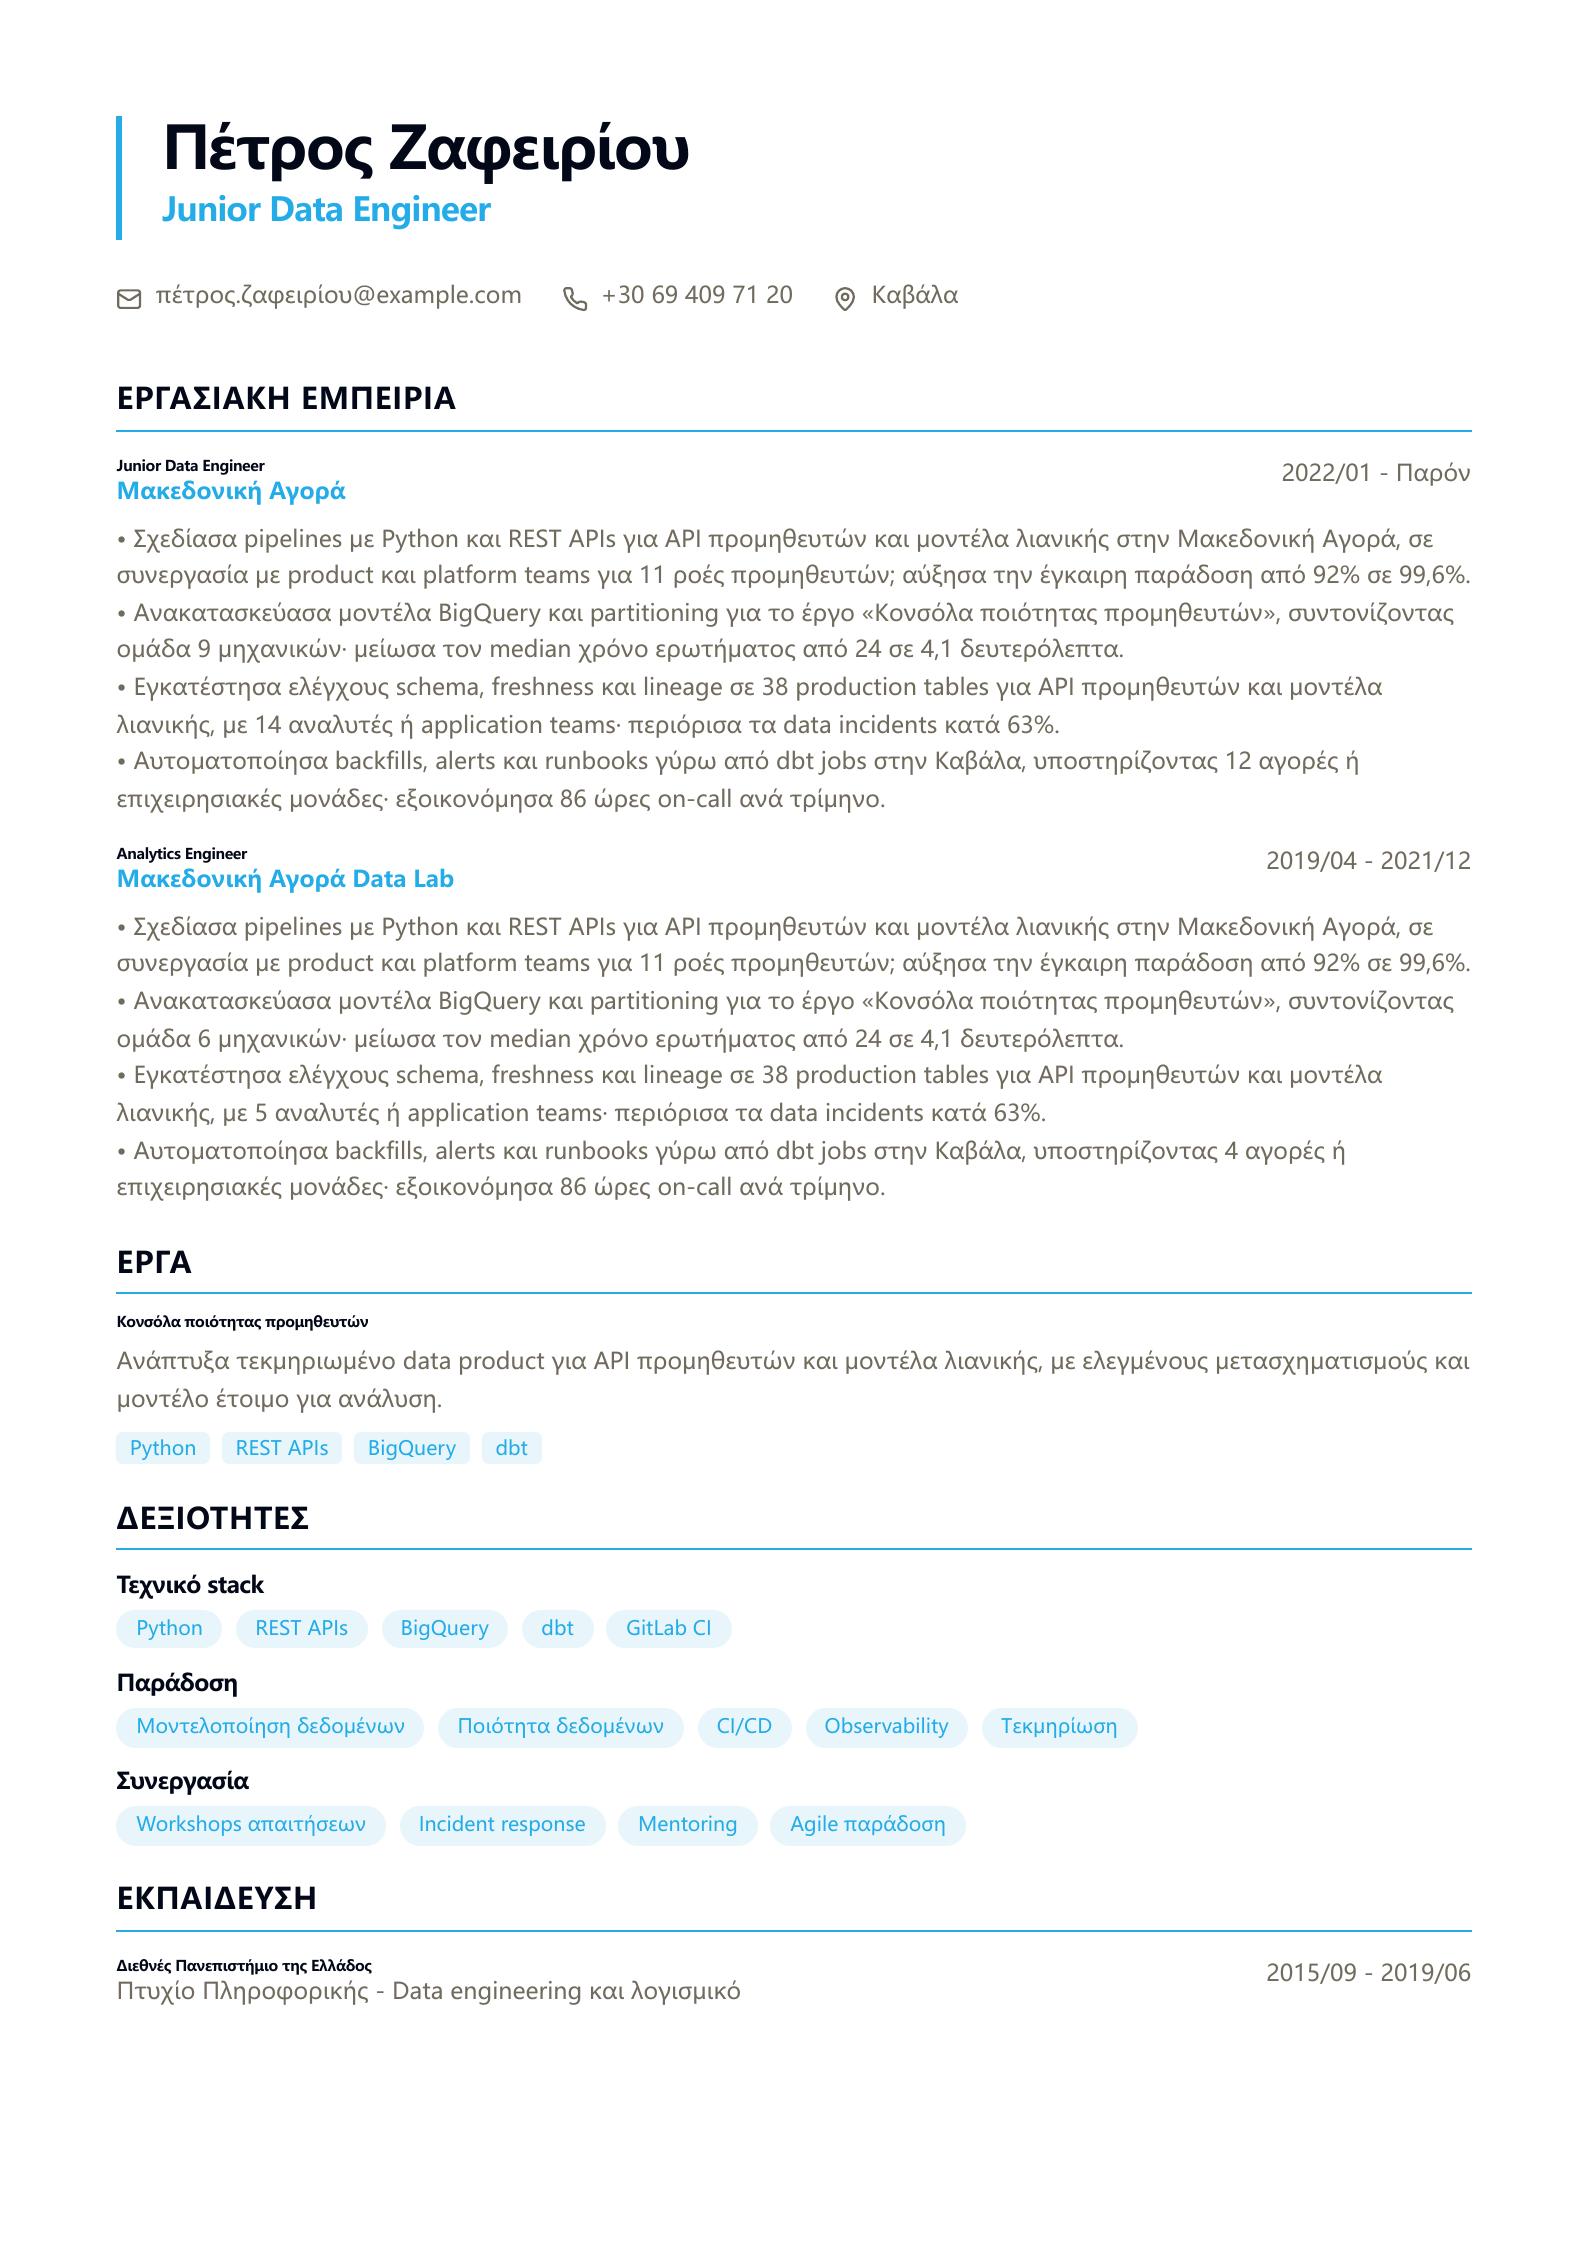
Πρωτότυπο ελληνικό παράδειγμα Junior Data Engineer με pipelines παραγωγής, συνεργασία μεταξύ ομάδων και μετρήσιμες βελτιώσεις.
Ταιριάζει σε: Για υποψηφίους που διεκδικούν ρόλους Senior Data Engineer.
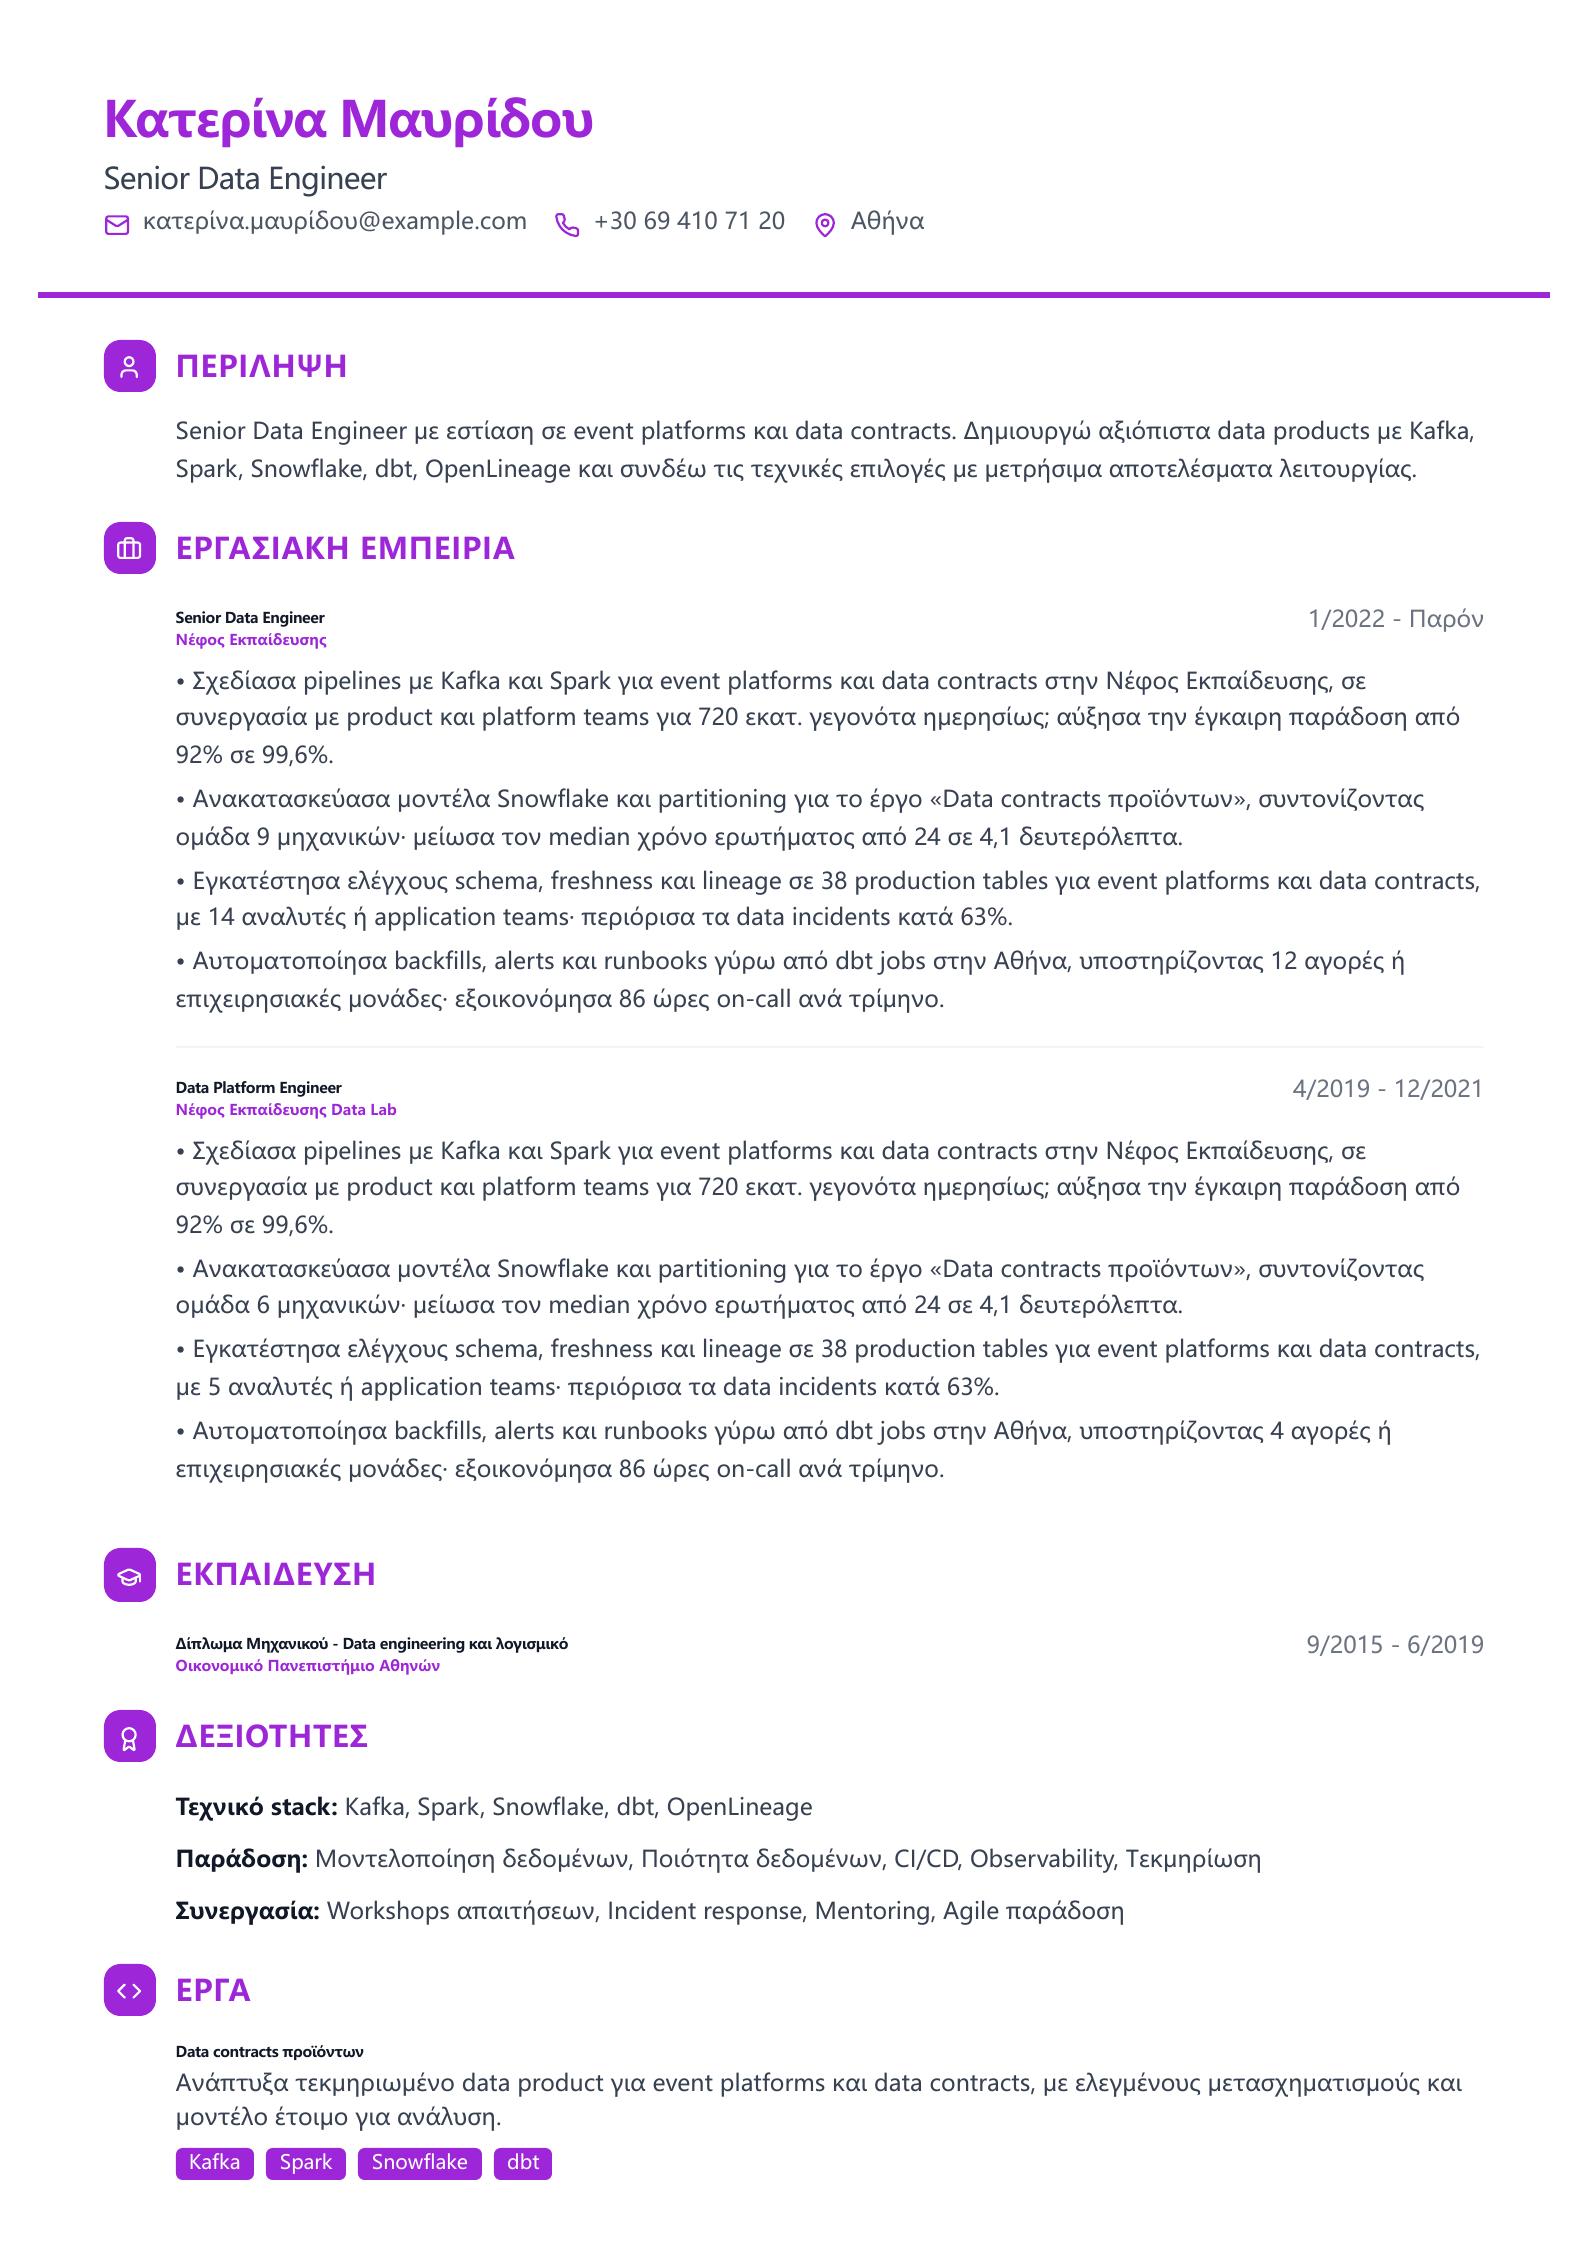
Πρωτότυπο ελληνικό παράδειγμα Senior Data Engineer με pipelines παραγωγής, συνεργασία μεταξύ ομάδων και μετρήσιμες βελτιώσεις.
Ταιριάζει σε: Για υποψηφίους που διεκδικούν ρόλους Principal Data Engineer.
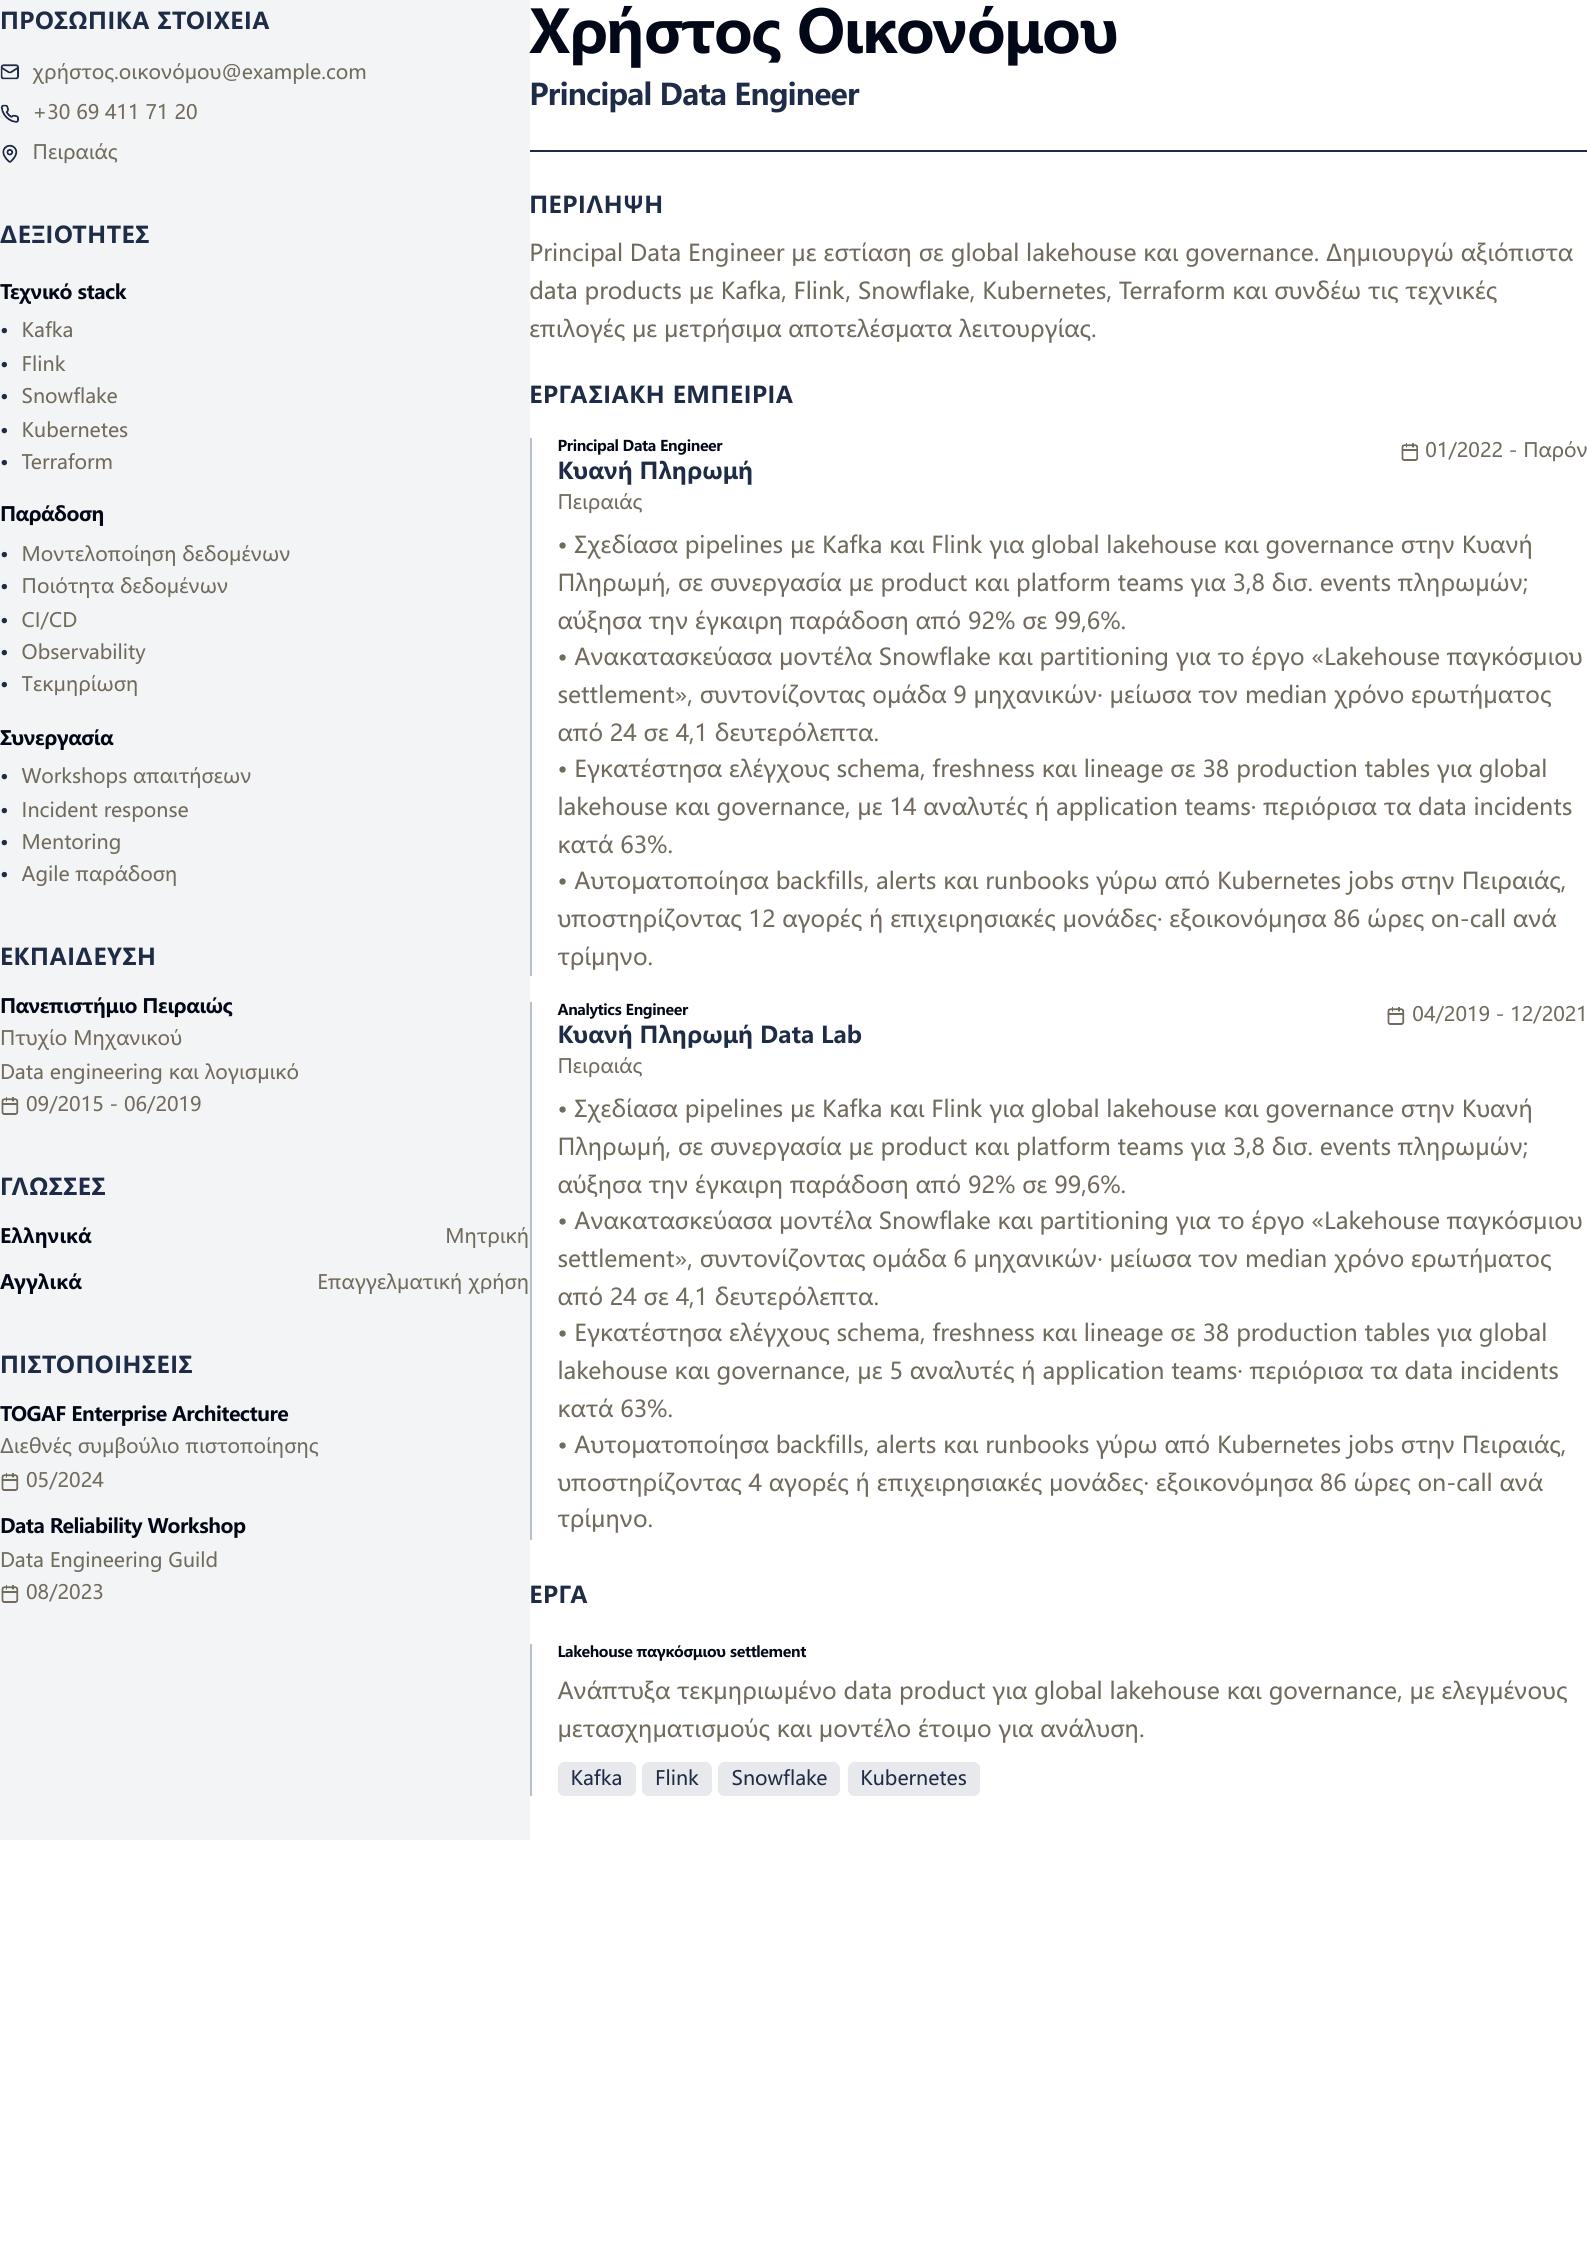
Πρωτότυπο ελληνικό παράδειγμα Principal Data Engineer με pipelines παραγωγής, συνεργασία μεταξύ ομάδων και μετρήσιμες βελτιώσεις.
Ταιριάζει σε: Για υποψηφίους που διεκδικούν ρόλους PySpark Data Engineer.
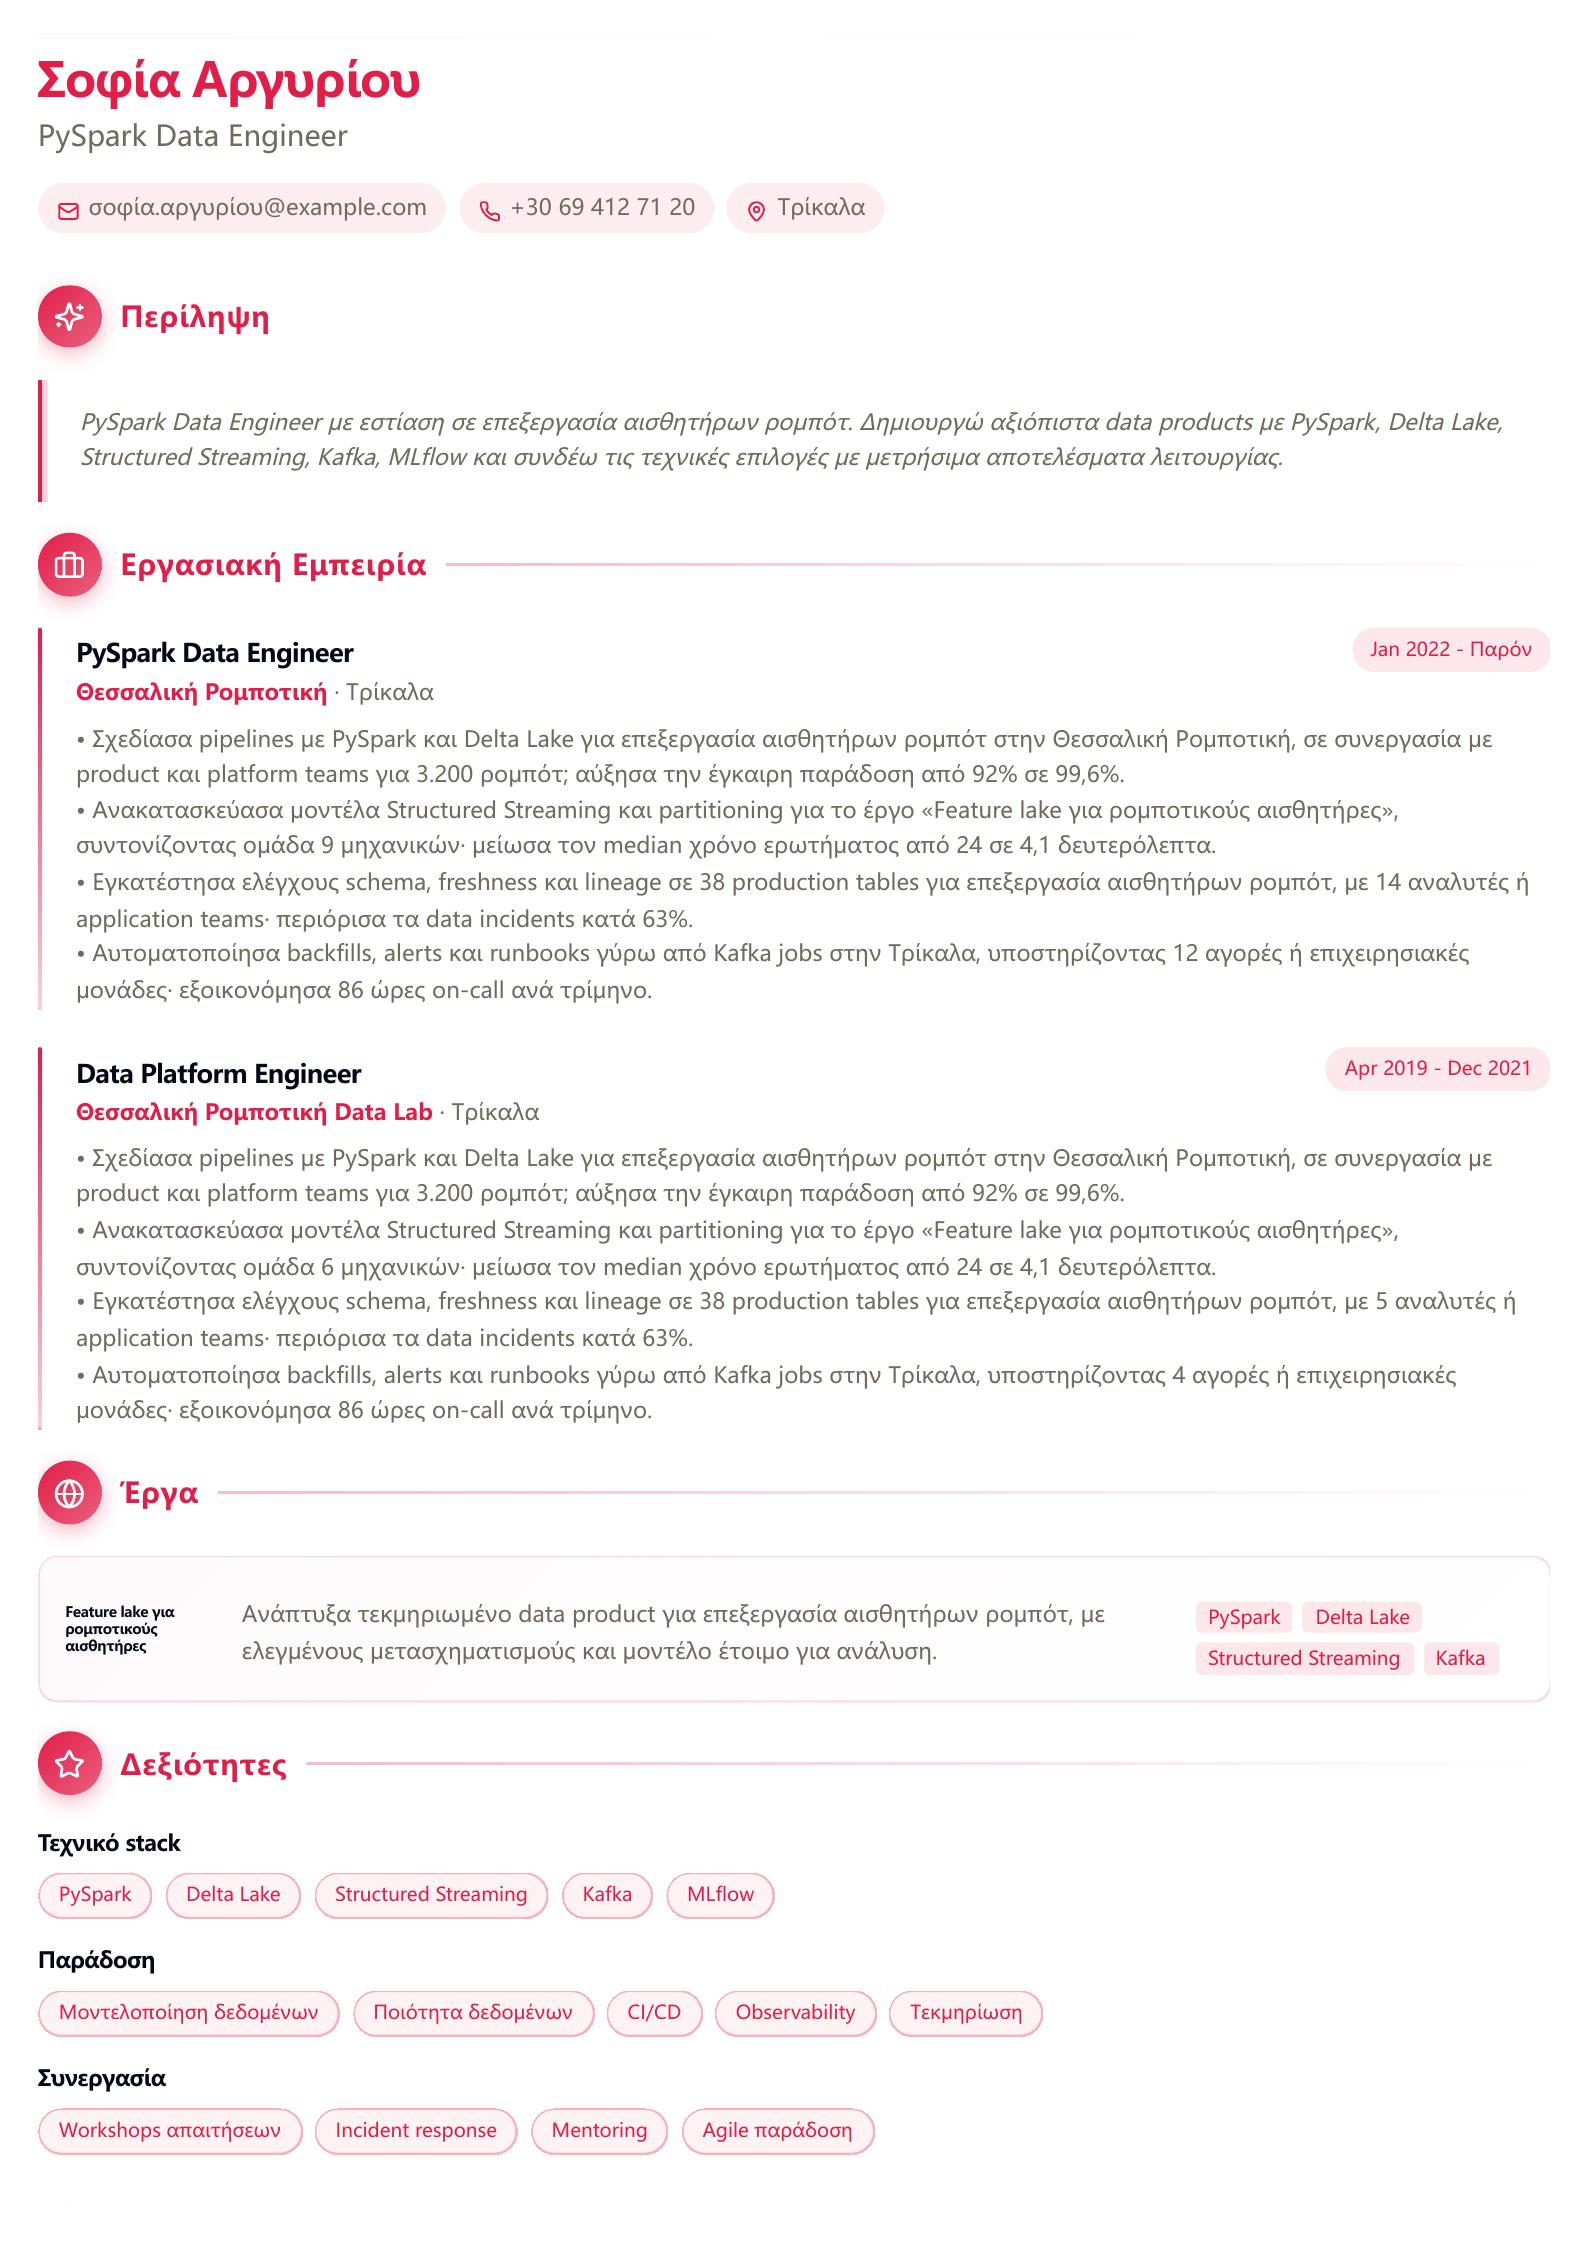
Πρωτότυπο ελληνικό παράδειγμα PySpark Data Engineer με pipelines παραγωγής, συνεργασία μεταξύ ομάδων και μετρήσιμες βελτιώσεις.
Ταιριάζει σε: Για υποψηφίους που διεκδικούν ρόλους Python Data Engineer.
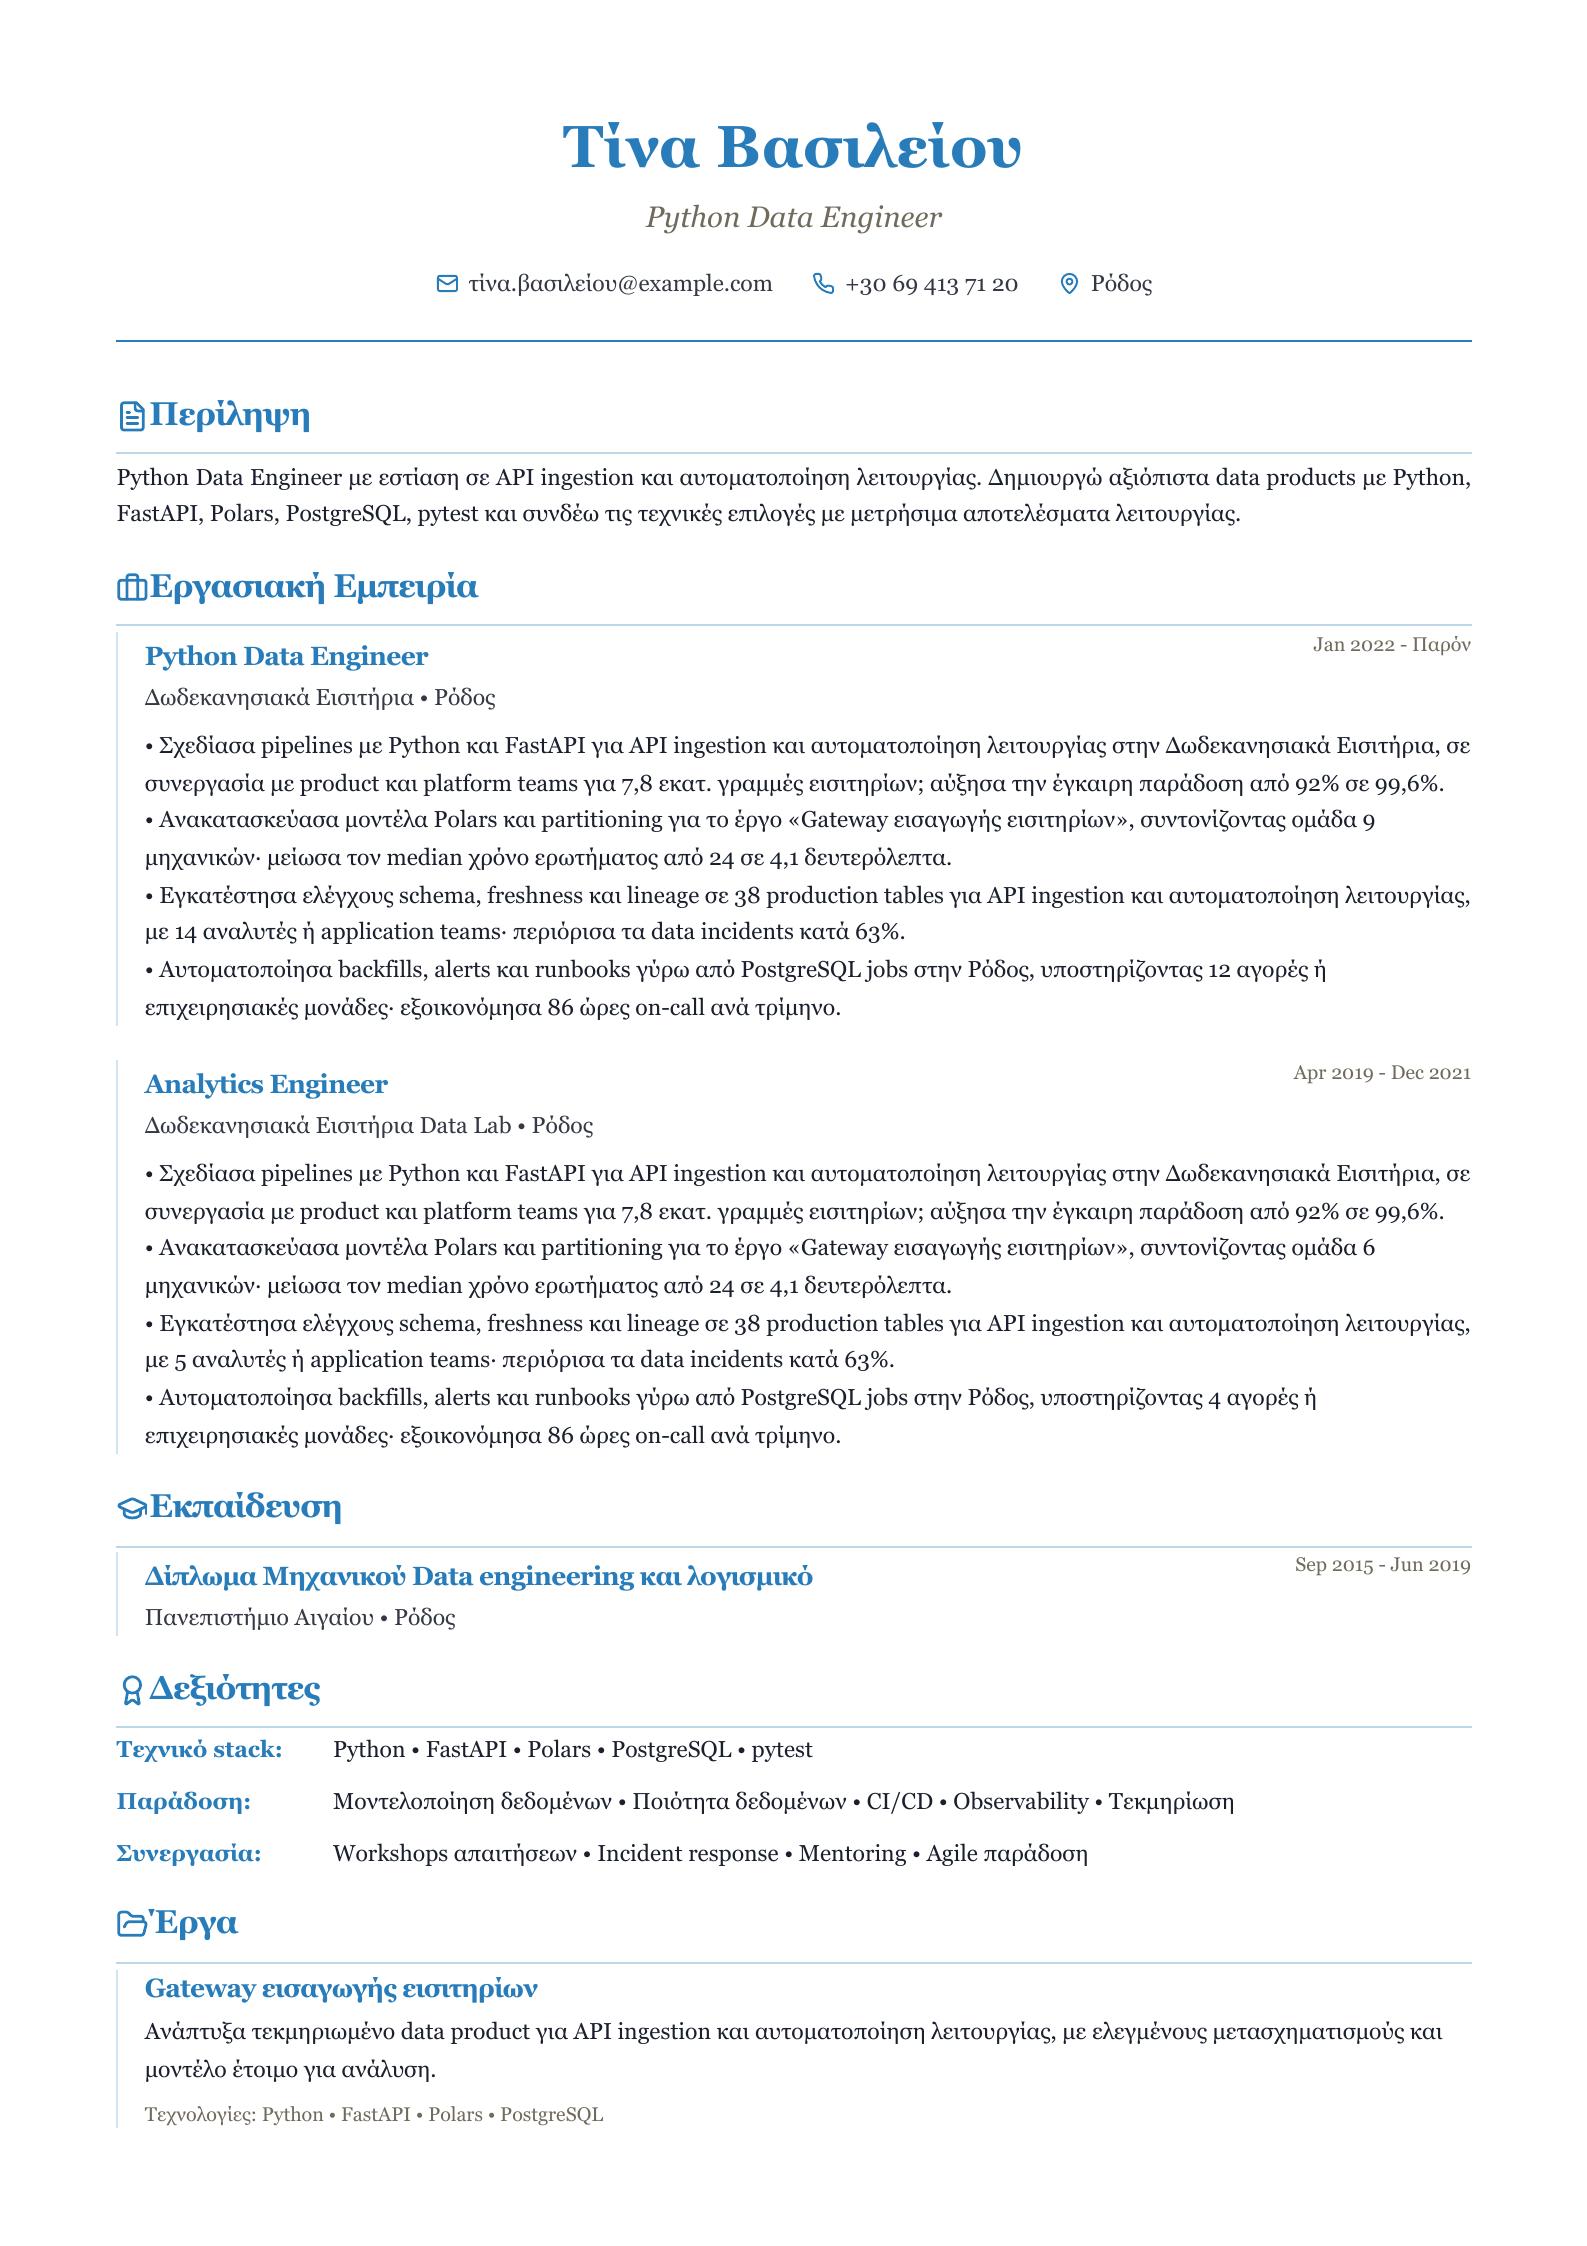
Πρωτότυπο ελληνικό παράδειγμα Python Data Engineer με pipelines παραγωγής, συνεργασία μεταξύ ομάδων και μετρήσιμες βελτιώσεις.
Ταιριάζει σε: Για υποψηφίους που διεκδικούν ρόλους Social Platform Data Engineer.
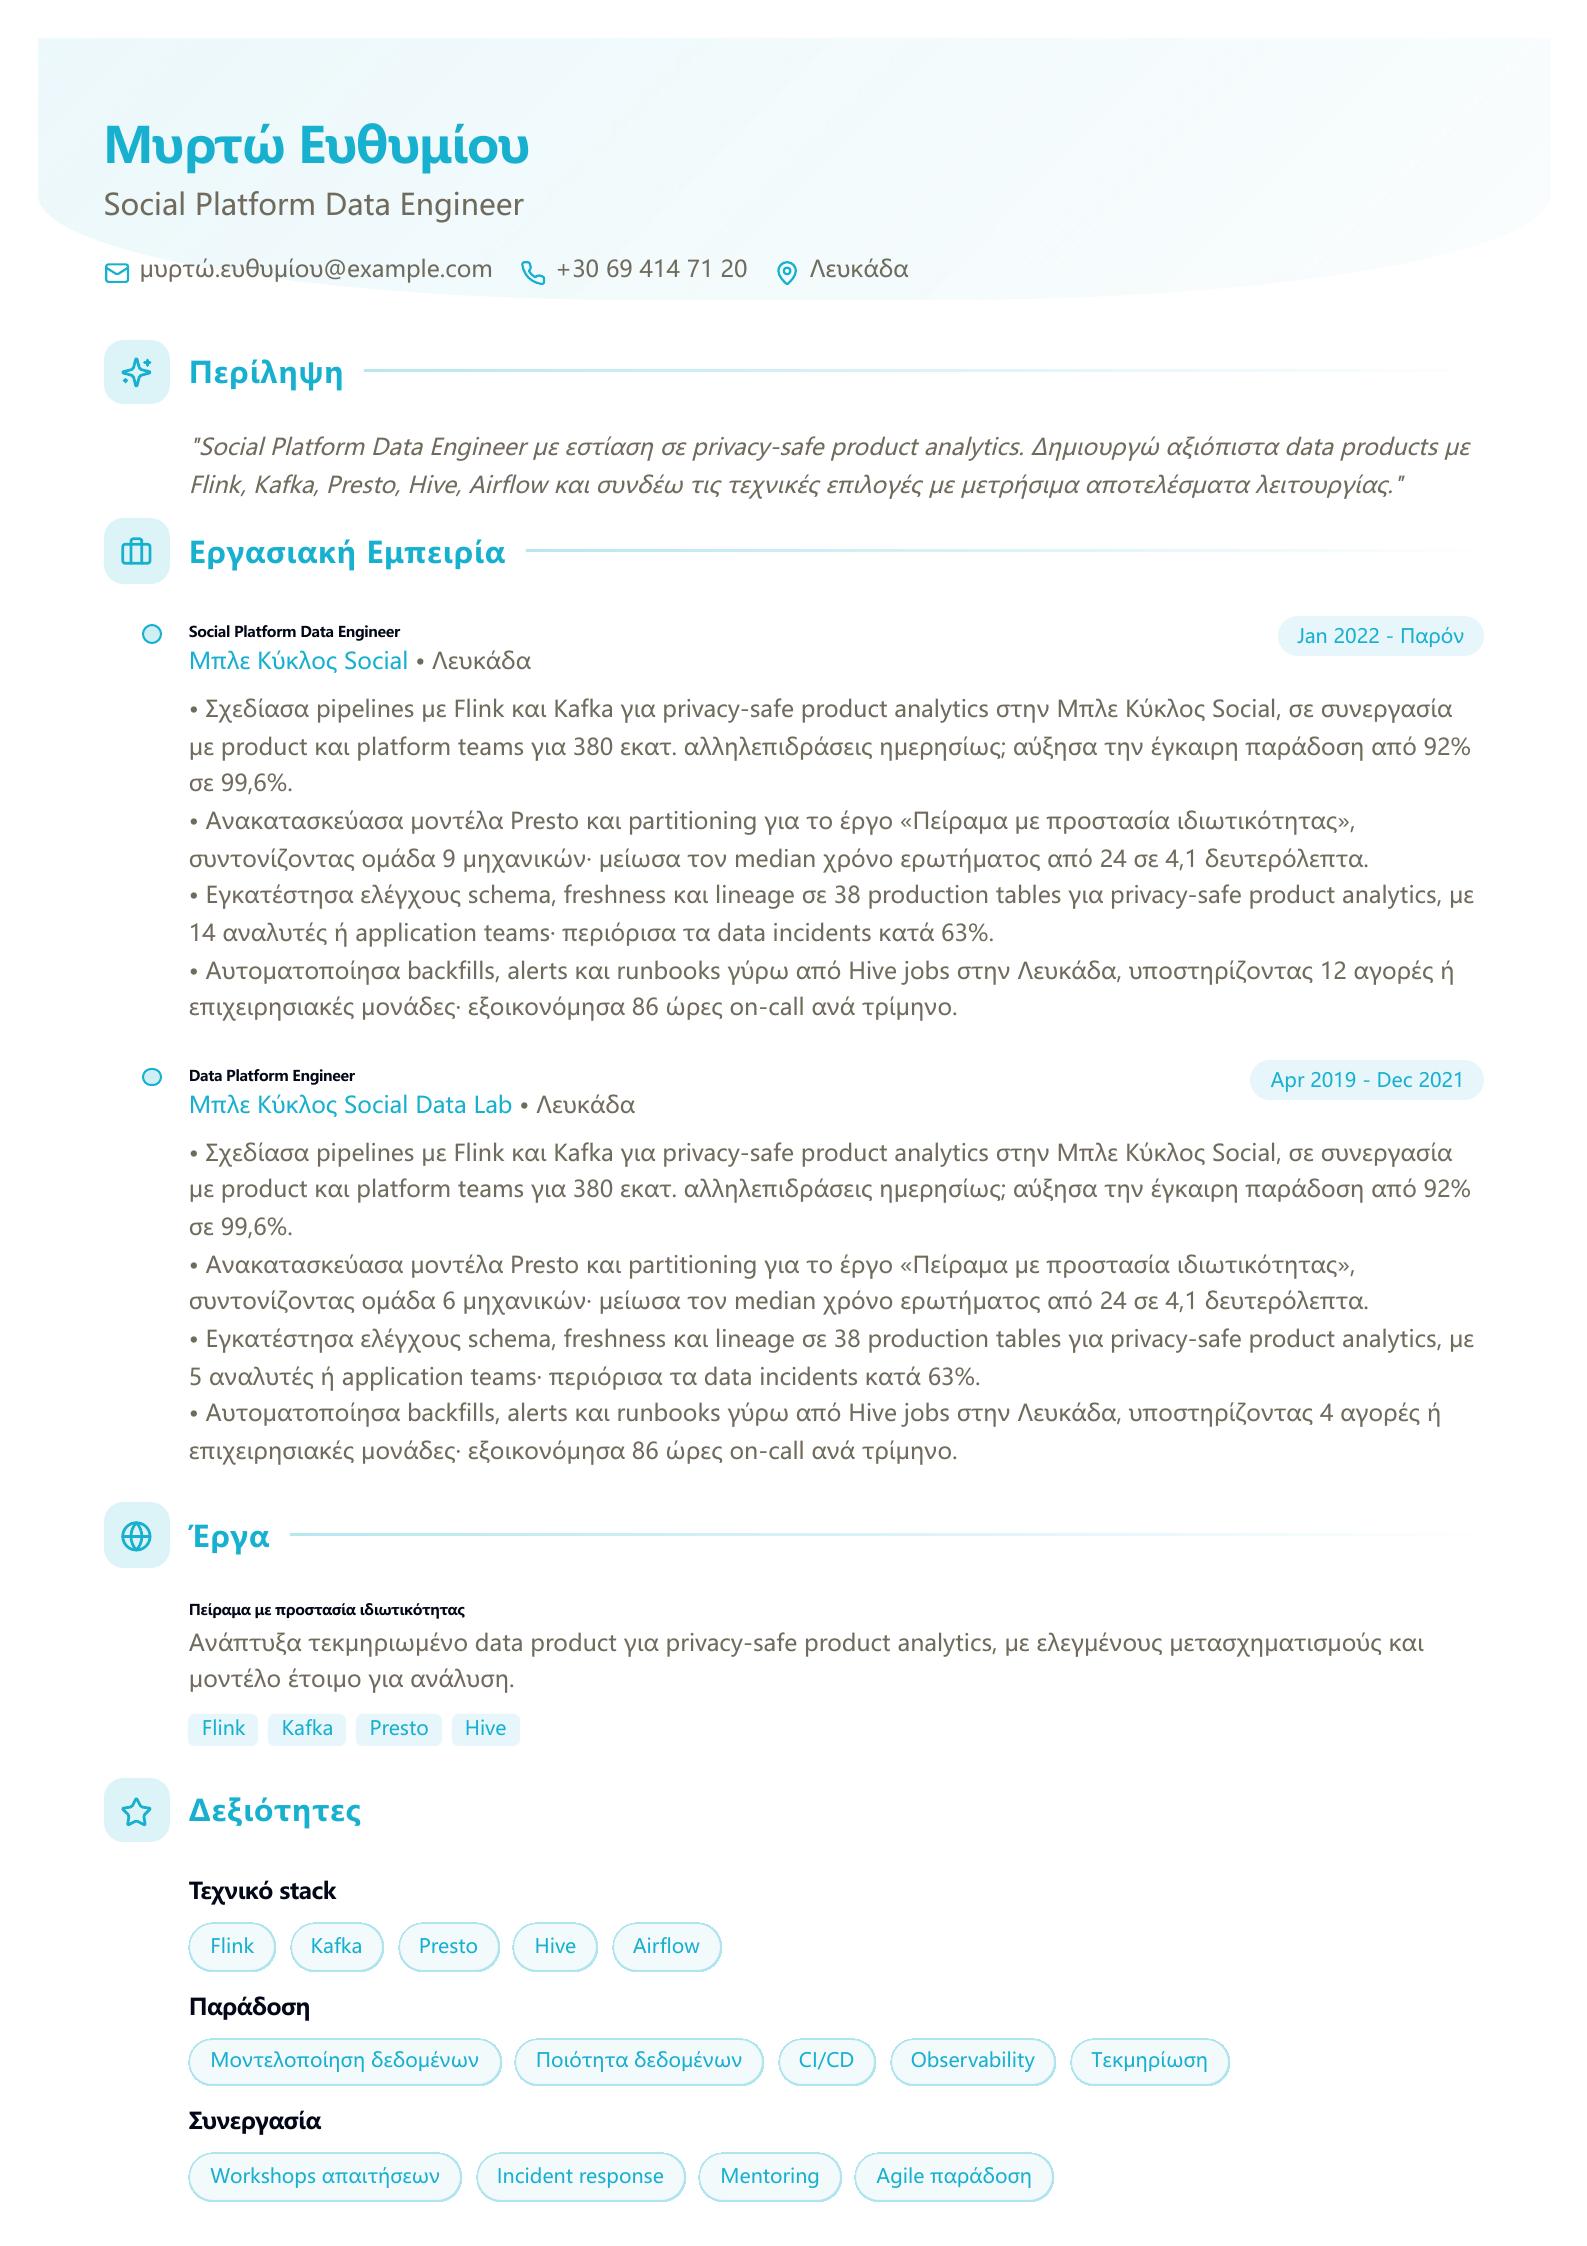
Πρωτότυπο ελληνικό παράδειγμα Social Platform Data Engineer με pipelines παραγωγής, συνεργασία μεταξύ ομάδων και μετρήσιμες βελτιώσεις.
Ταιριάζει σε: Για υποψηφίους που διεκδικούν ρόλους Data Analytics Engineer.
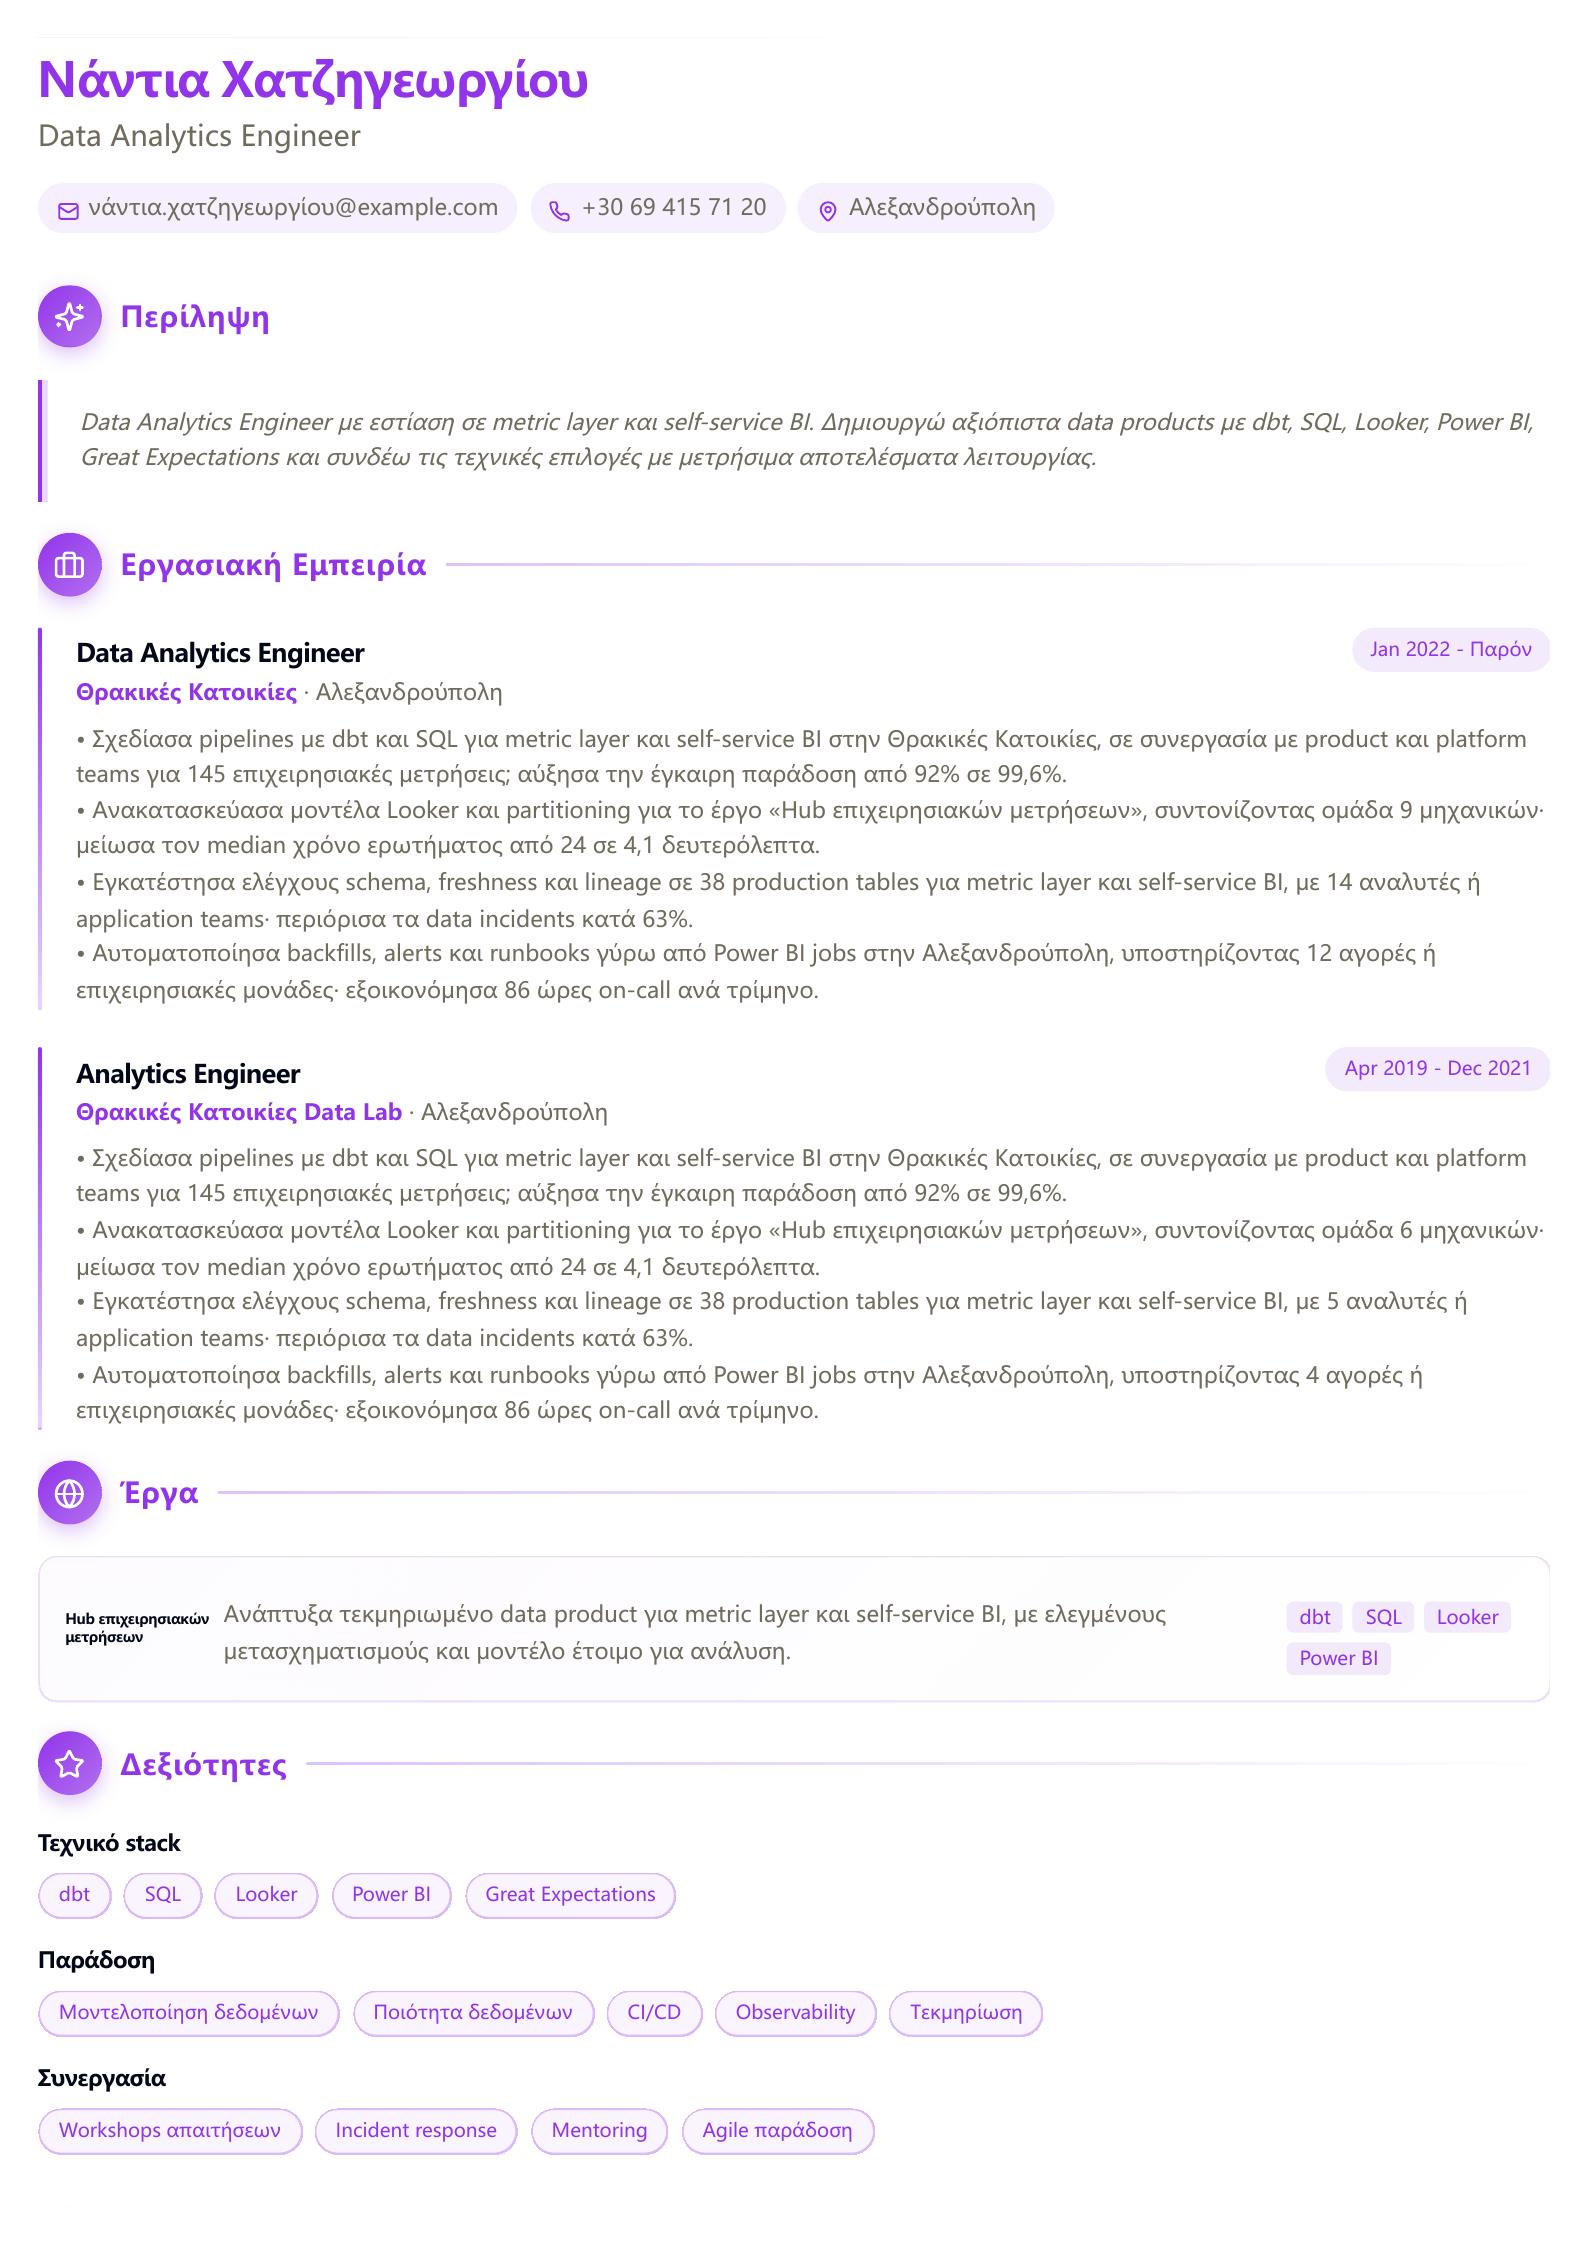
Πρωτότυπο ελληνικό παράδειγμα Data Analytics Engineer με pipelines παραγωγής, συνεργασία μεταξύ ομάδων και μετρήσιμες βελτιώσεις.
Ταιριάζει σε: Για υποψηφίους που διεκδικούν ρόλους ETL Data Engineer.
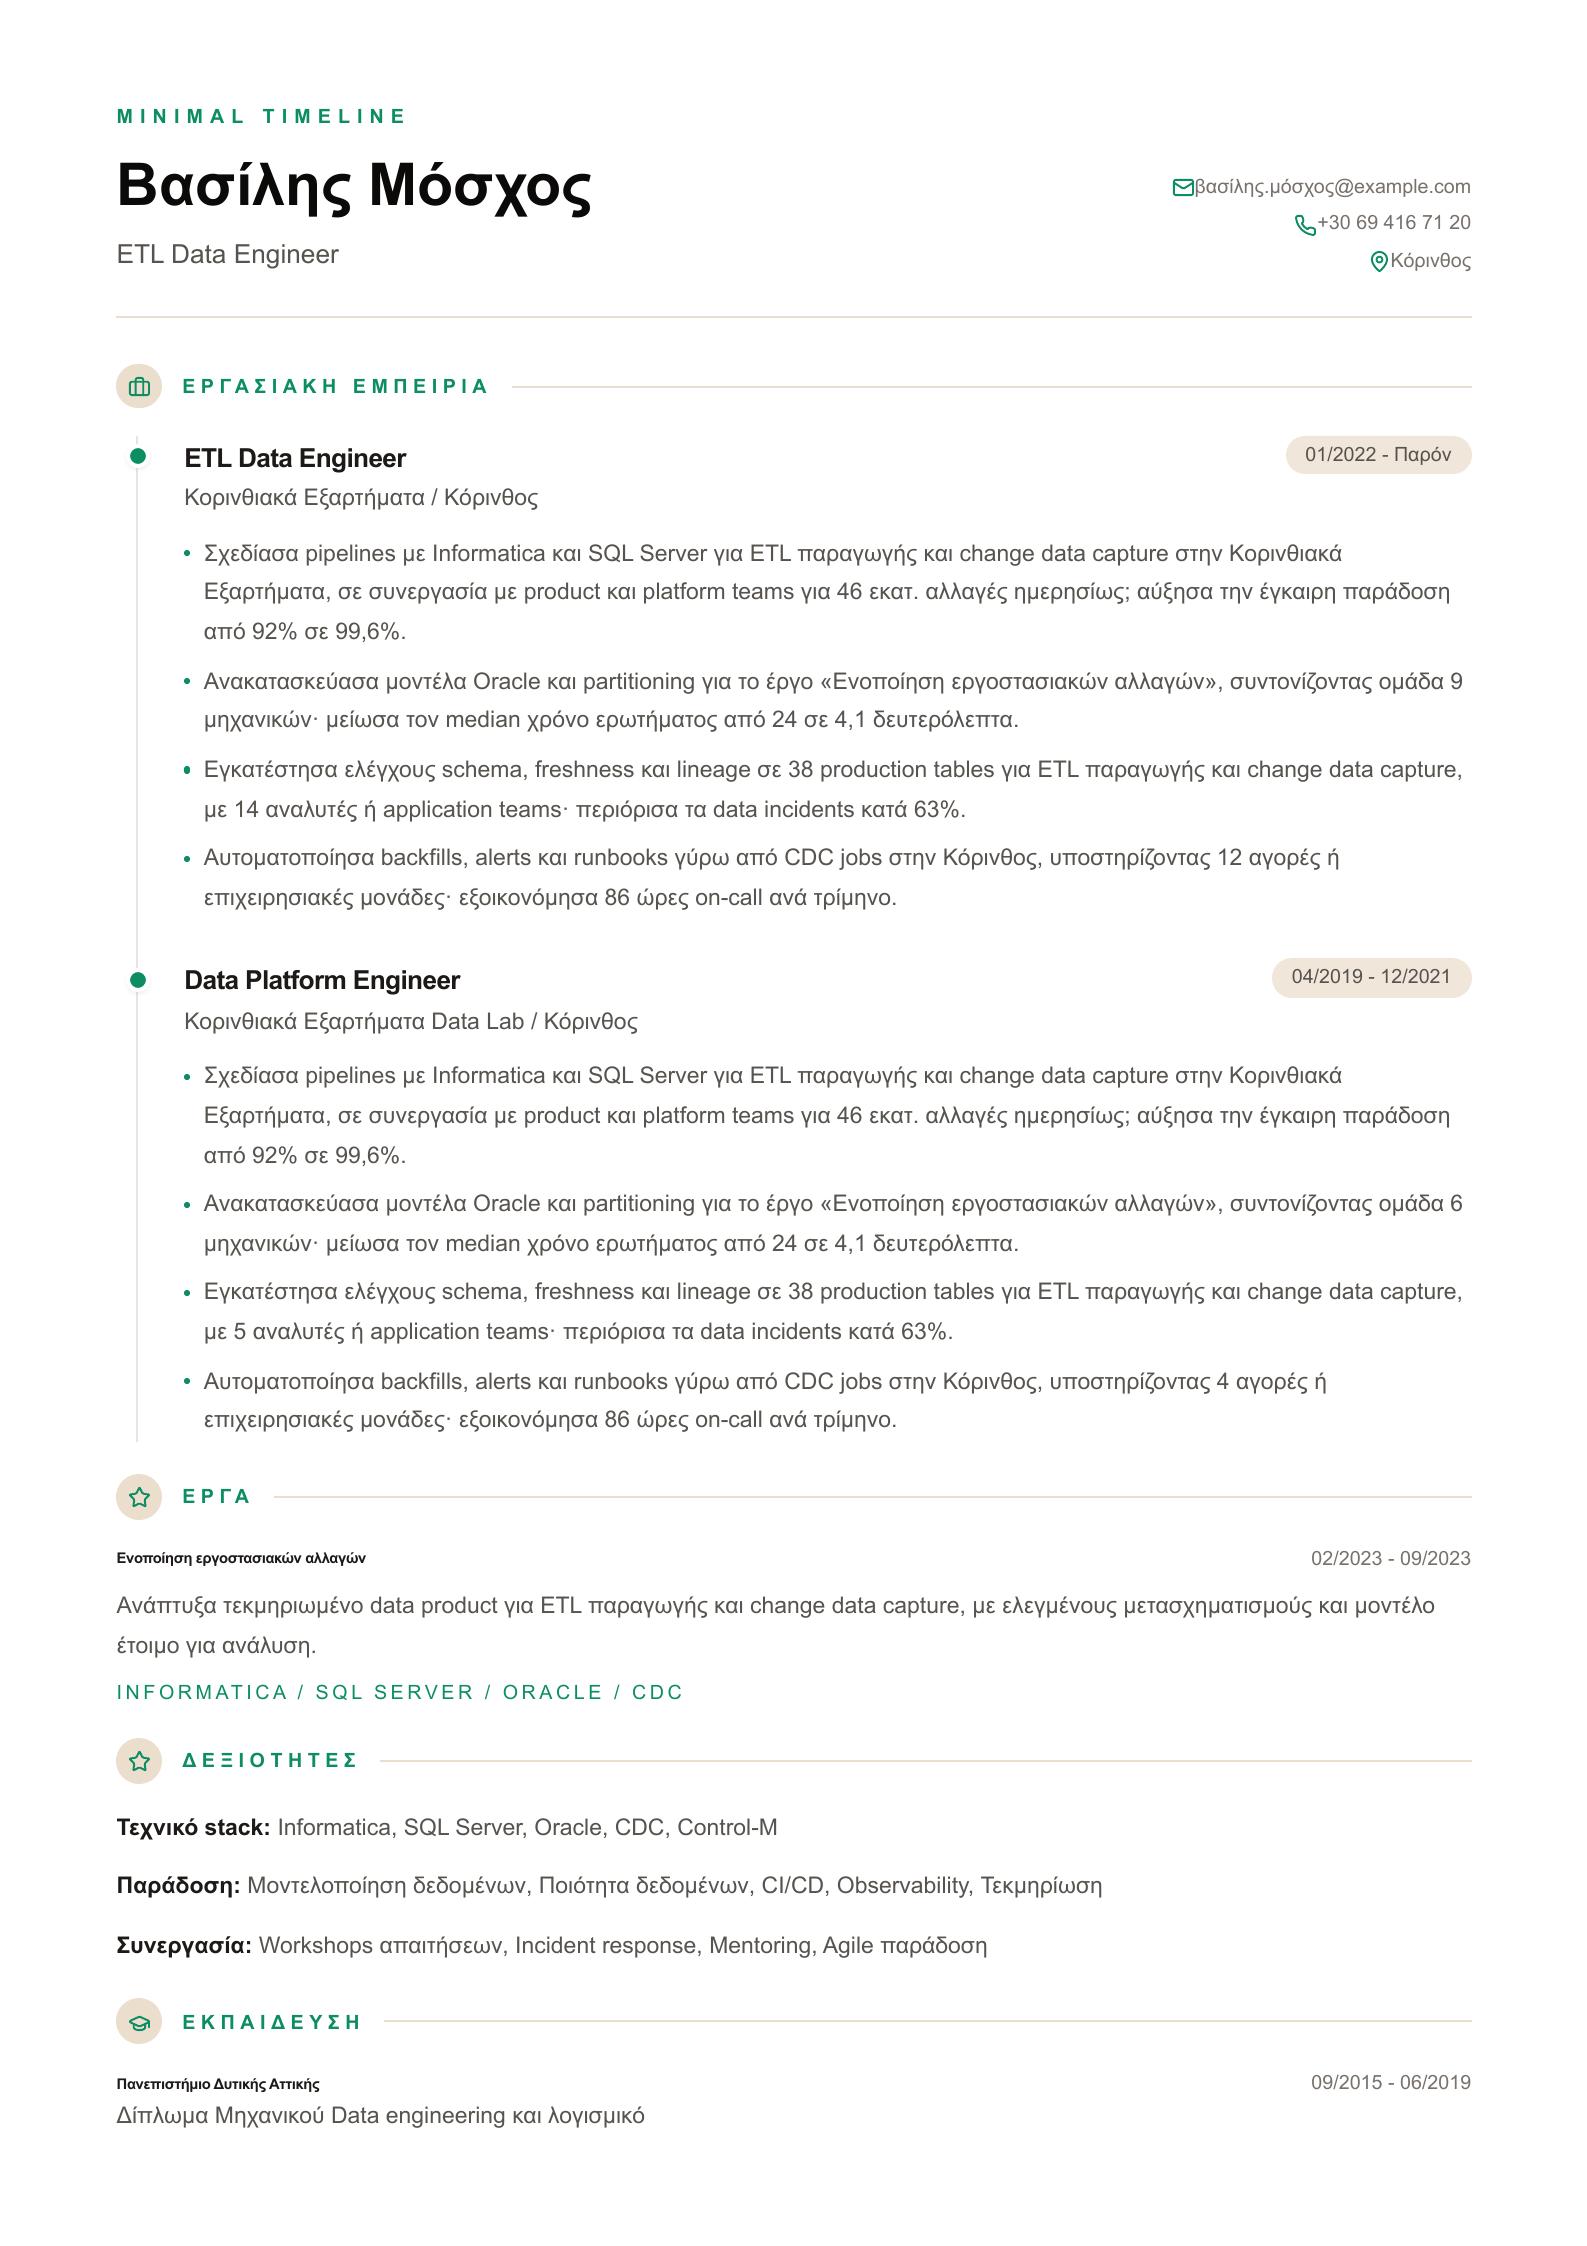
Πρωτότυπο ελληνικό παράδειγμα ETL Data Engineer με pipelines παραγωγής, συνεργασία μεταξύ ομάδων και μετρήσιμες βελτιώσεις.
Ταιριάζει σε: Για υποψηφίους που διεκδικούν ρόλους Computer Vision Data Engineer.
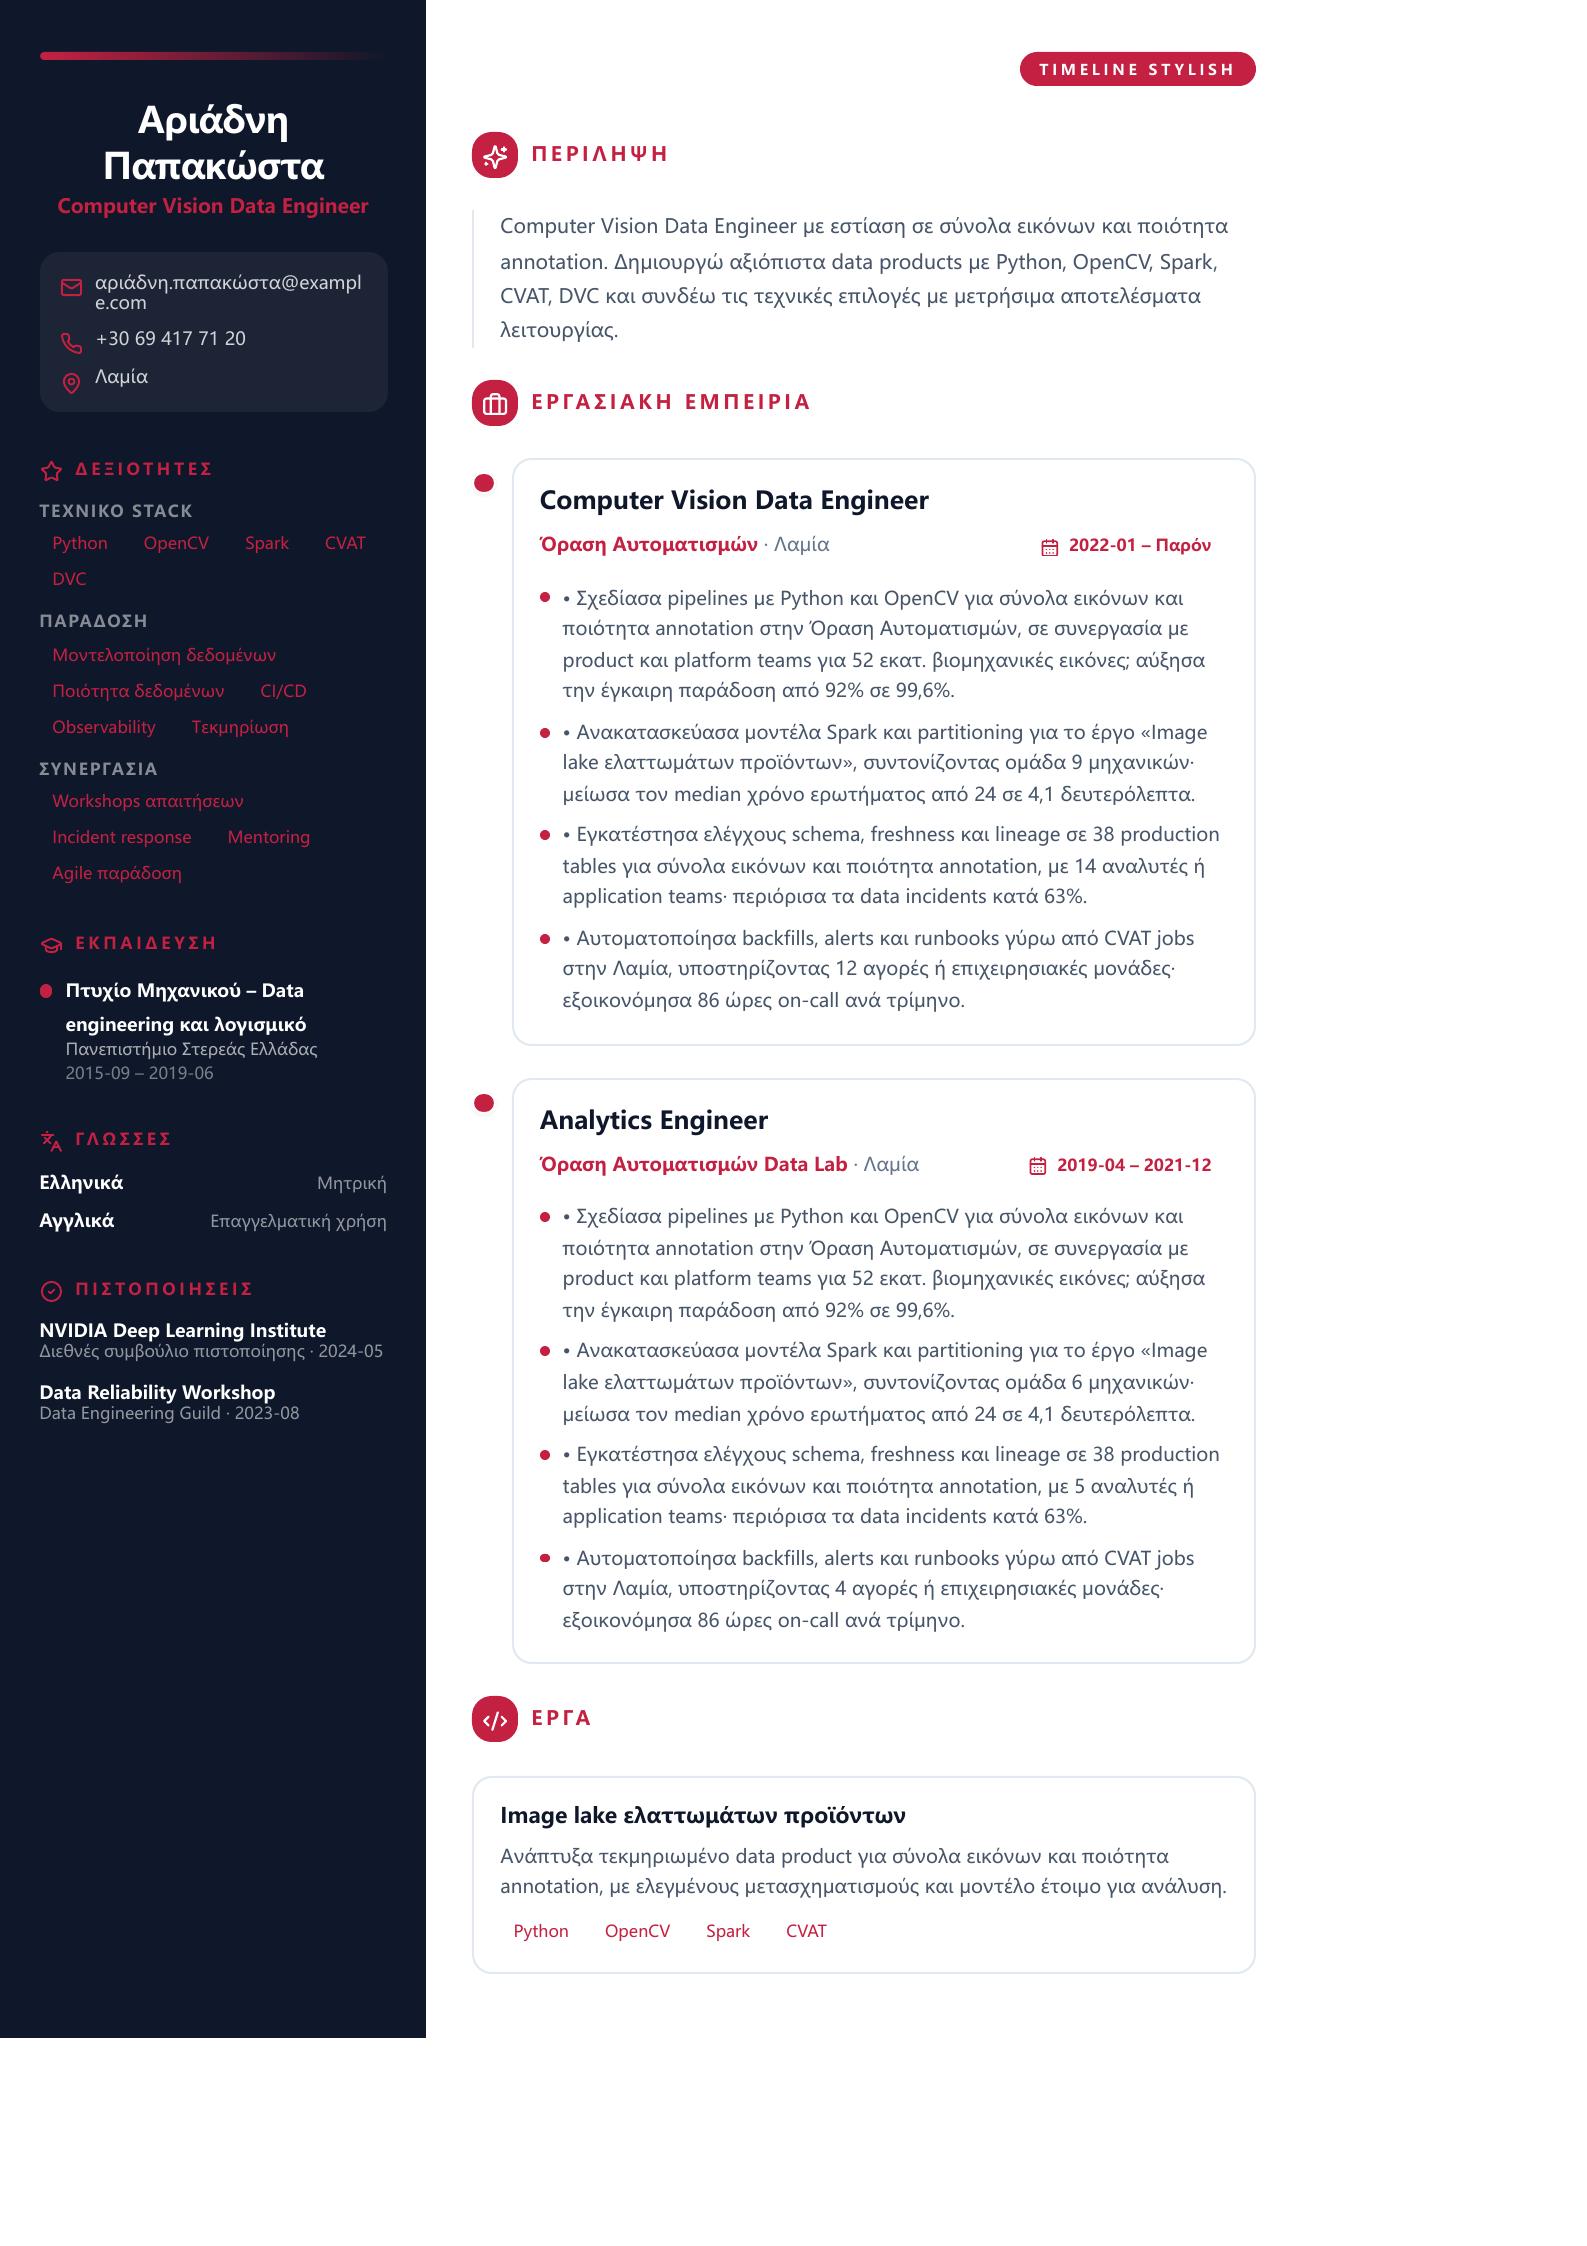
Πρωτότυπο ελληνικό παράδειγμα Computer Vision Data Engineer με pipelines παραγωγής, συνεργασία μεταξύ ομάδων και μετρήσιμες βελτιώσεις.
Αρχίστε κάθε σημείο με αυτό που βελτιώθηκε. Αναφέρετε χρόνο παράδοσης, ποιότητα, κόστος, κάλυψη ή σταθερότητα και μετά εξηγήστε ποιο σύστημα αλλάξατε.
Ονομάστε τις αποφάσεις που πήρατε: partitioning, incremental models, CDC, data contracts, orchestration, access control, backfills ή monitoring. Μια λίστα εργαλείων χωρίς πλαίσιο δεν αρκεί.
Προσθέστε αριθμό πηγών, πινάκων, γραμμών, αγορών, χρηστών ή συναδέλφων. Έτσι φαίνεται αν εργαστήκατε σε prototype, προϊόν ή πλατφόρμα ολόκληρου οργανισμού.
Γράψτε τιμή πριν και μετά και την περίοδο μέτρησης. Χρησιμοποιήστε μόνο αριθμούς που μπορείτε να εξηγήσετε σε συνέντευξη και πείτε πώς μετρήθηκαν.
Παράδειγμα δυνατού bullet
• Ανακατασκεύασα 42 μοντέλα Kafka-to-Snowflake με incremental φόρτωση μαζί με 7 αναλυτές σε 3 αγορές· μείωσα την ημερήσια ανανέωση από 95 σε 18 λεπτά και τις αποτυχημένες εκτελέσεις κατά 71%.
Μία σελίδα λειτουργεί καλά στην αρχή της καριέρας. Δύο σελίδες είναι λογικές όταν πρέπει να δείξετε ownership πλατφόρμας, περισσότερα cloud περιβάλλοντα ή τεχνική ηγεσία. Βάλτε τα ισχυρότερα αποτελέσματα στην πρώτη σελίδα.
Δώστε προτεραιότητα σε εργαλεία που χρησιμοποιήσατε σε παραγωγή, ομαδοποιημένα ανά γλώσσα, orchestration, storage, processing, cloud και quality. Συνδέστε τη λίστα με bullets που δείχνουν τι παρέδωσαν.
Χρησιμοποιήστε μέτρηση όταν μπορείτε να την τεκμηριώσετε. Χρήσιμα μεγέθη είναι ο όγκος δεδομένων, freshness, latency, κόστος, error rate, χρόνος παράδοσης, κάλυψη ή χρήση.
Ναι. Ανοίξτε ένα παράδειγμα στον editor, αντικαταστήστε τα φανταστικά στοιχεία με τα δικά σας και κρατήστε τη δομή πρόβλημα, ενέργεια, κλίμακα και αποτέλεσμα.