Data Engineer cv-voorbeeld
Geschikt voor: Geschikt voor kandidaten voor Data Engineer.
Nederlands cv-voorbeeld voor Data Engineer, met pipeline-scope, samenwerking en meetbare resultaten.
Vergelijk Nederlandse voorbeelden voor cloud, datawarehouses, streaming, ETL, analytics en computer vision. Elk voorbeeld maakt technische acties, schaal, samenwerking en resultaten concreet.
Kies op cloud, ervaring of specialisme en bewerk daarna het sjabloon.
Geschikt voor: Geschikt voor kandidaten voor Data Engineer.
Nederlands cv-voorbeeld voor Data Engineer, met pipeline-scope, samenwerking en meetbare resultaten.
Geschikt voor: Geschikt voor kandidaten voor Azure Data Engineer.
Nederlands cv-voorbeeld voor Azure Data Engineer, met pipeline-scope, samenwerking en meetbare resultaten.
Geschikt voor: Geschikt voor kandidaten voor AWS Data Engineer.
Nederlands cv-voorbeeld voor AWS Data Engineer, met pipeline-scope, samenwerking en meetbare resultaten.
Geschikt voor: Geschikt voor kandidaten voor GCP Data Engineer.
Nederlands cv-voorbeeld voor GCP Data Engineer, met pipeline-scope, samenwerking en meetbare resultaten.
Geschikt voor: Geschikt voor kandidaten voor Snowflake Data Engineer.
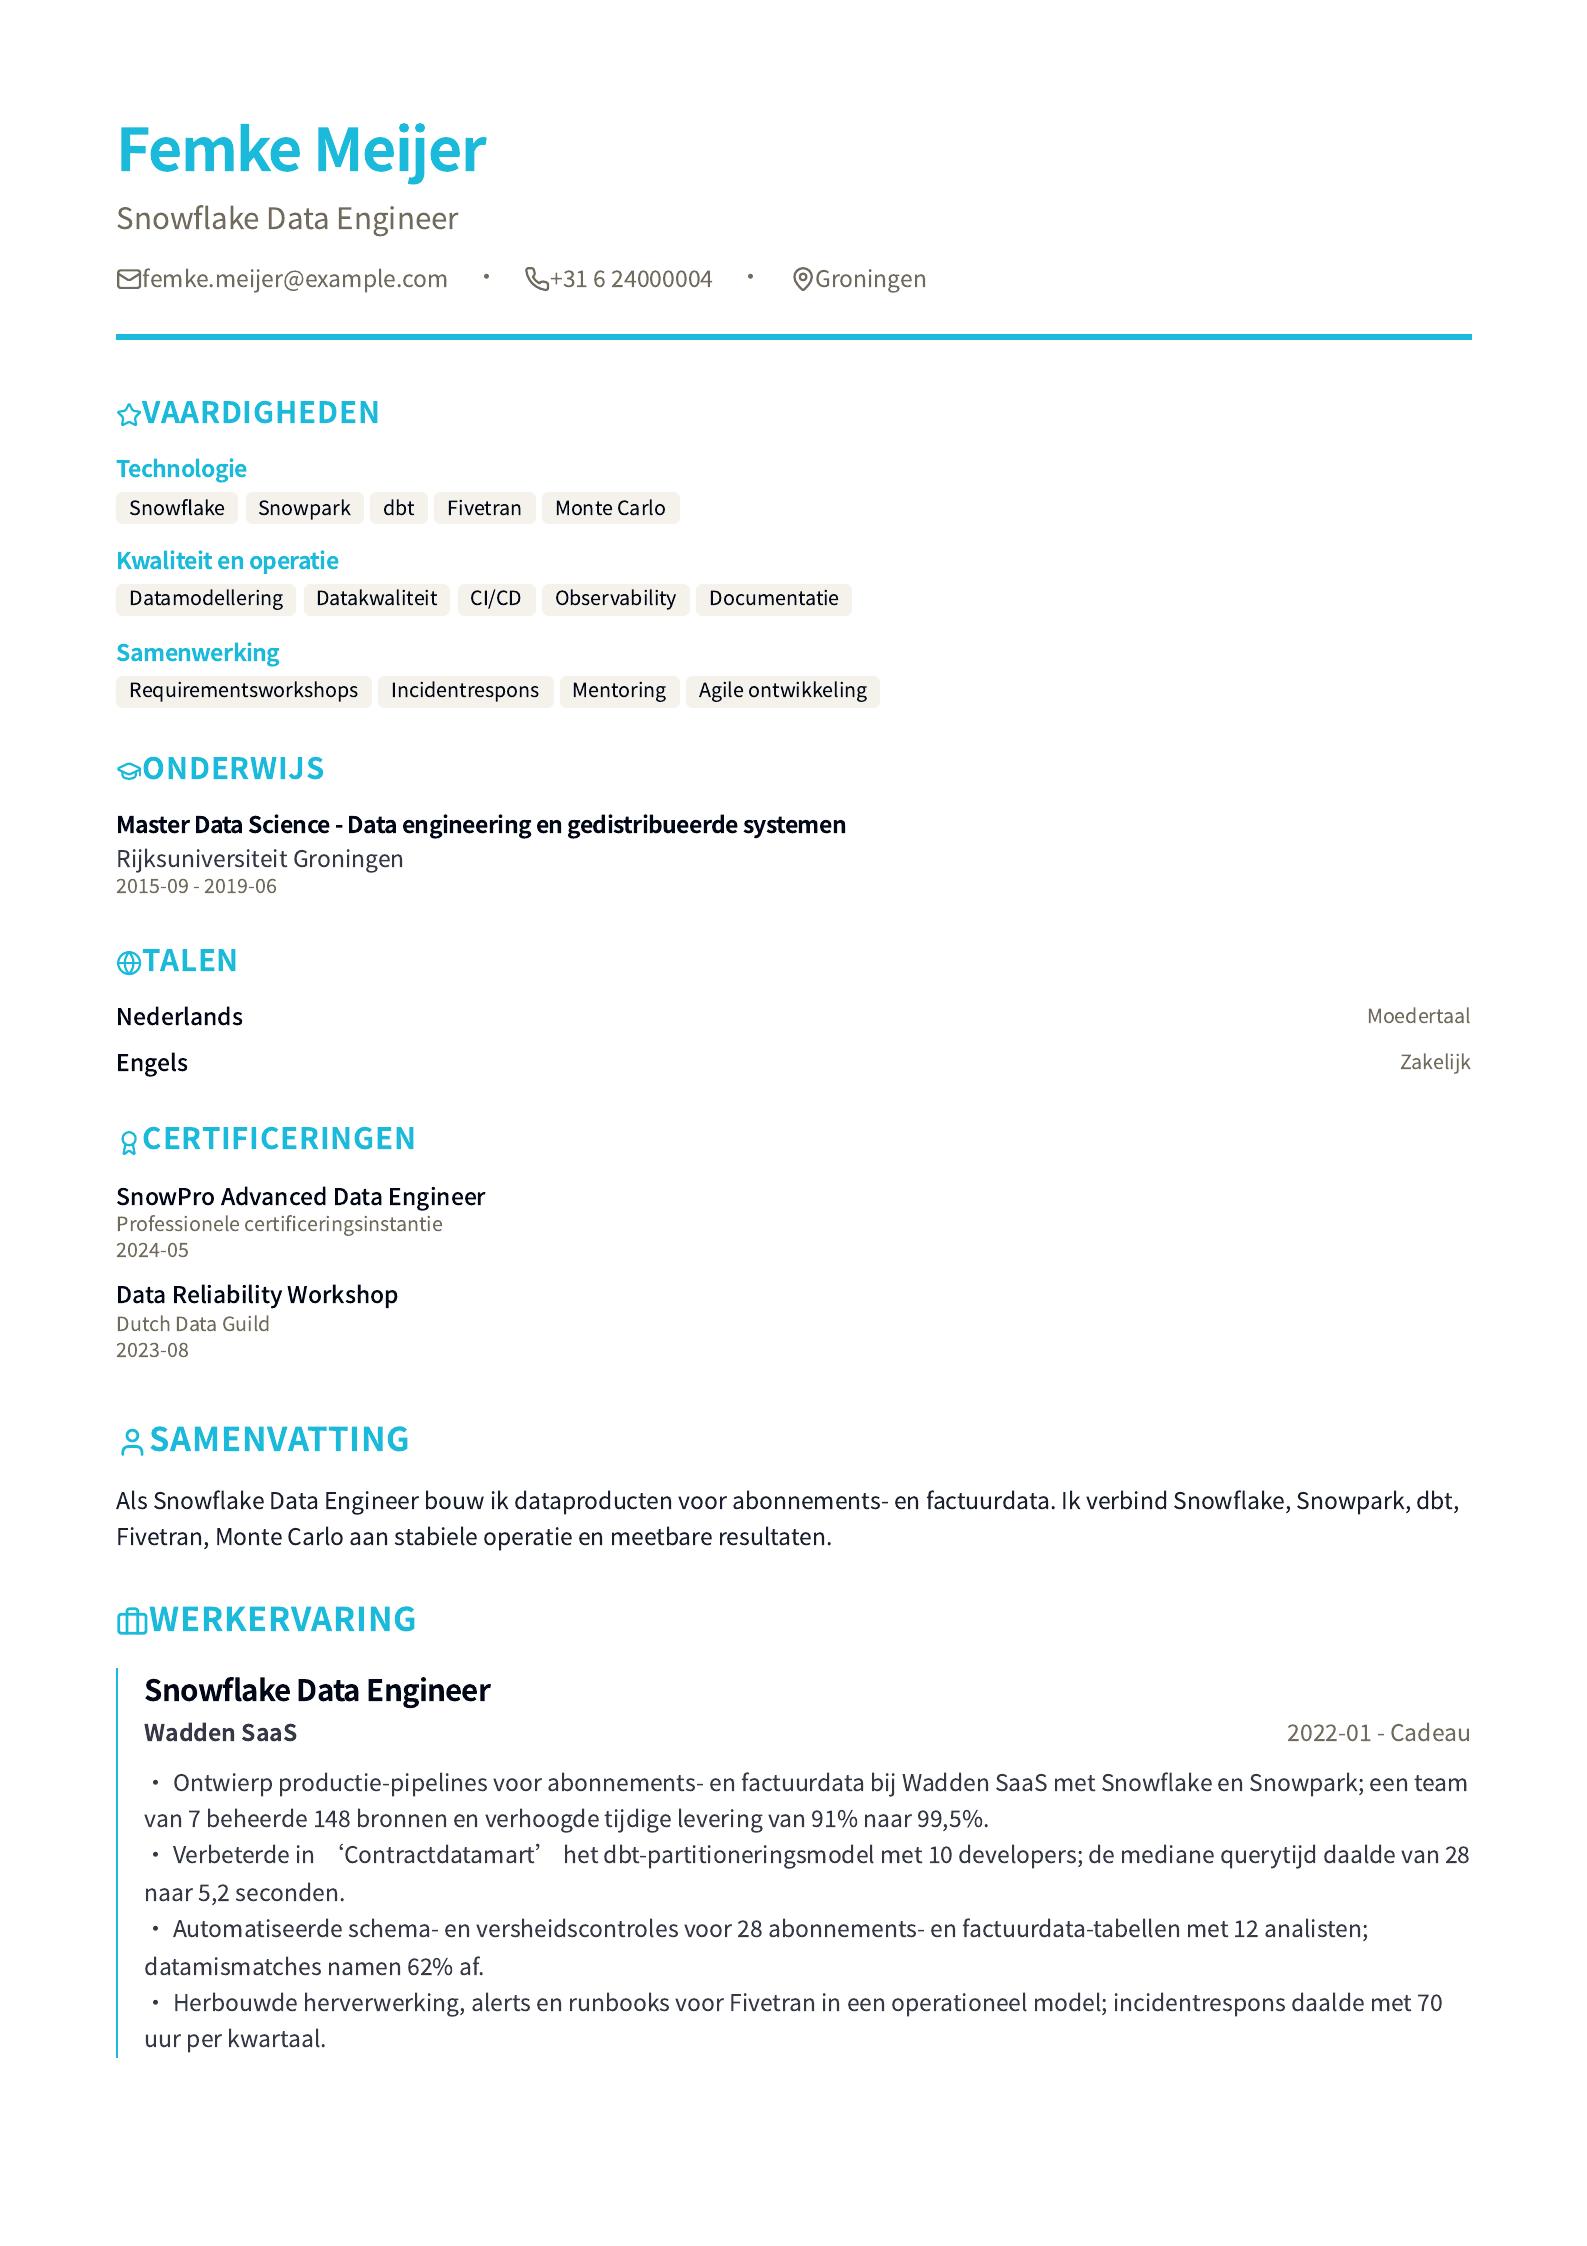
Nederlands cv-voorbeeld voor Snowflake Data Engineer, met pipeline-scope, samenwerking en meetbare resultaten.
Geschikt voor: Geschikt voor kandidaten voor Big Data Engineer.
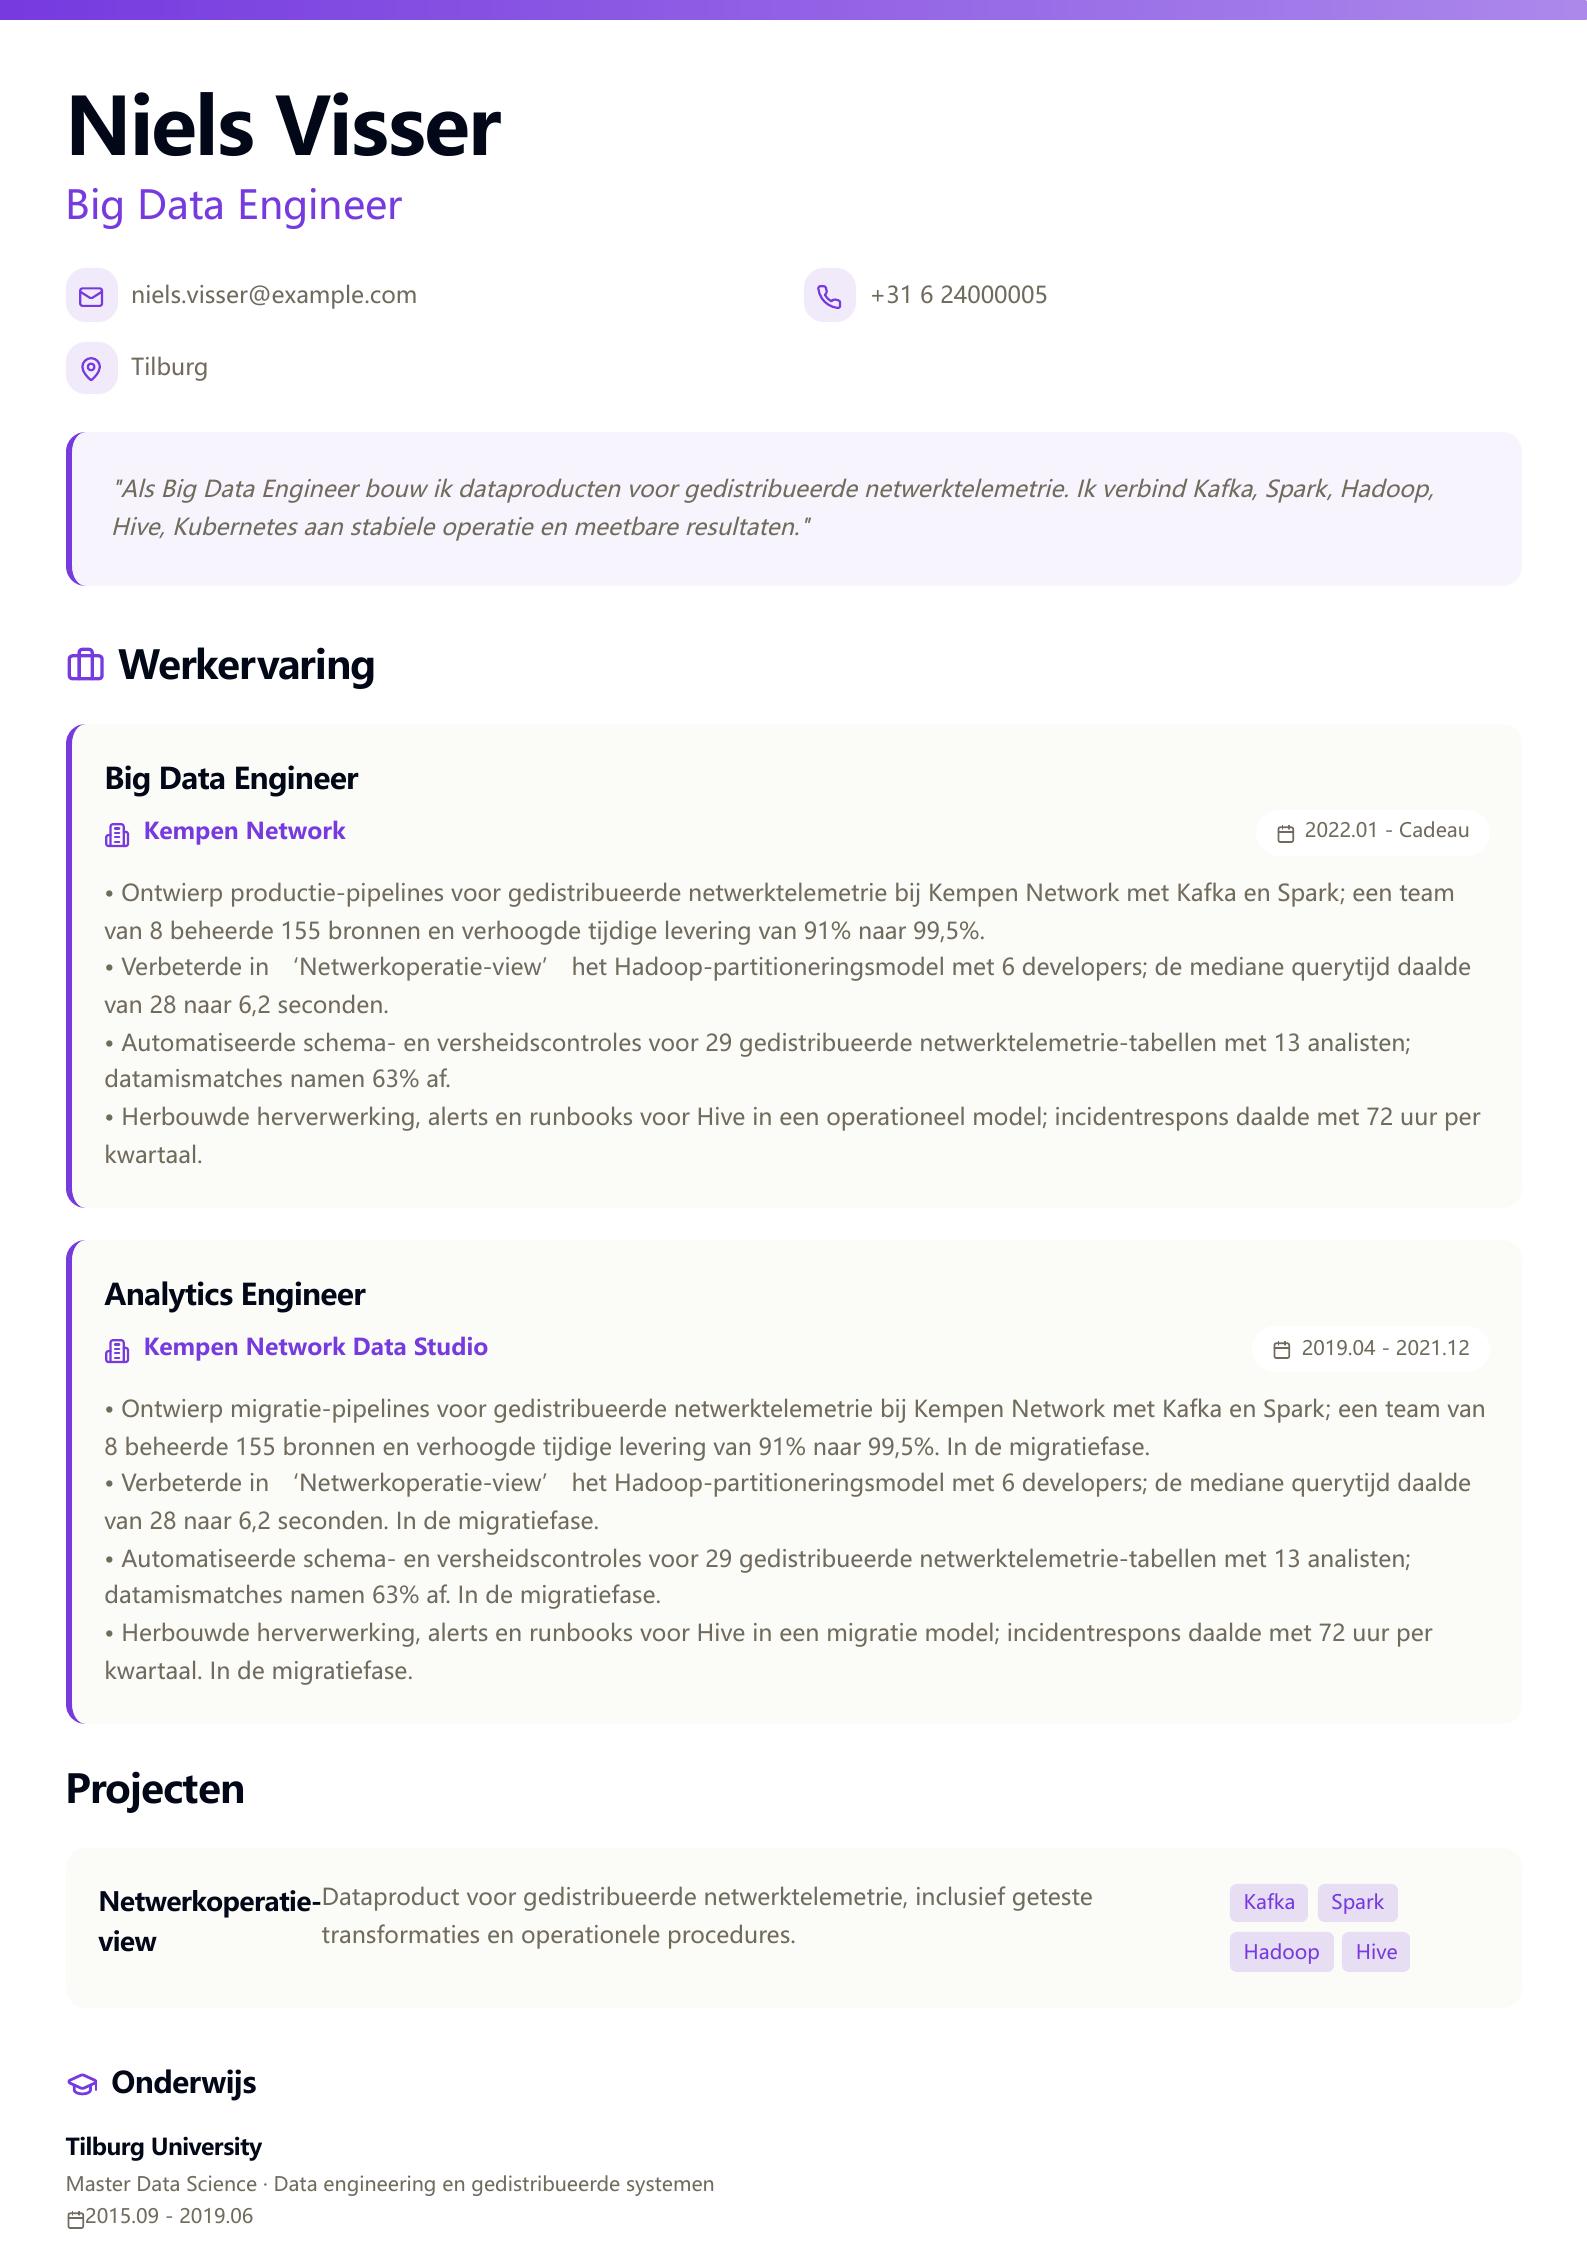
Nederlands cv-voorbeeld voor Big Data Engineer, met pipeline-scope, samenwerking en meetbare resultaten.
Geschikt voor: Geschikt voor kandidaten voor Data Center Engineer.
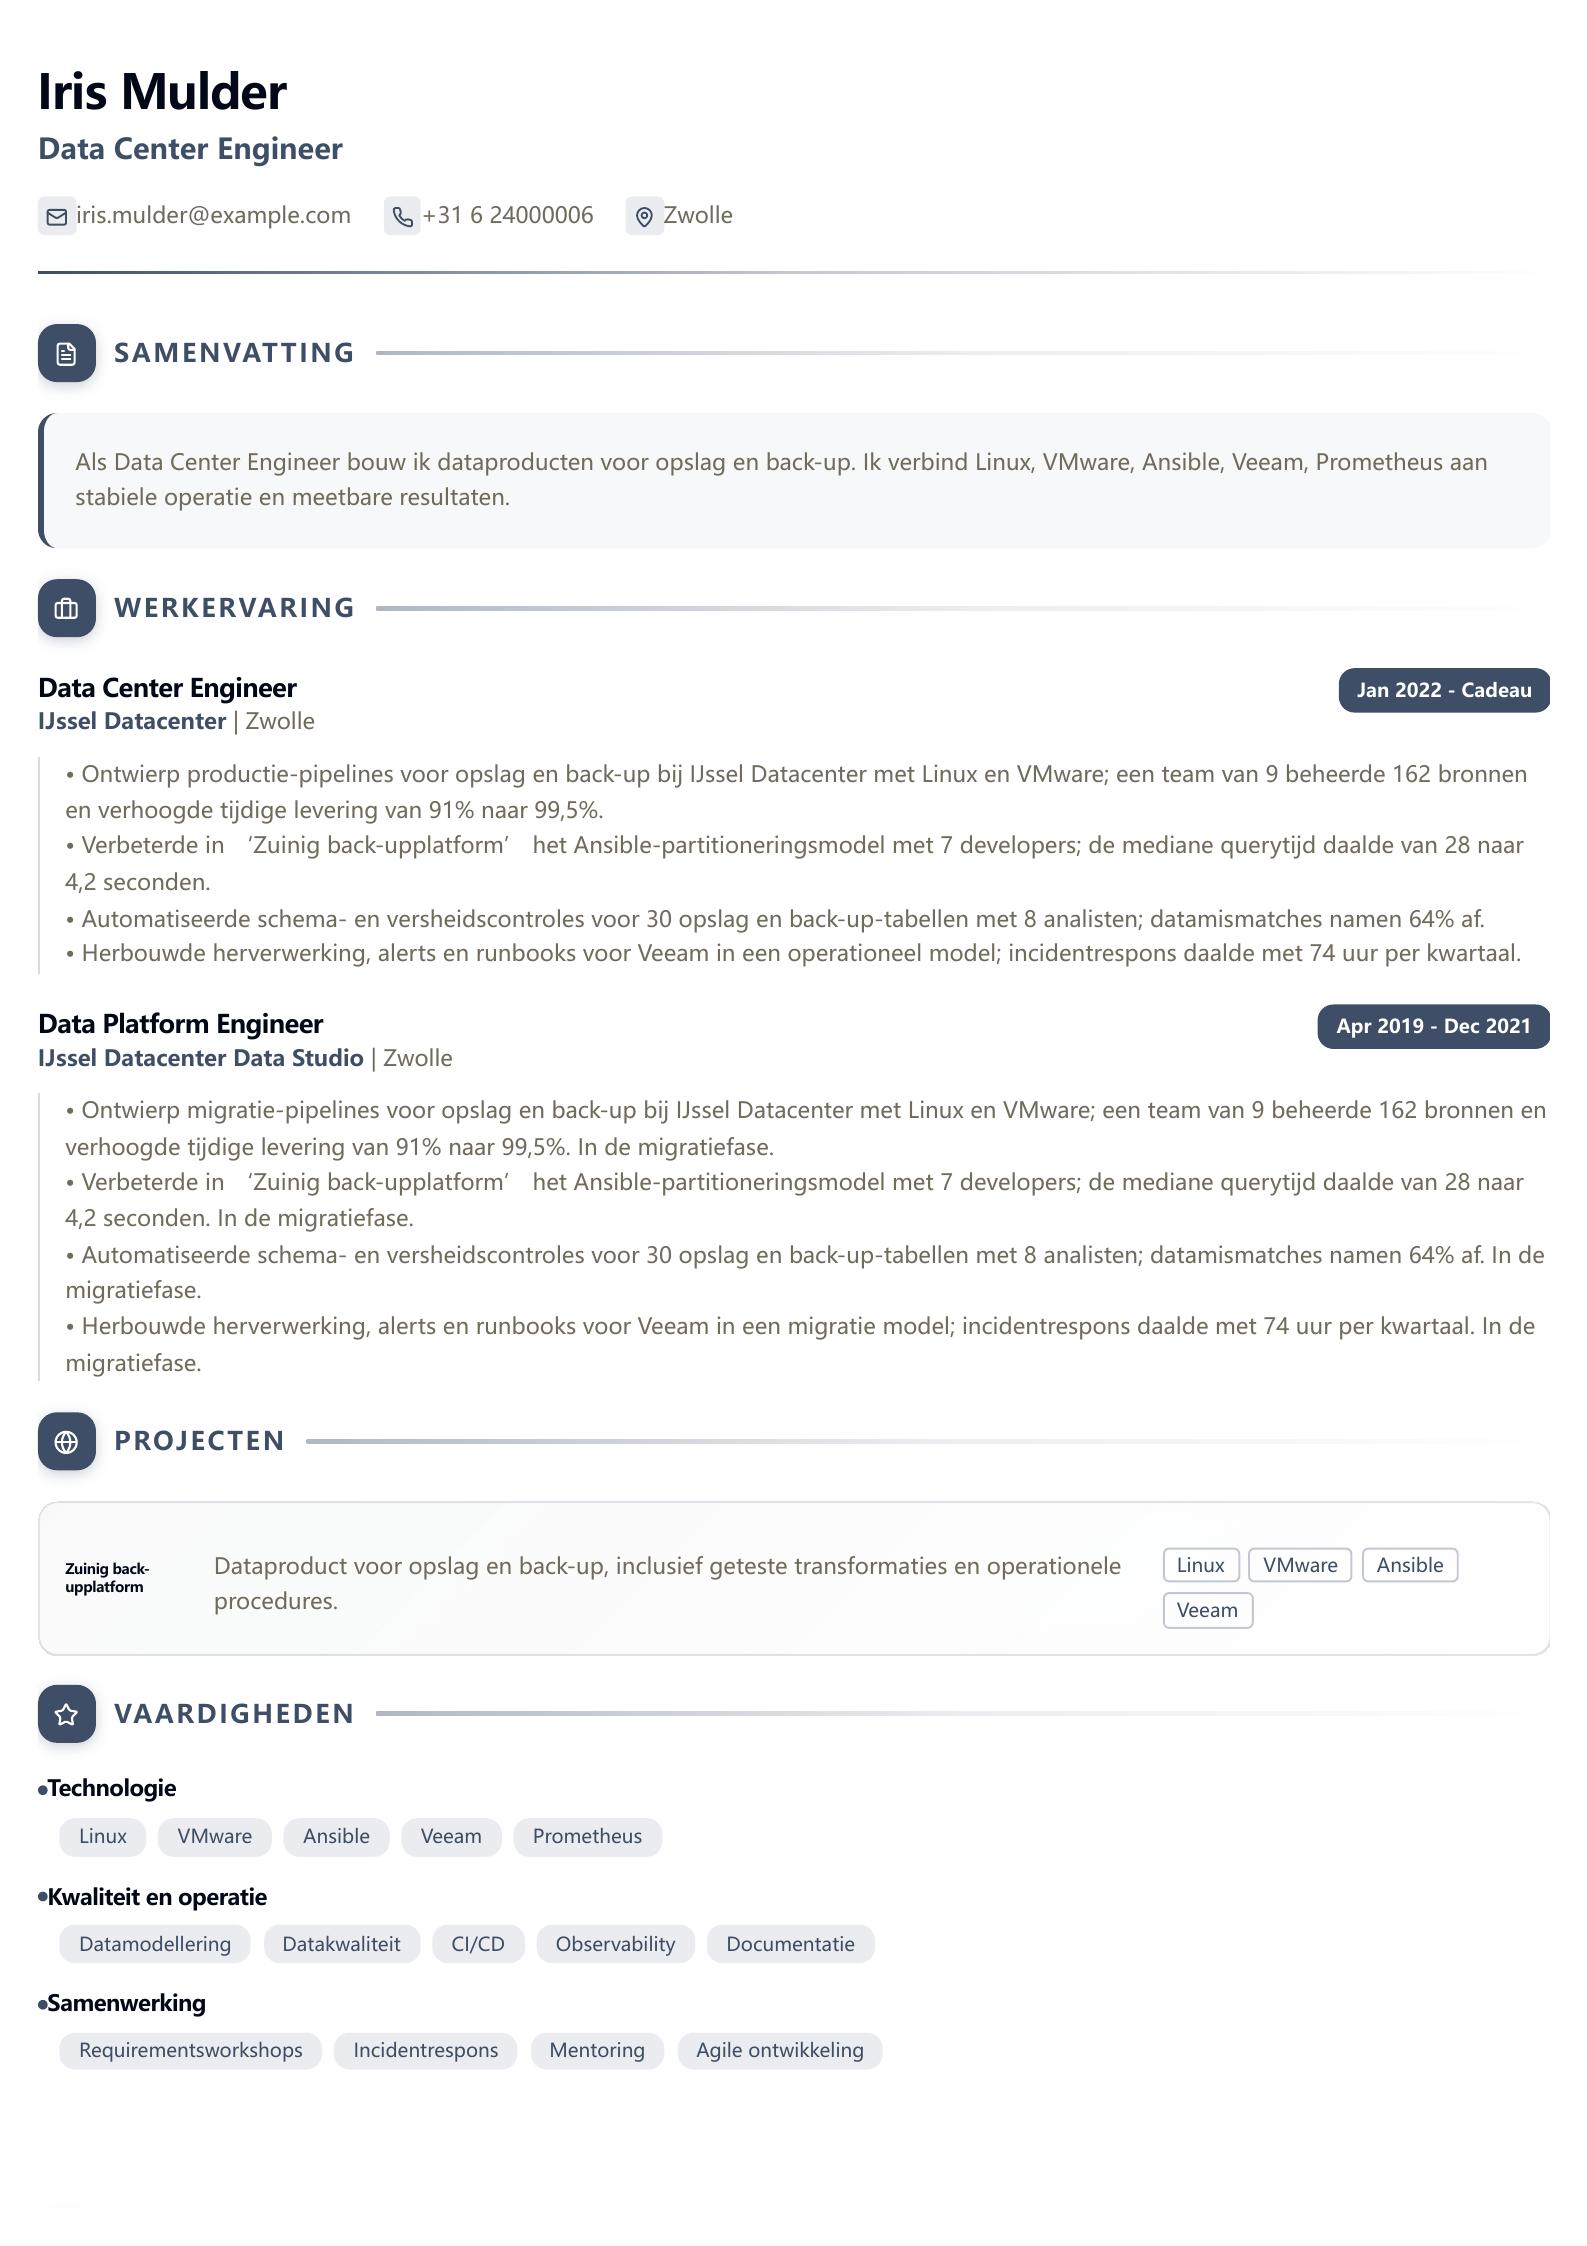
Nederlands cv-voorbeeld voor Data Center Engineer, met pipeline-scope, samenwerking en meetbare resultaten.
Geschikt voor: Geschikt voor kandidaten voor Databricks Data Engineer.
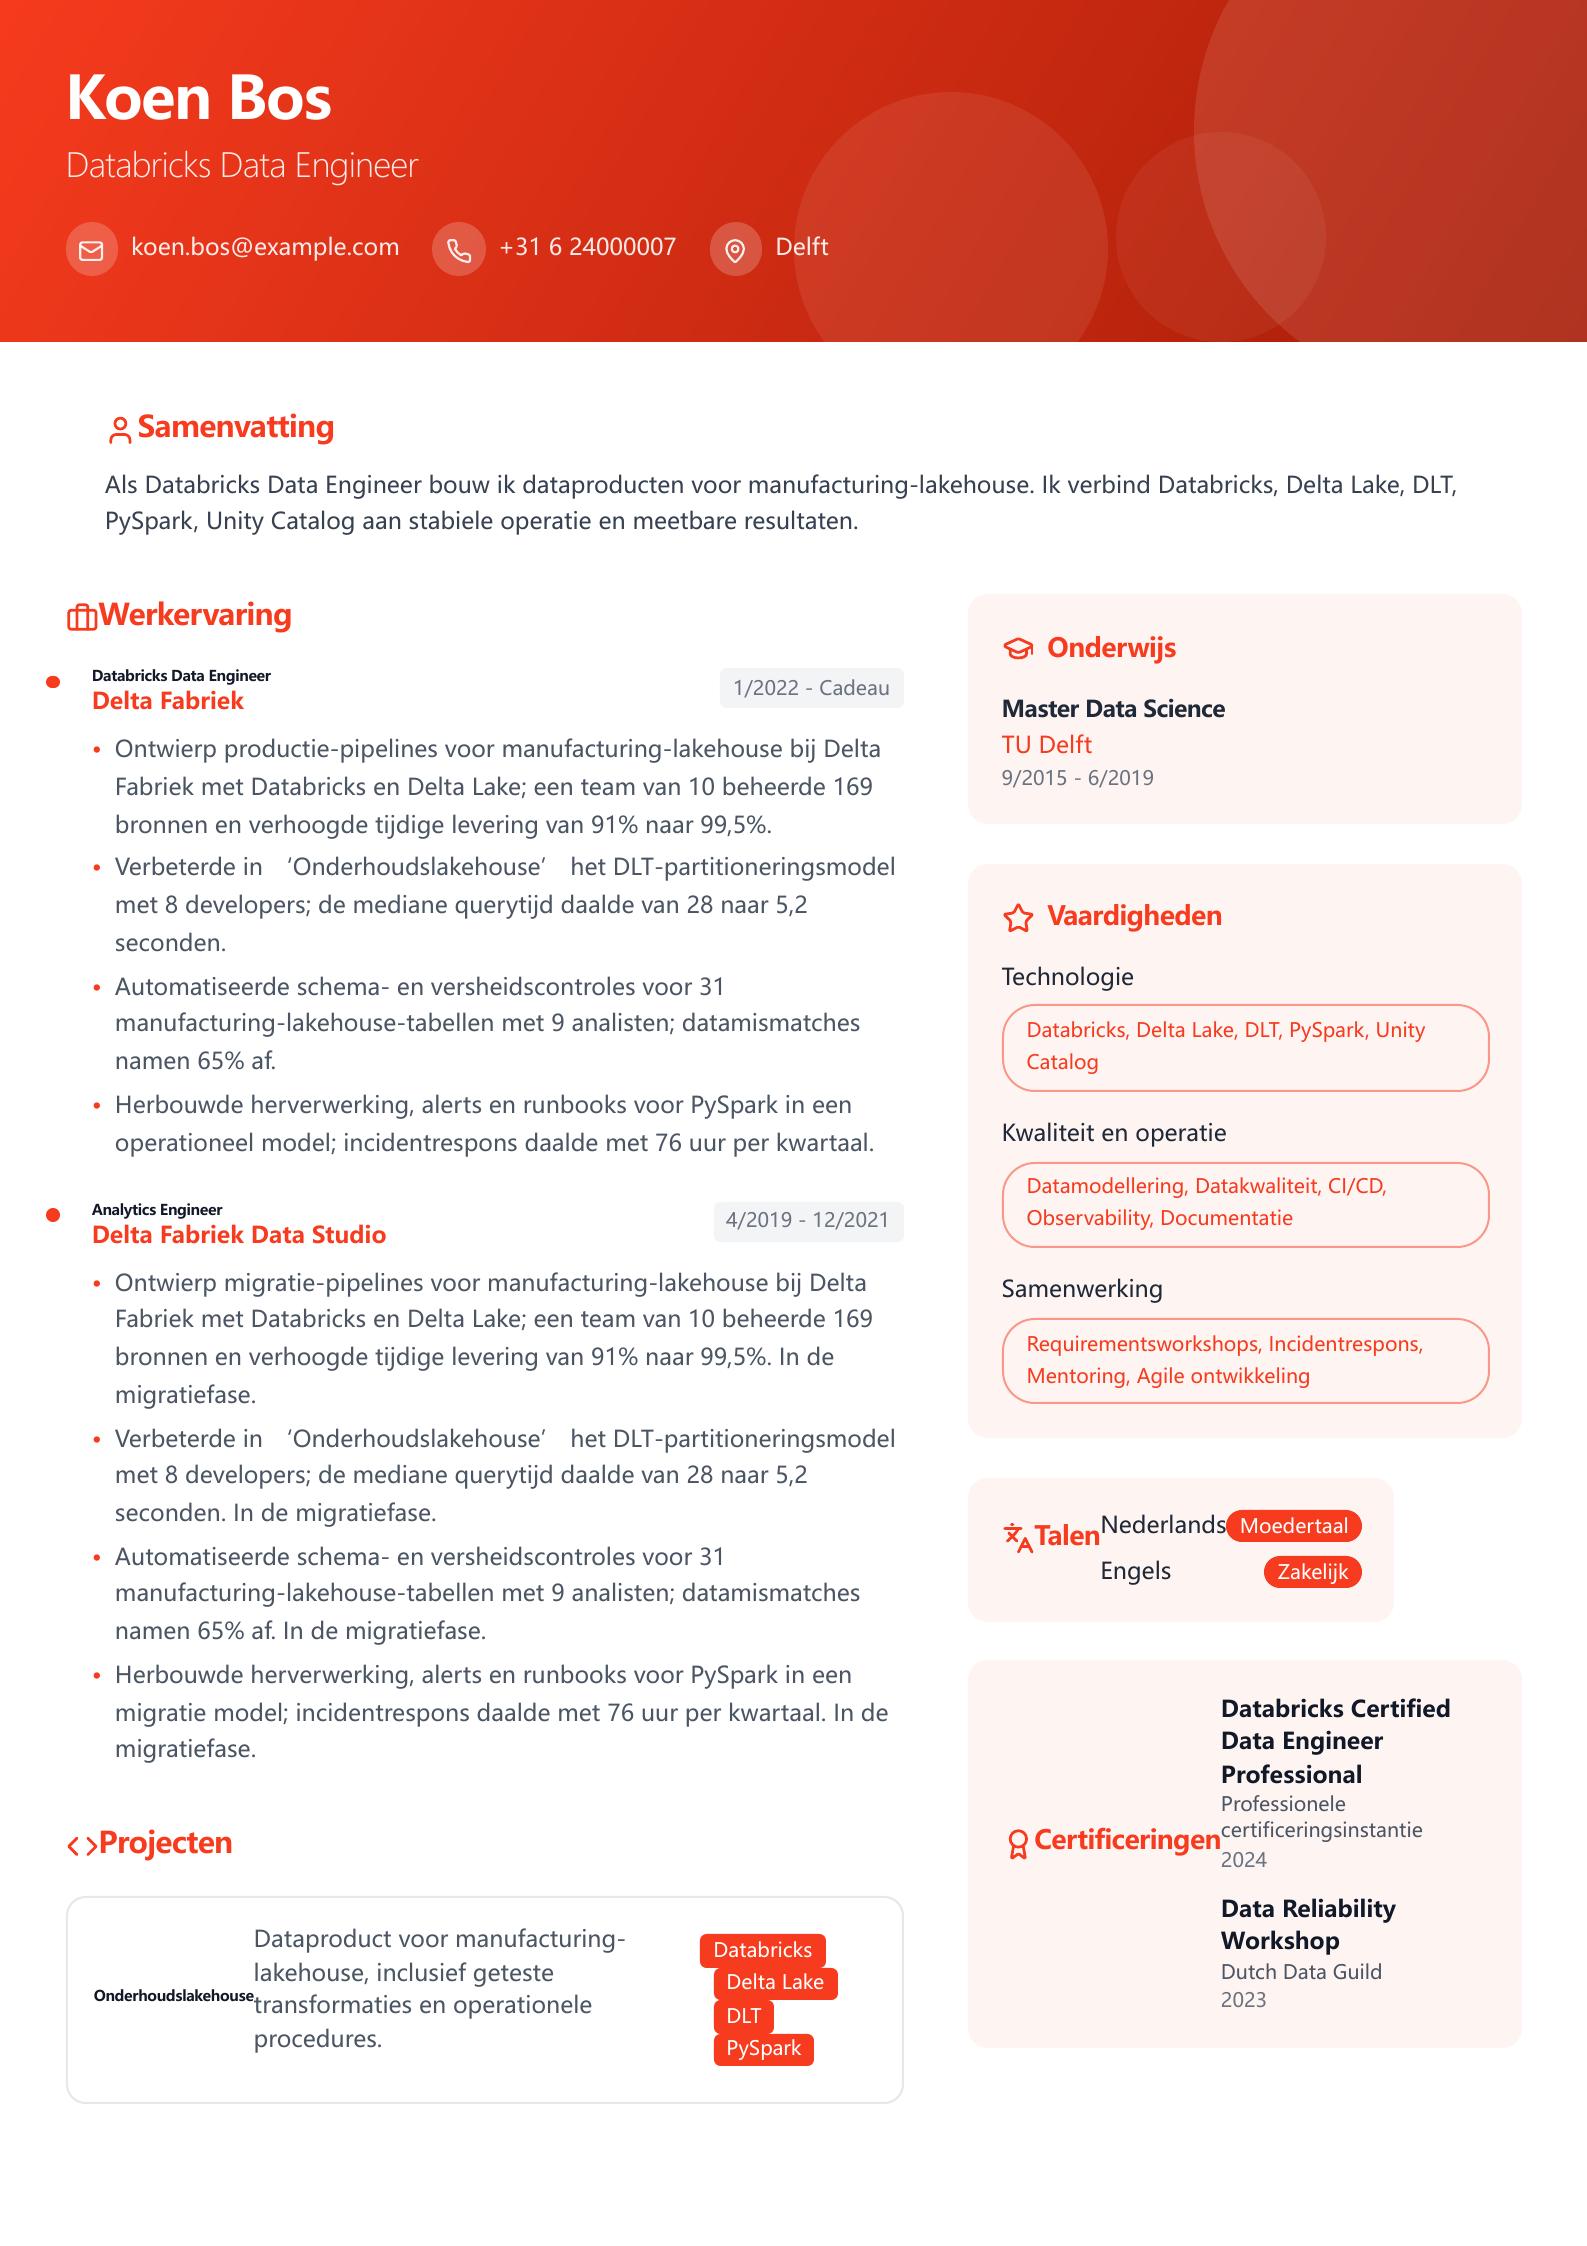
Nederlands cv-voorbeeld voor Databricks Data Engineer, met pipeline-scope, samenwerking en meetbare resultaten.
Geschikt voor: Geschikt voor kandidaten voor Data Engineer-stagiair.
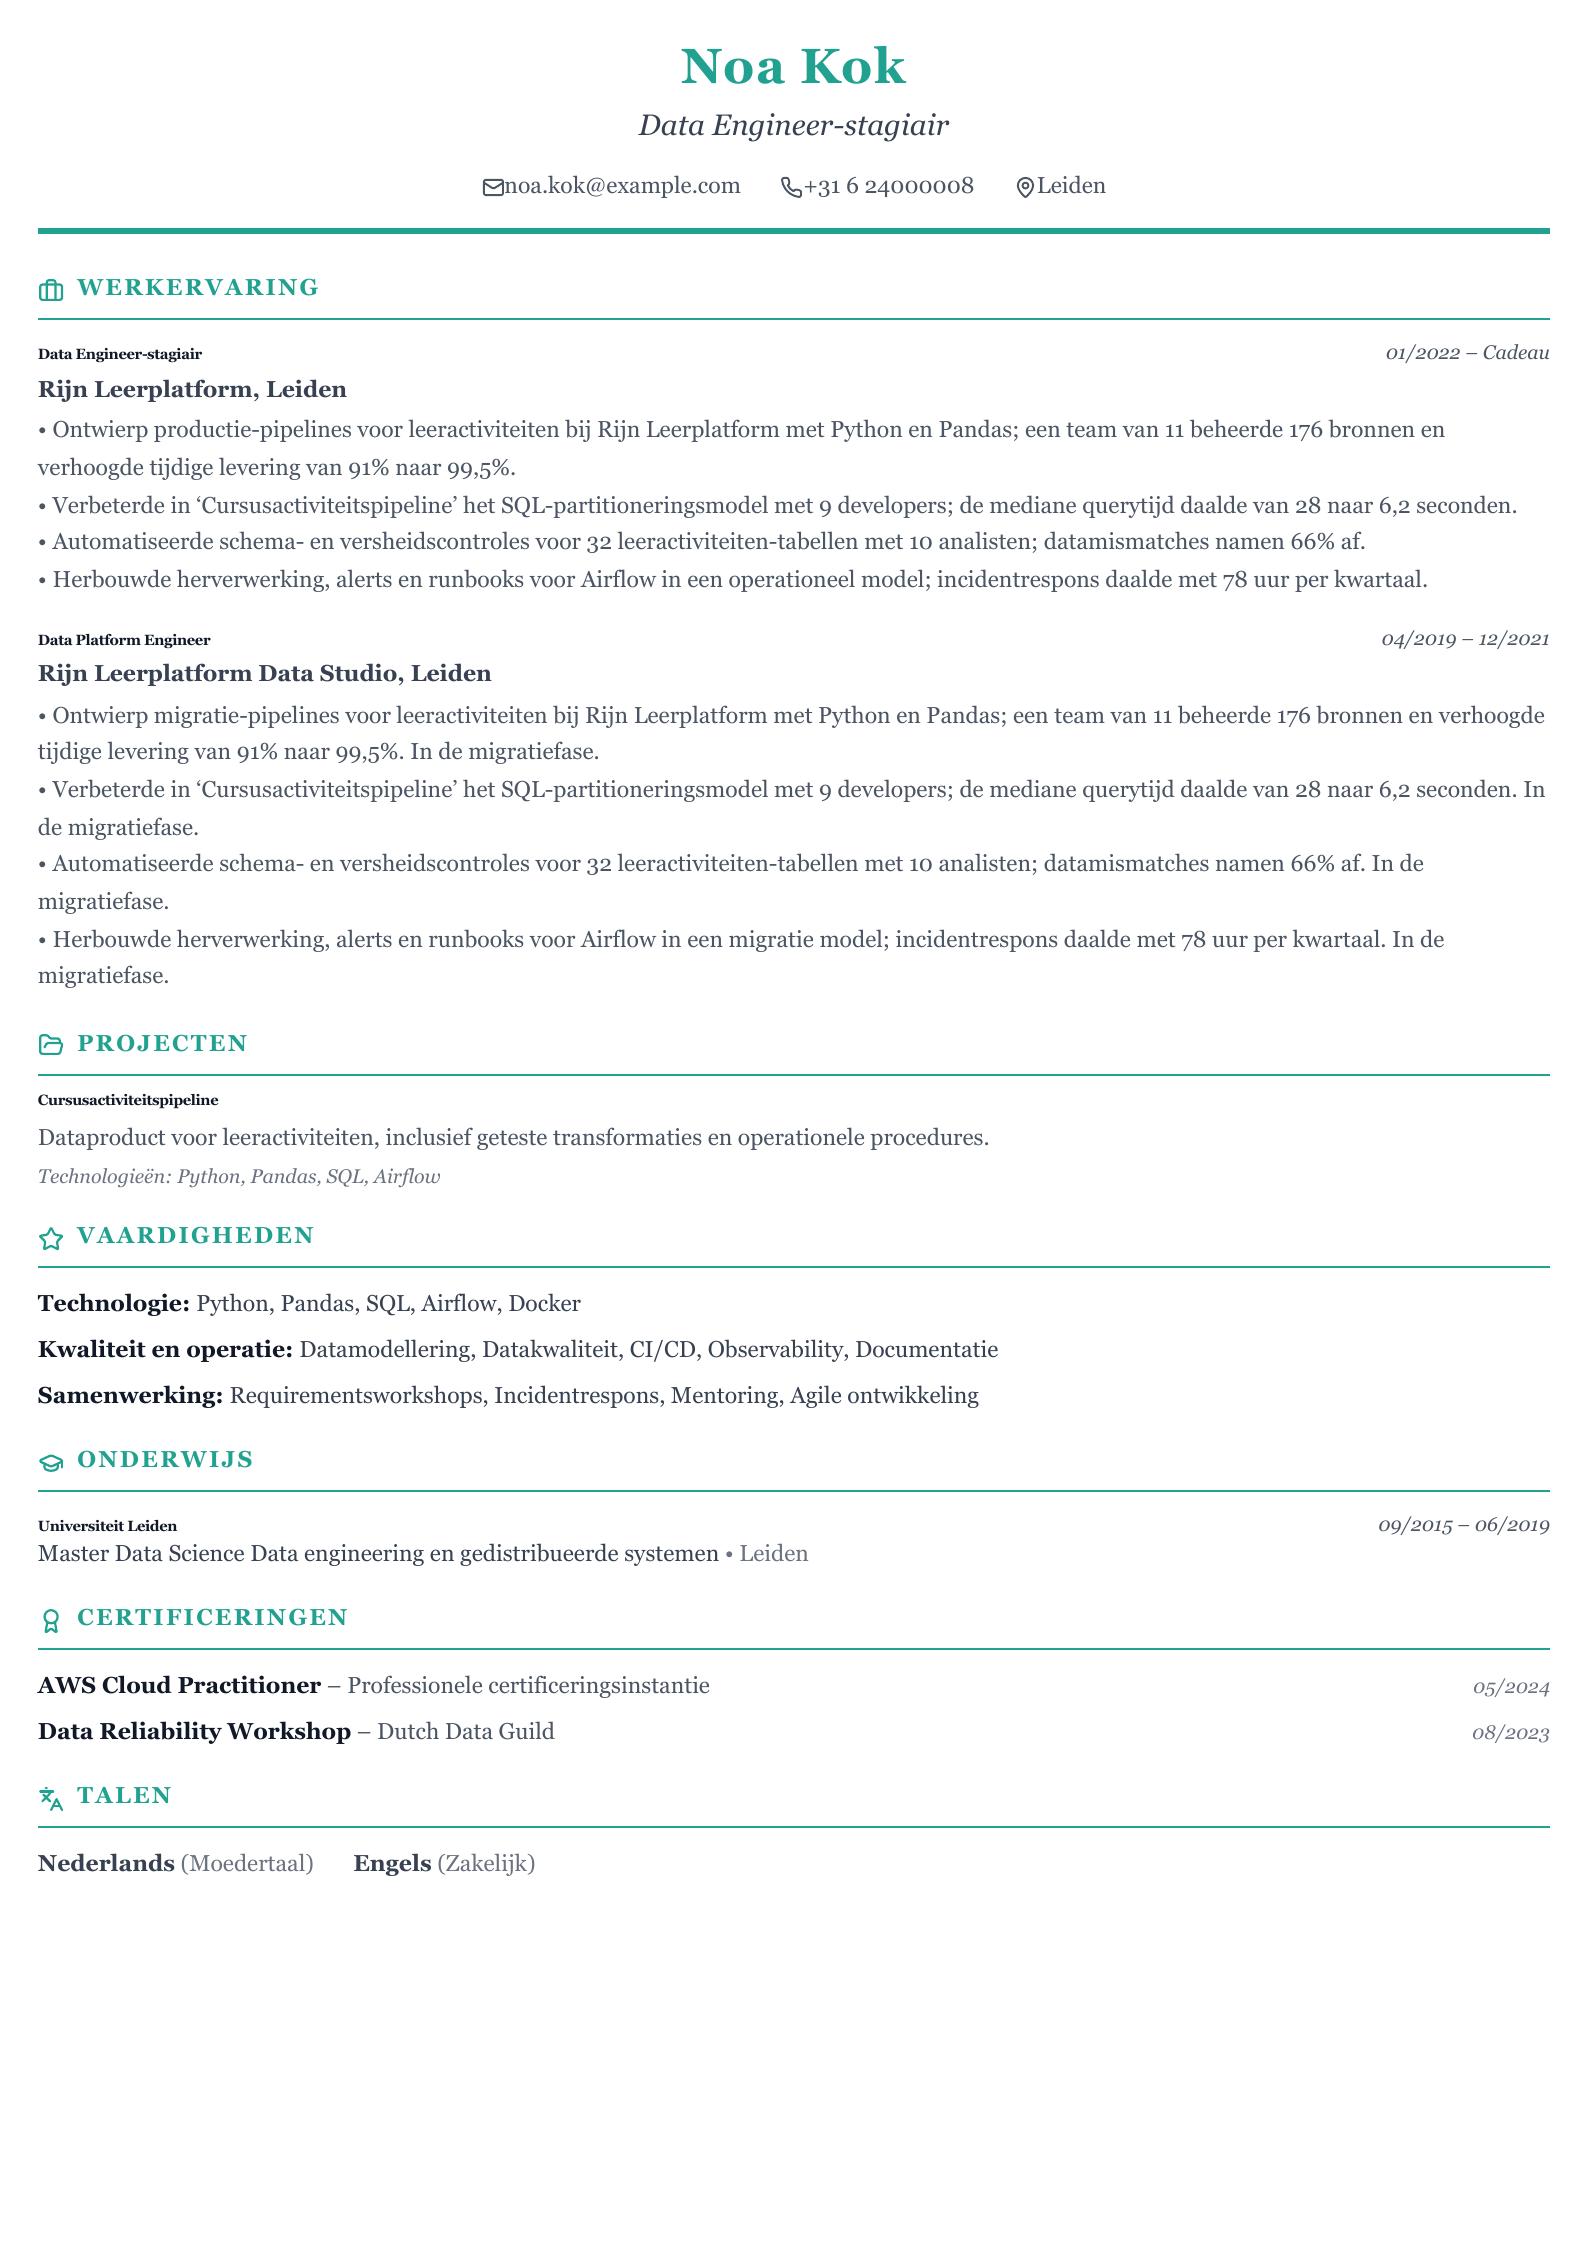
Nederlands cv-voorbeeld voor Data Engineer-stagiair, met pipeline-scope, samenwerking en meetbare resultaten.
Geschikt voor: Geschikt voor kandidaten voor Junior Data Engineer.
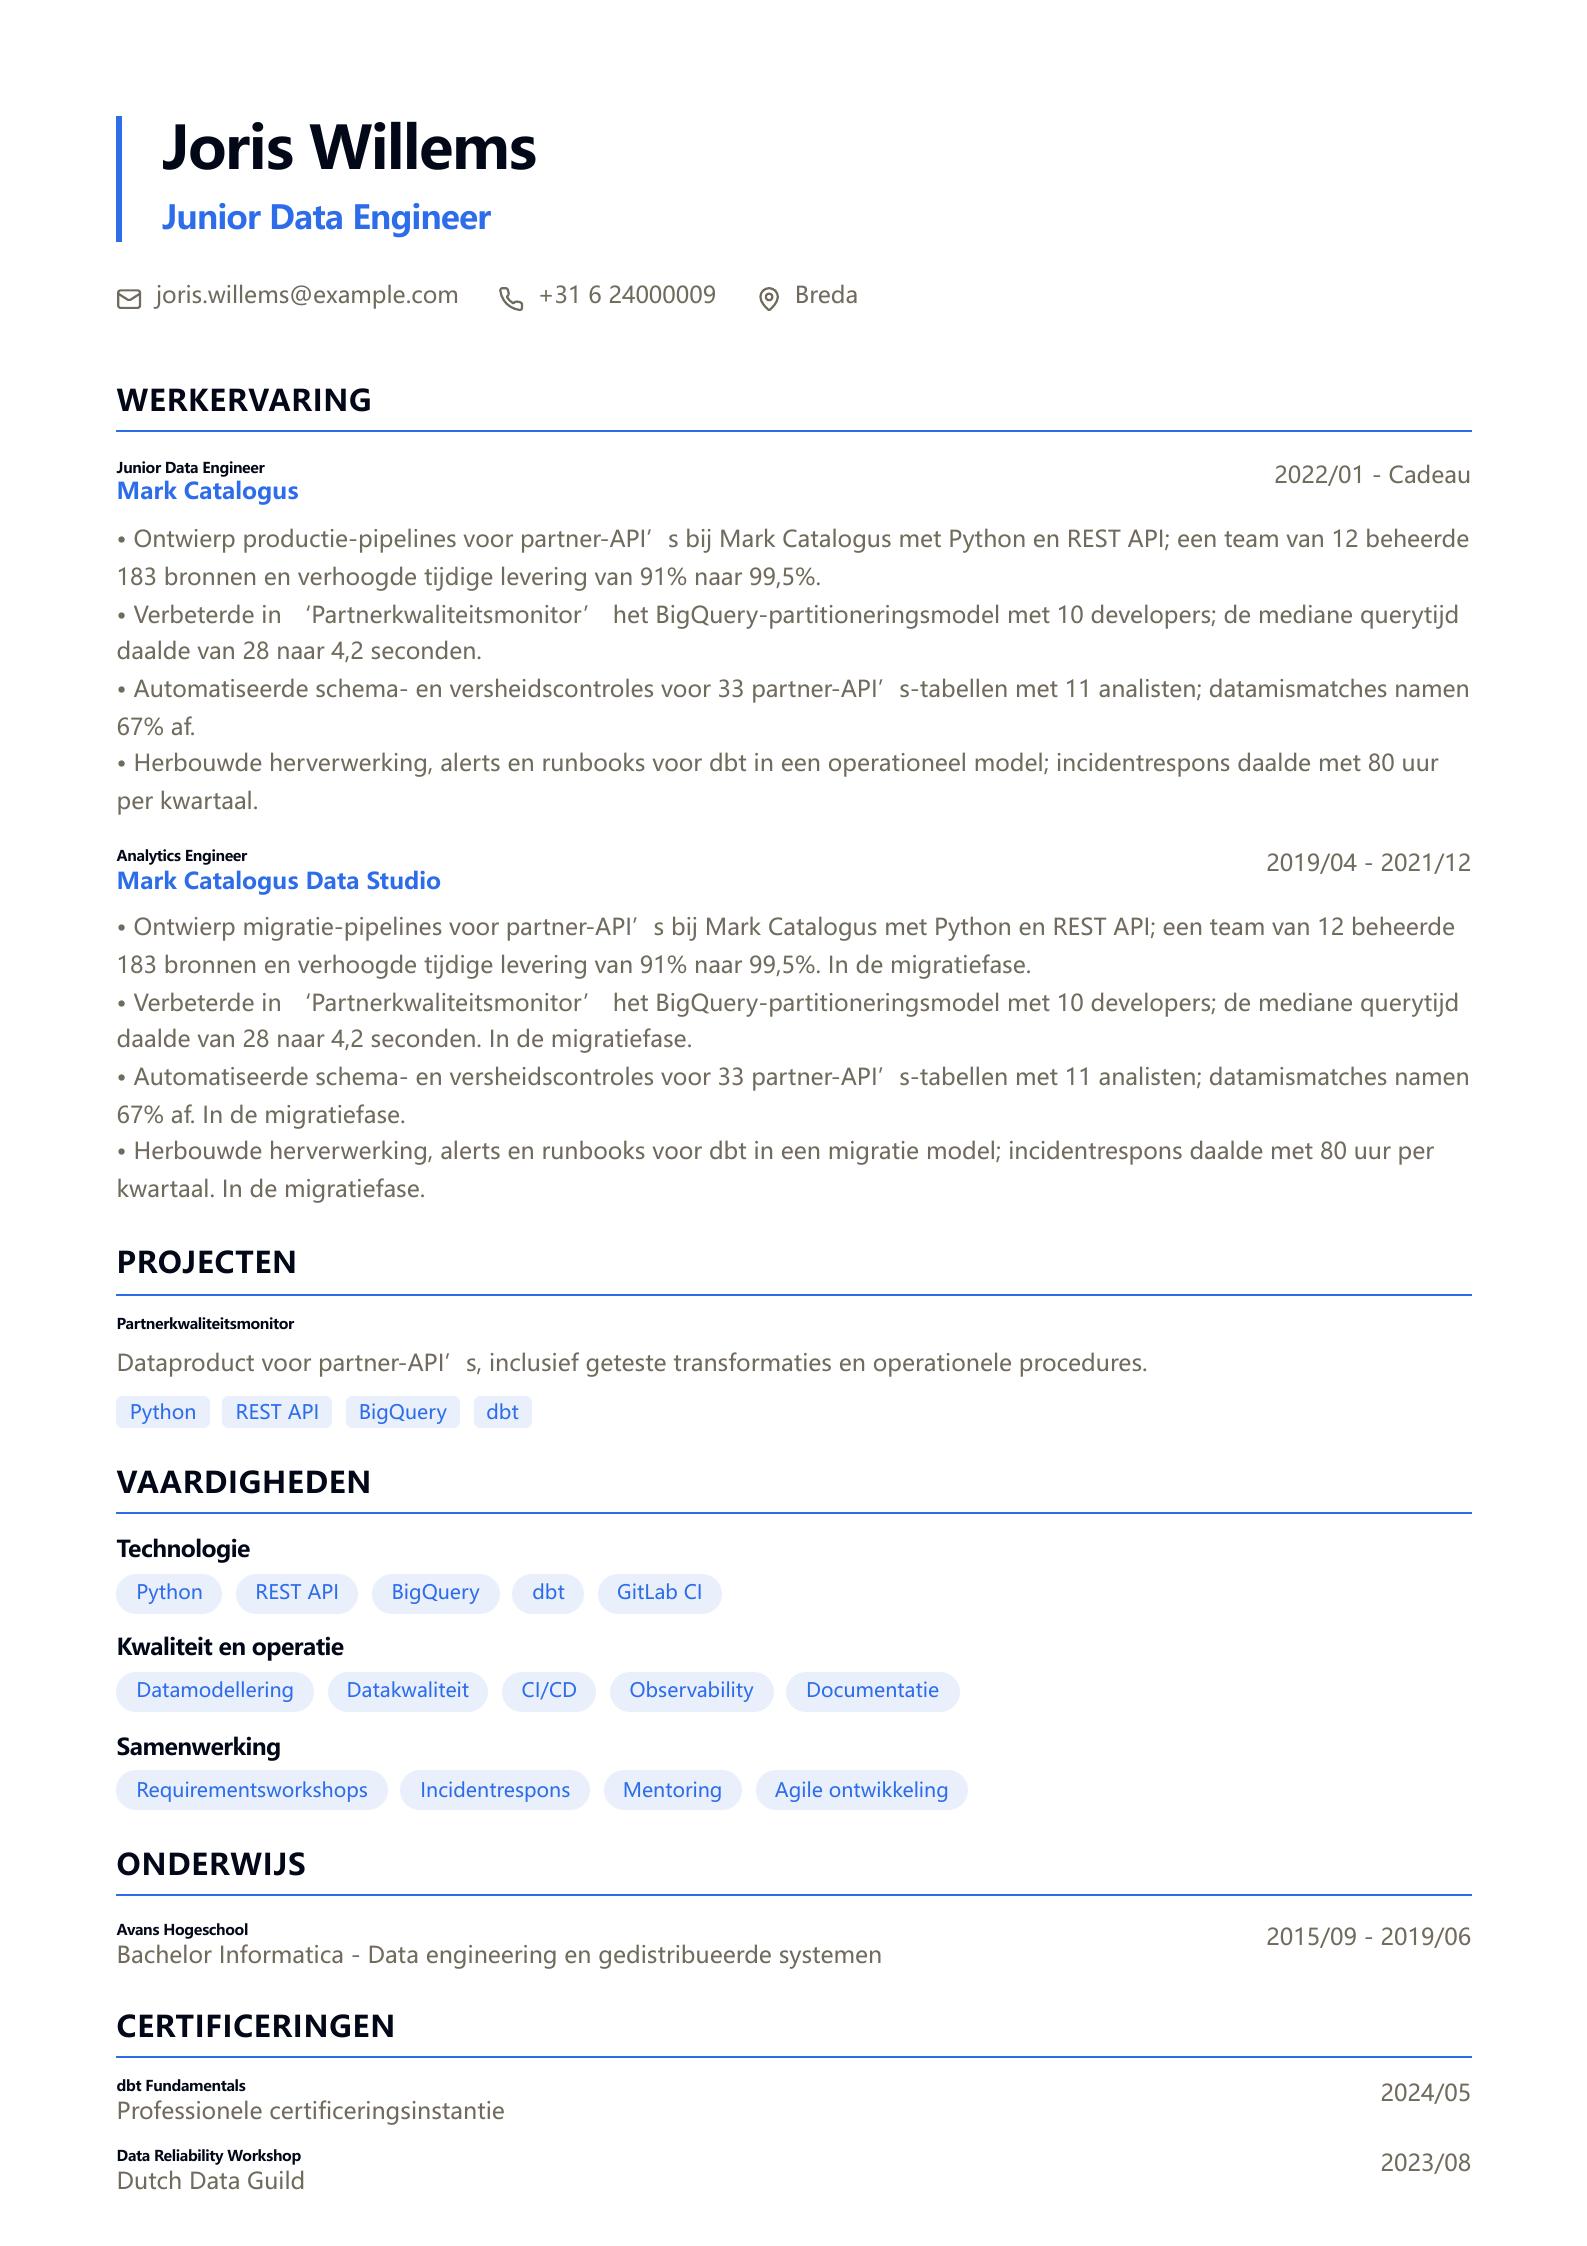
Nederlands cv-voorbeeld voor Junior Data Engineer, met pipeline-scope, samenwerking en meetbare resultaten.
Geschikt voor: Geschikt voor kandidaten voor Senior Data Engineer.
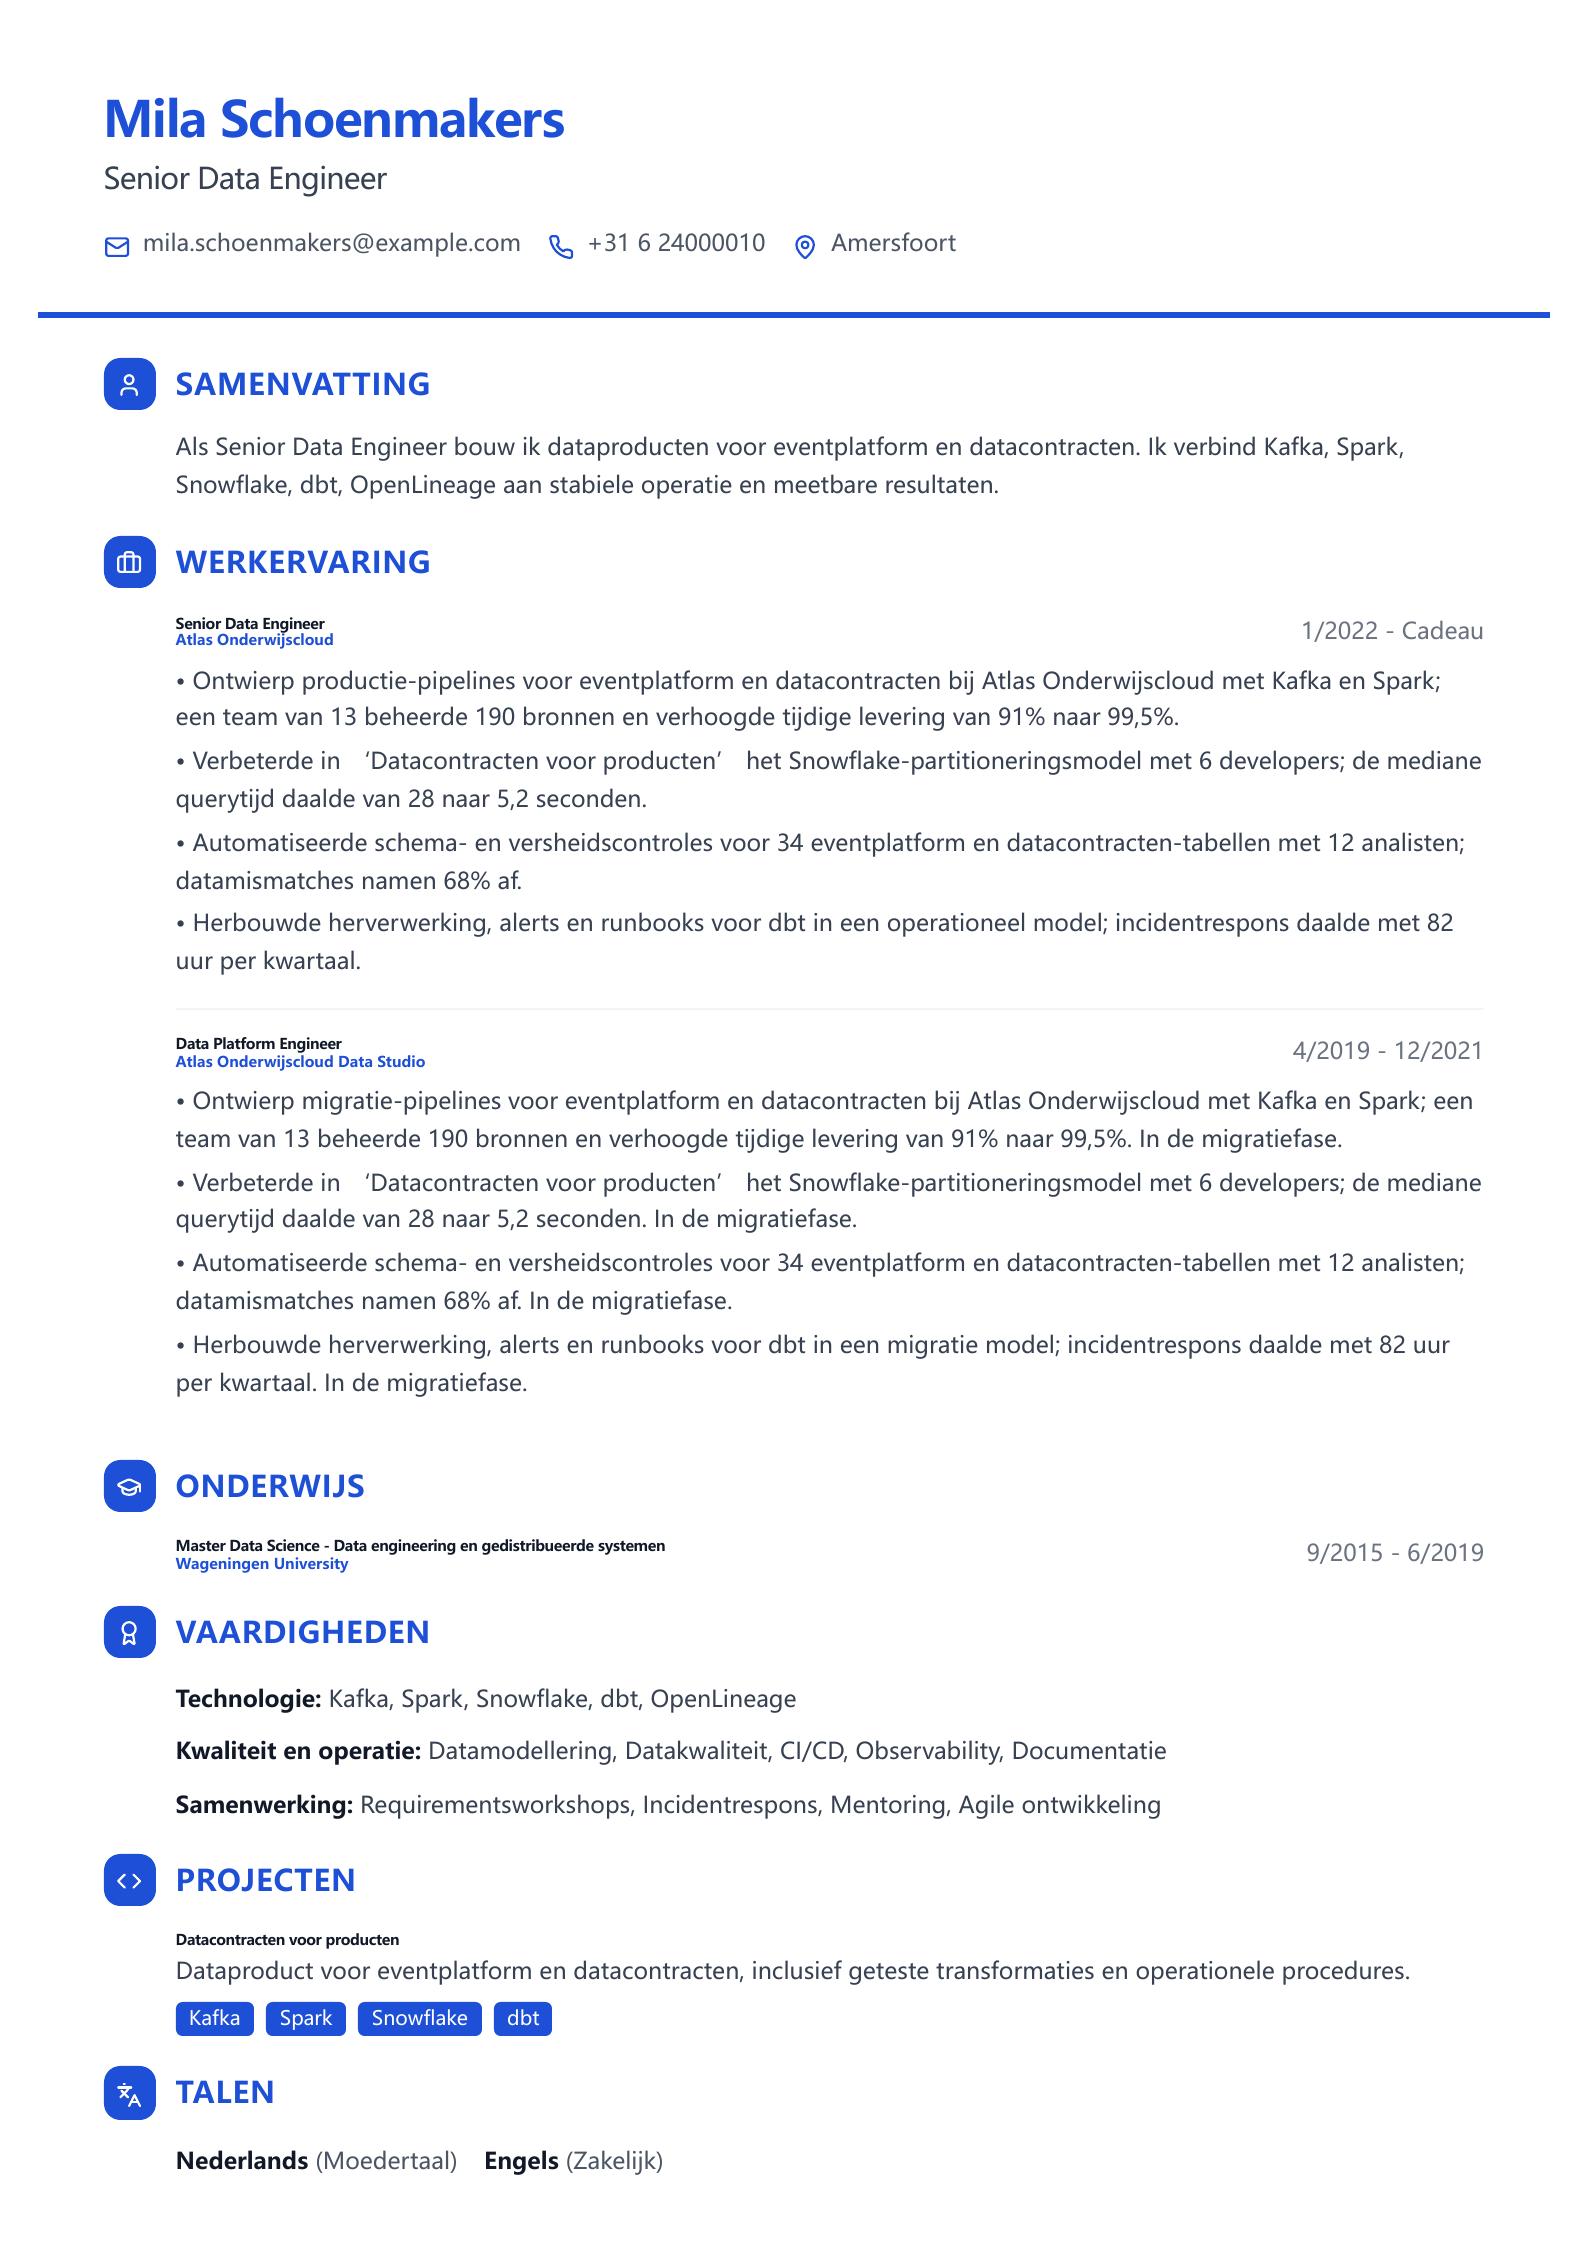
Nederlands cv-voorbeeld voor Senior Data Engineer, met pipeline-scope, samenwerking en meetbare resultaten.
Geschikt voor: Geschikt voor kandidaten voor Principal Data Engineer.
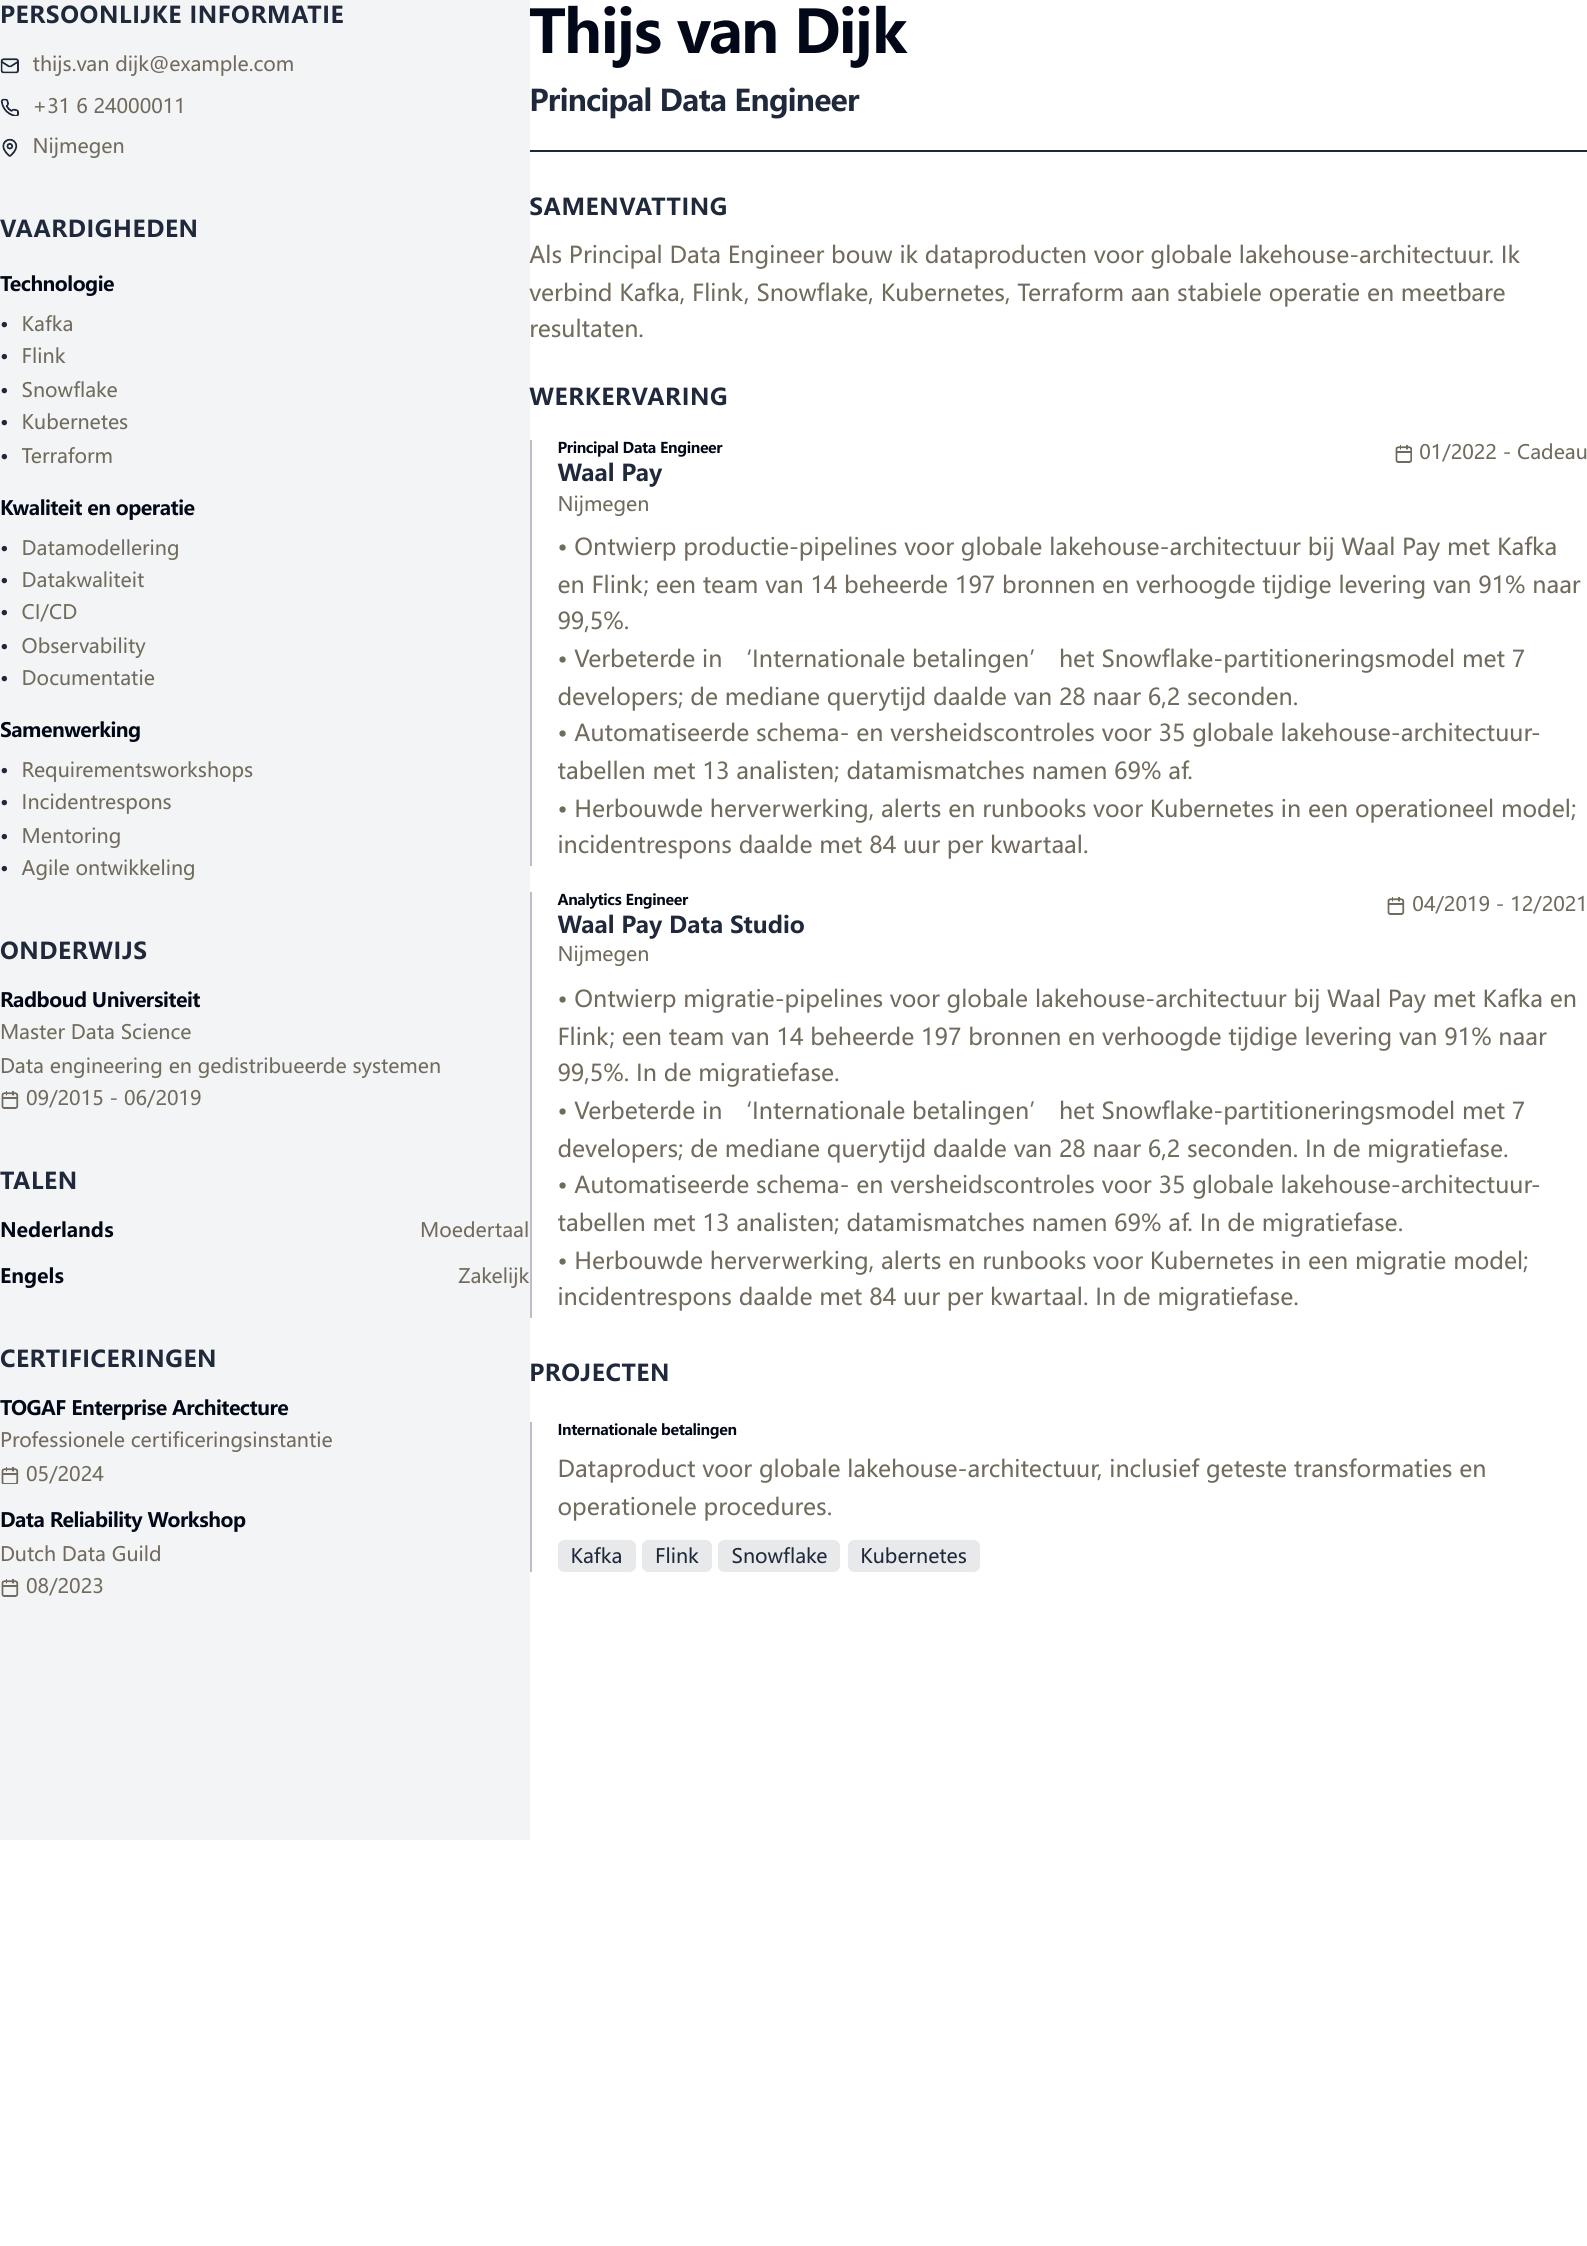
Nederlands cv-voorbeeld voor Principal Data Engineer, met pipeline-scope, samenwerking en meetbare resultaten.
Geschikt voor: Geschikt voor kandidaten voor PySpark Data Engineer.
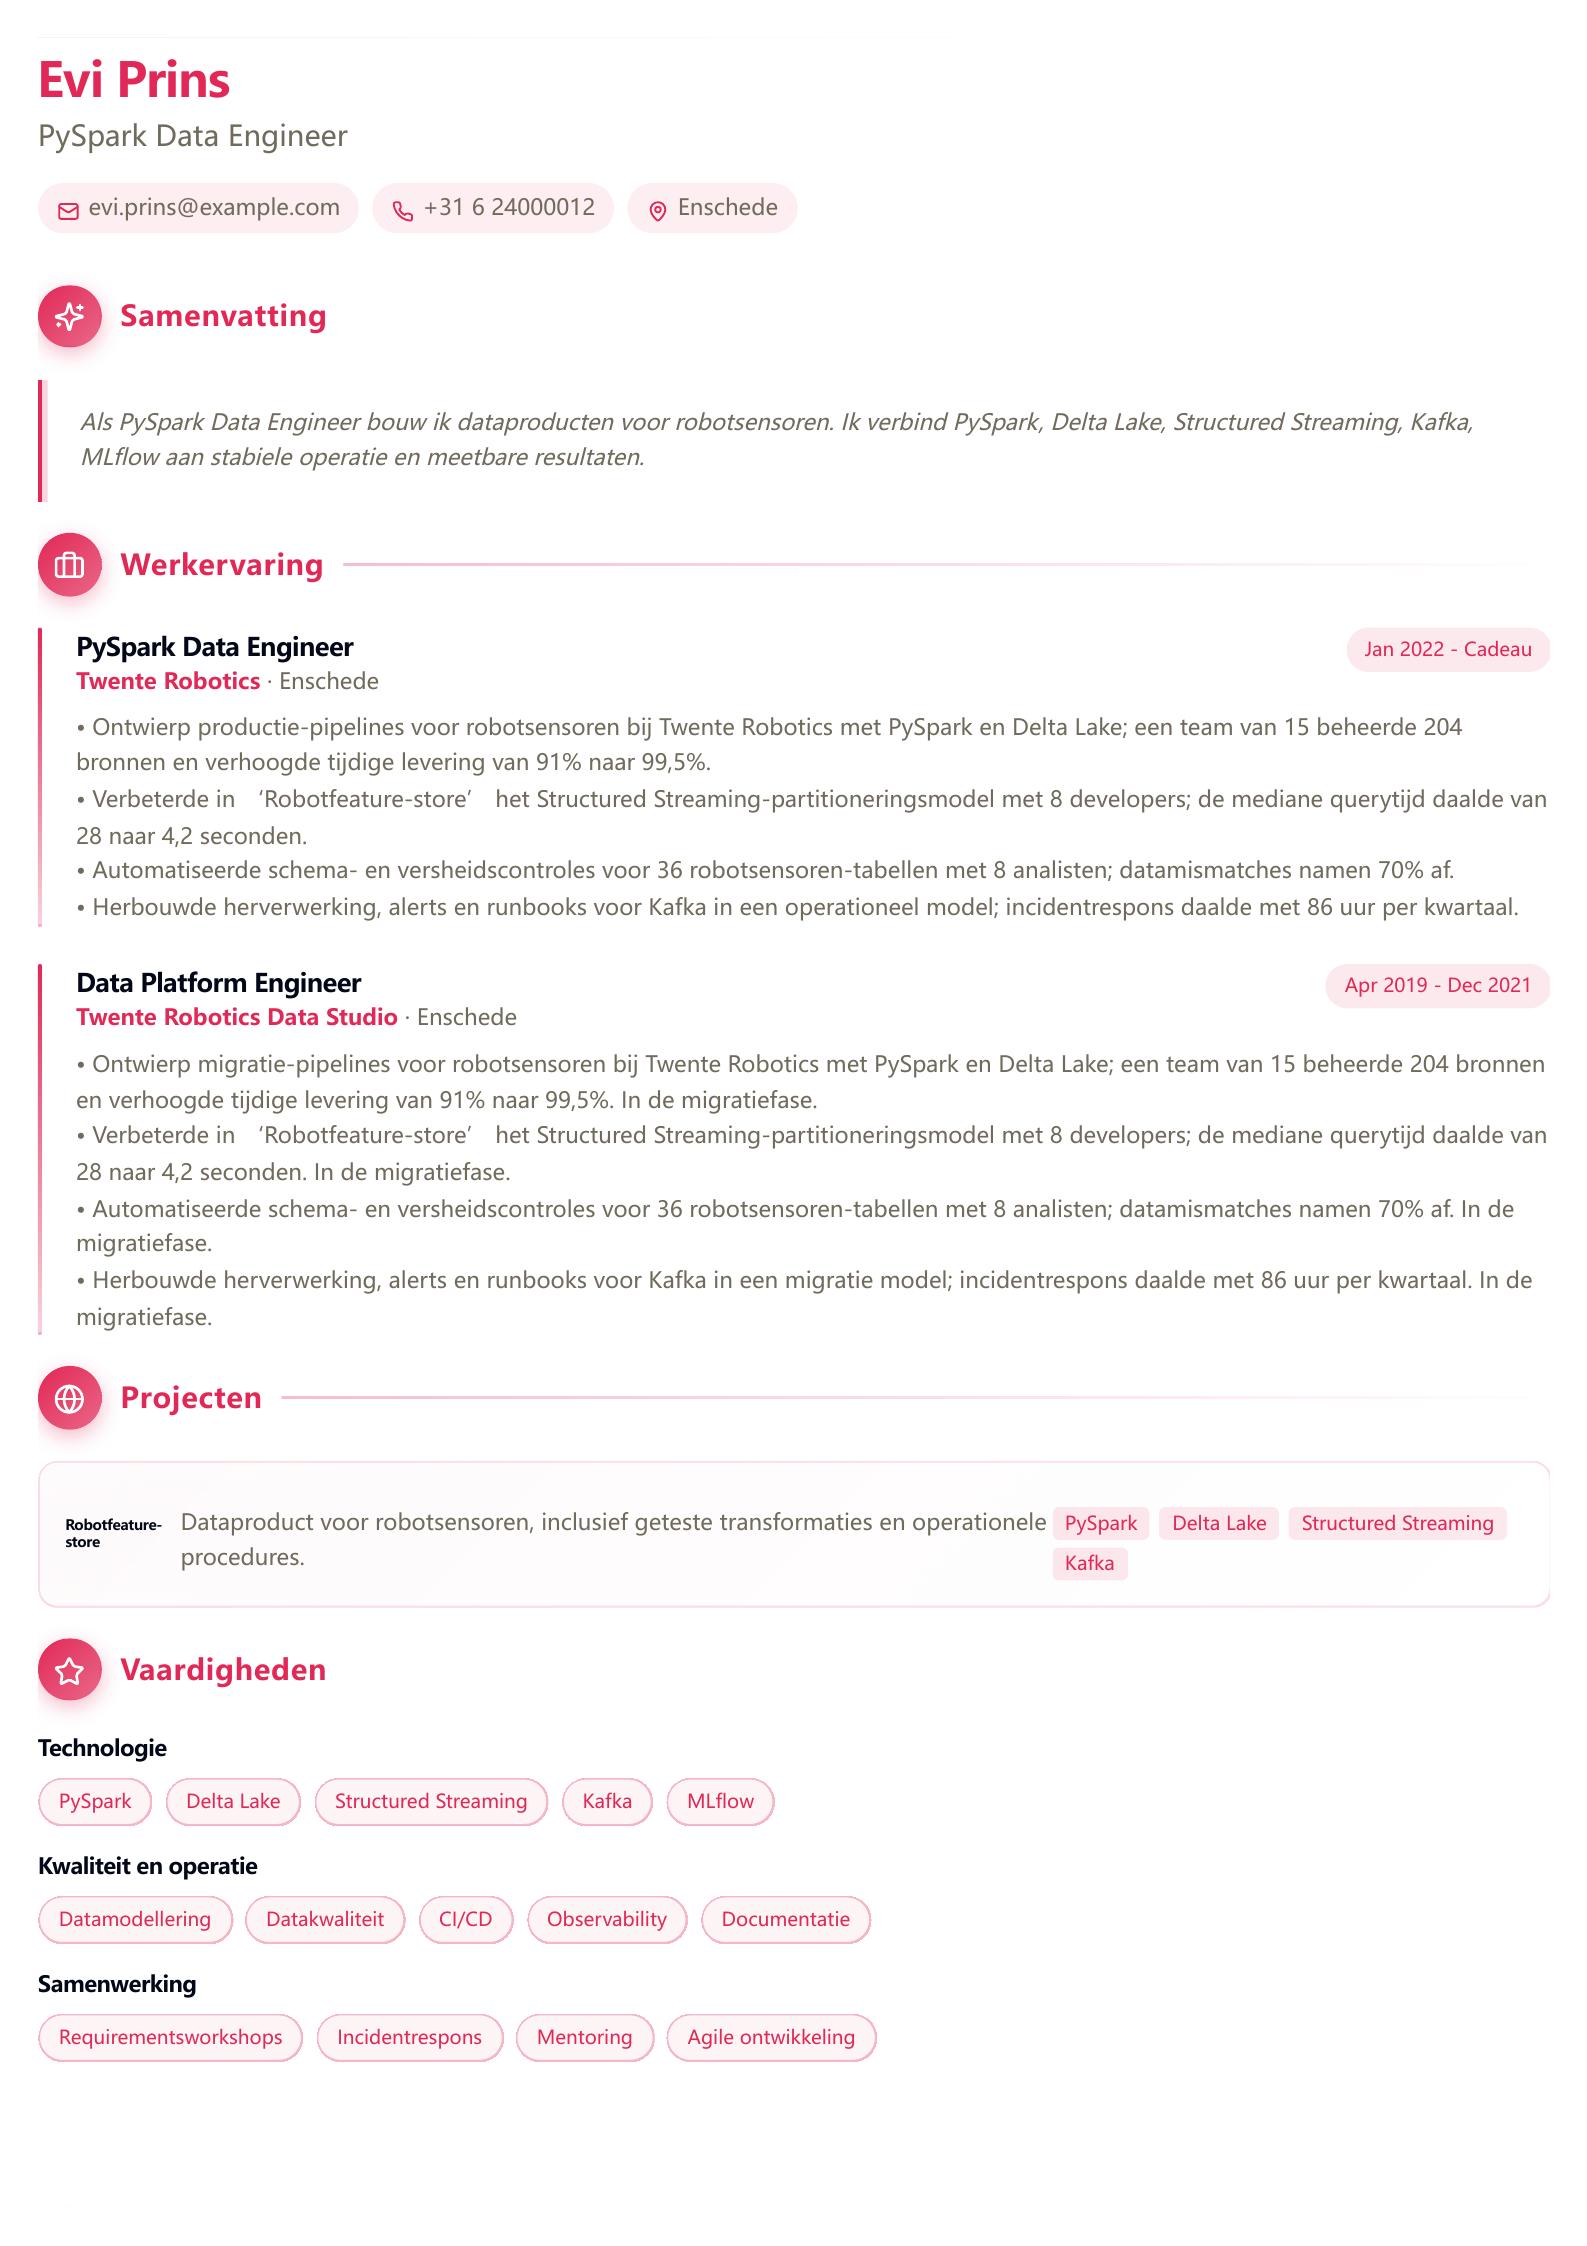
Nederlands cv-voorbeeld voor PySpark Data Engineer, met pipeline-scope, samenwerking en meetbare resultaten.
Geschikt voor: Geschikt voor kandidaten voor Python Data Engineer.
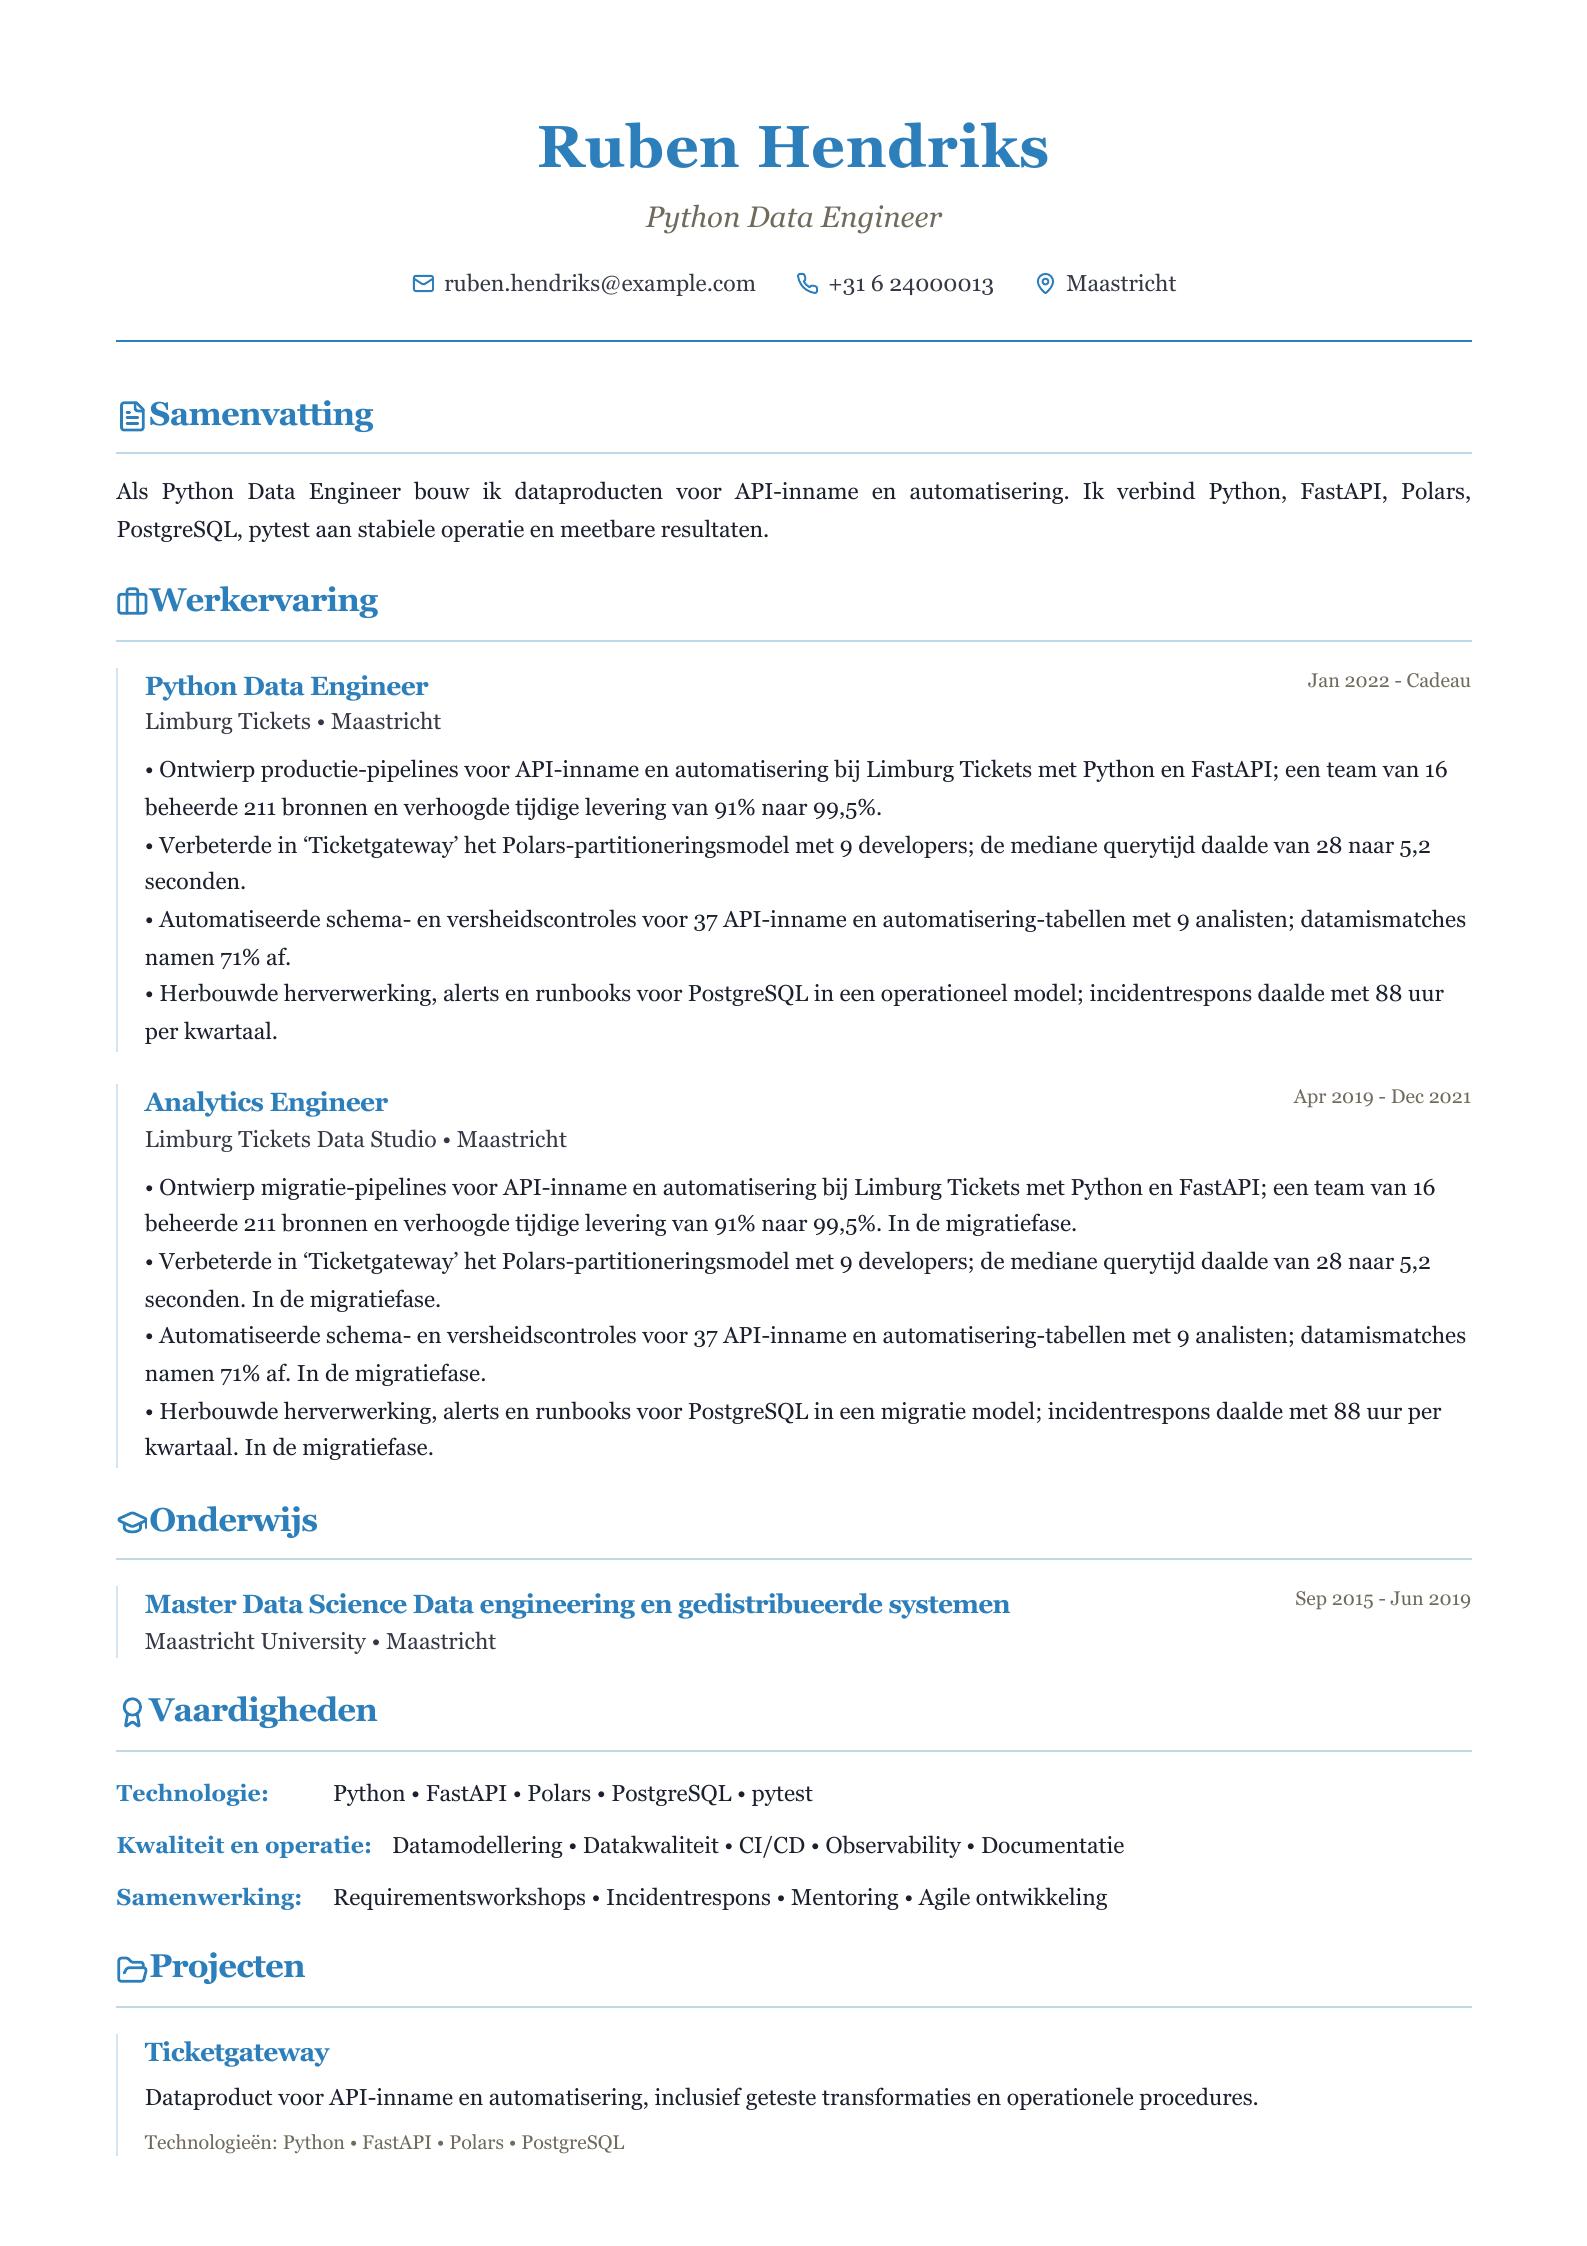
Nederlands cv-voorbeeld voor Python Data Engineer, met pipeline-scope, samenwerking en meetbare resultaten.
Geschikt voor: Geschikt voor kandidaten voor Social Platform Data Engineer.
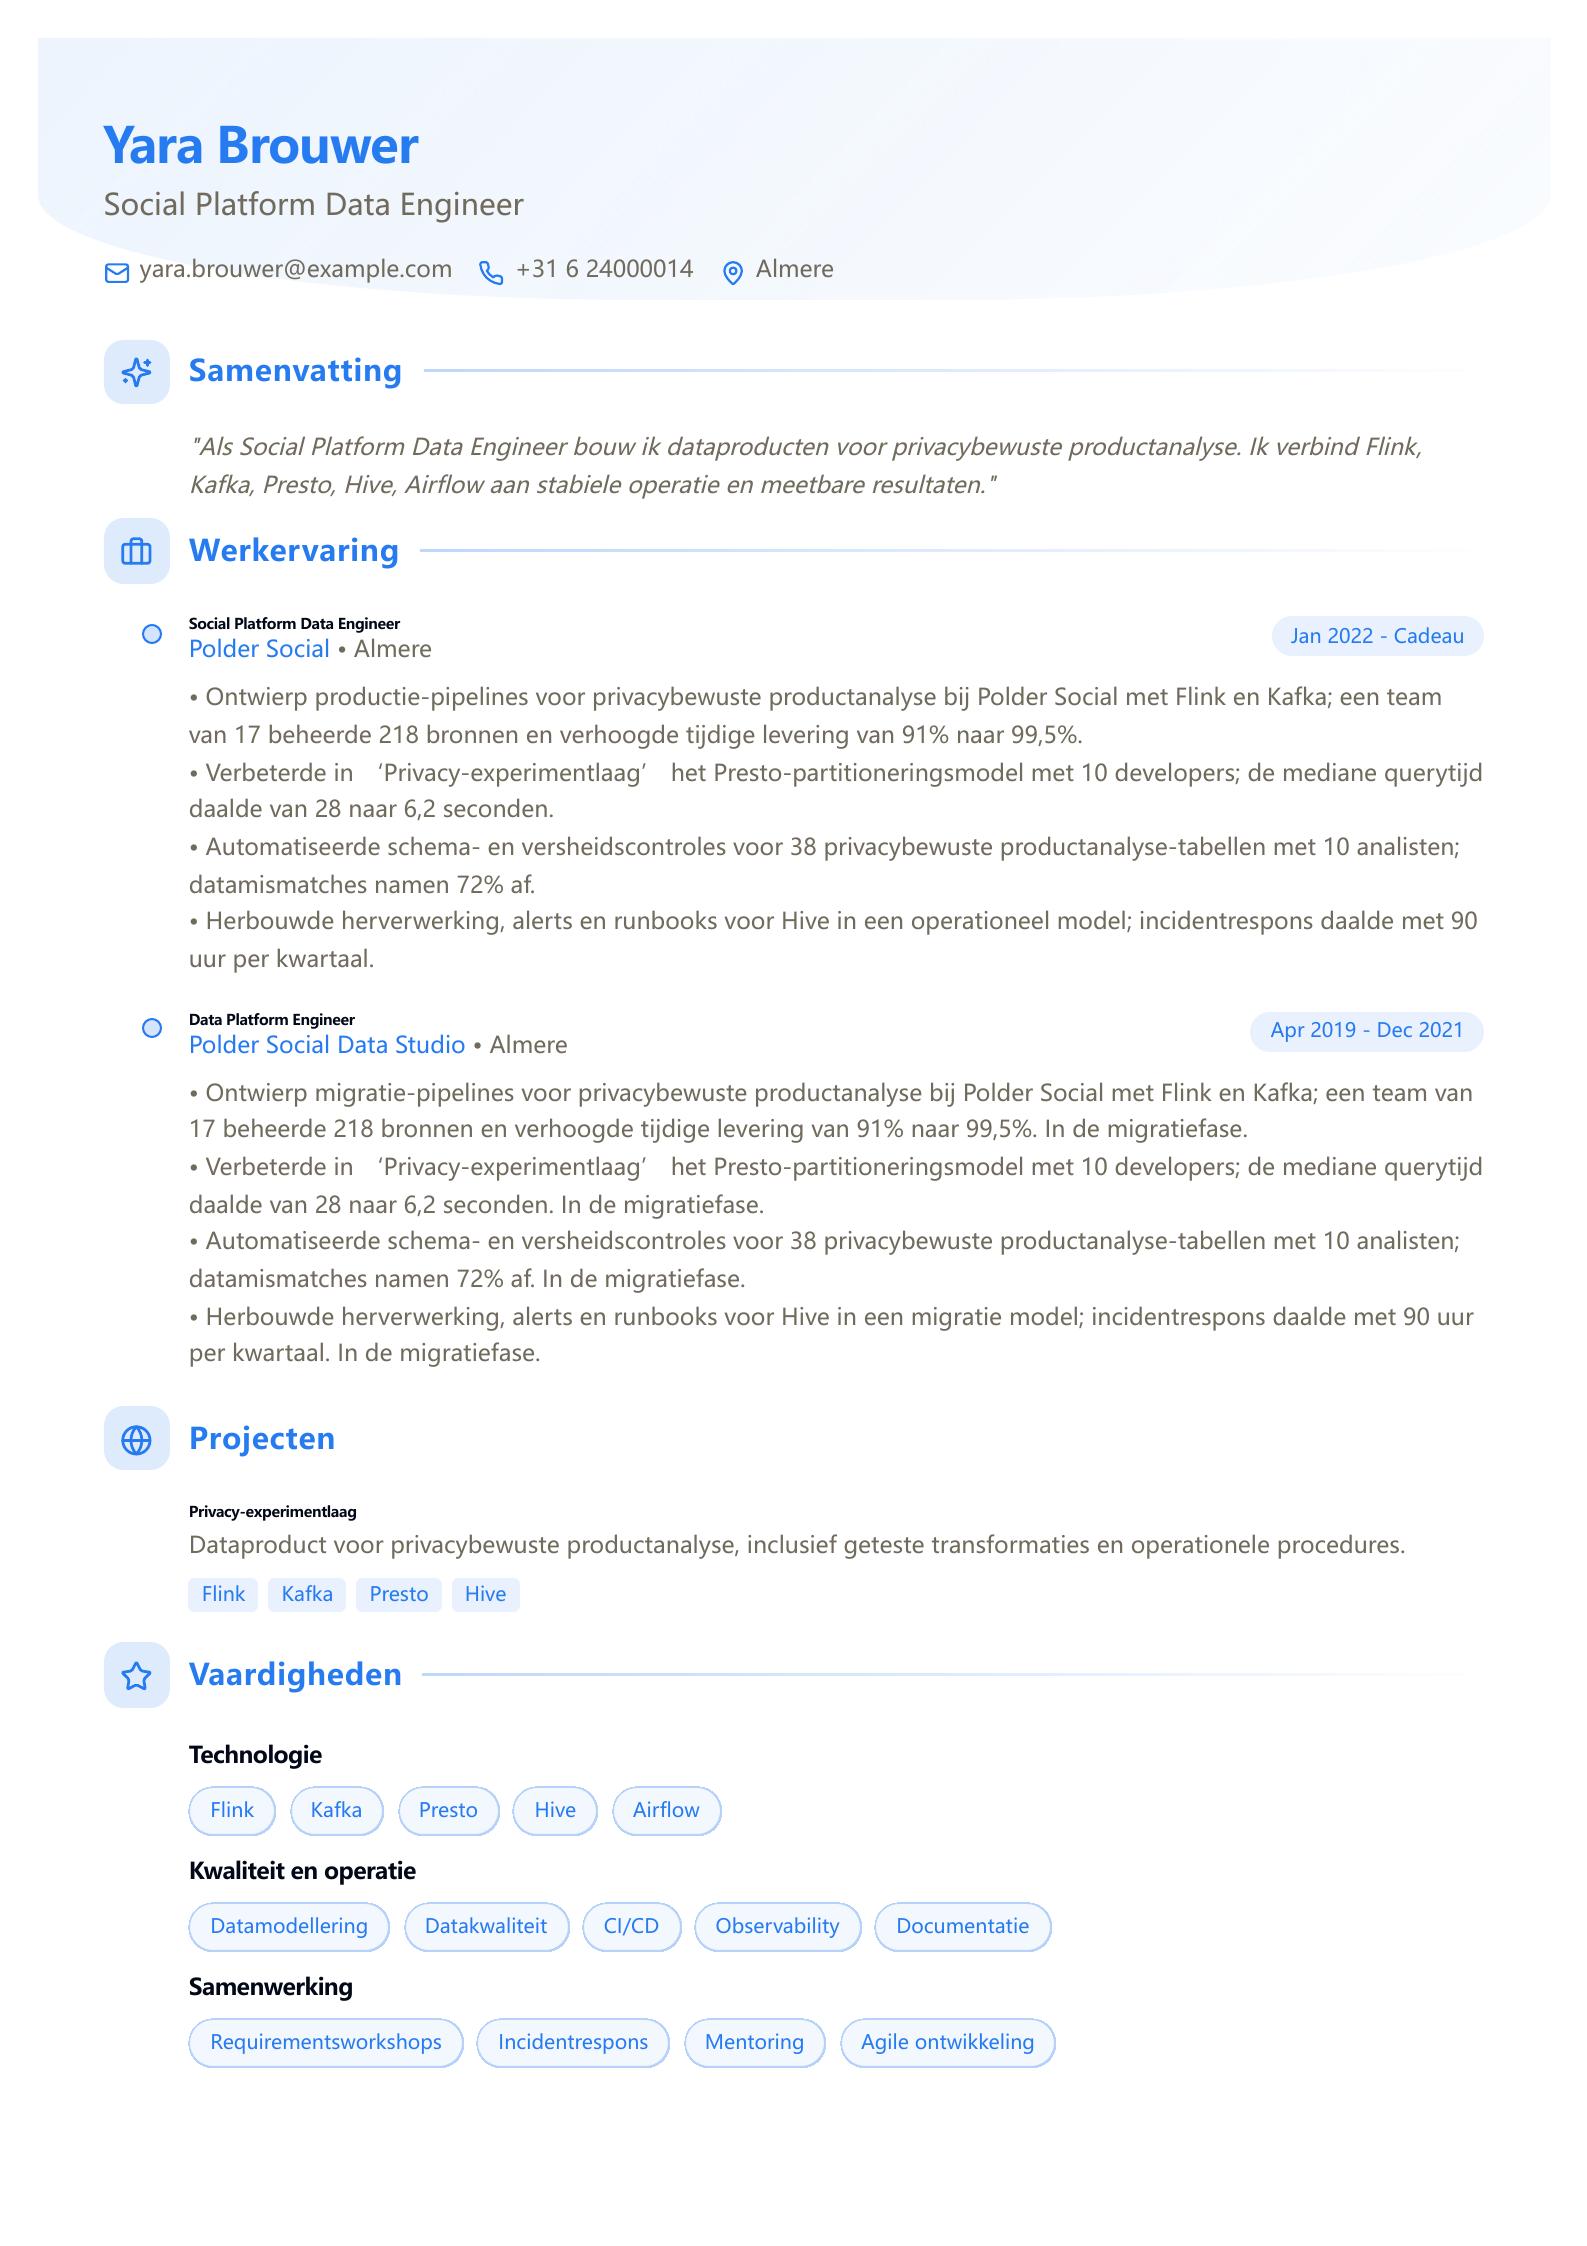
Nederlands cv-voorbeeld voor Social Platform Data Engineer, met pipeline-scope, samenwerking en meetbare resultaten.
Geschikt voor: Geschikt voor kandidaten voor Data Analytics Engineer.
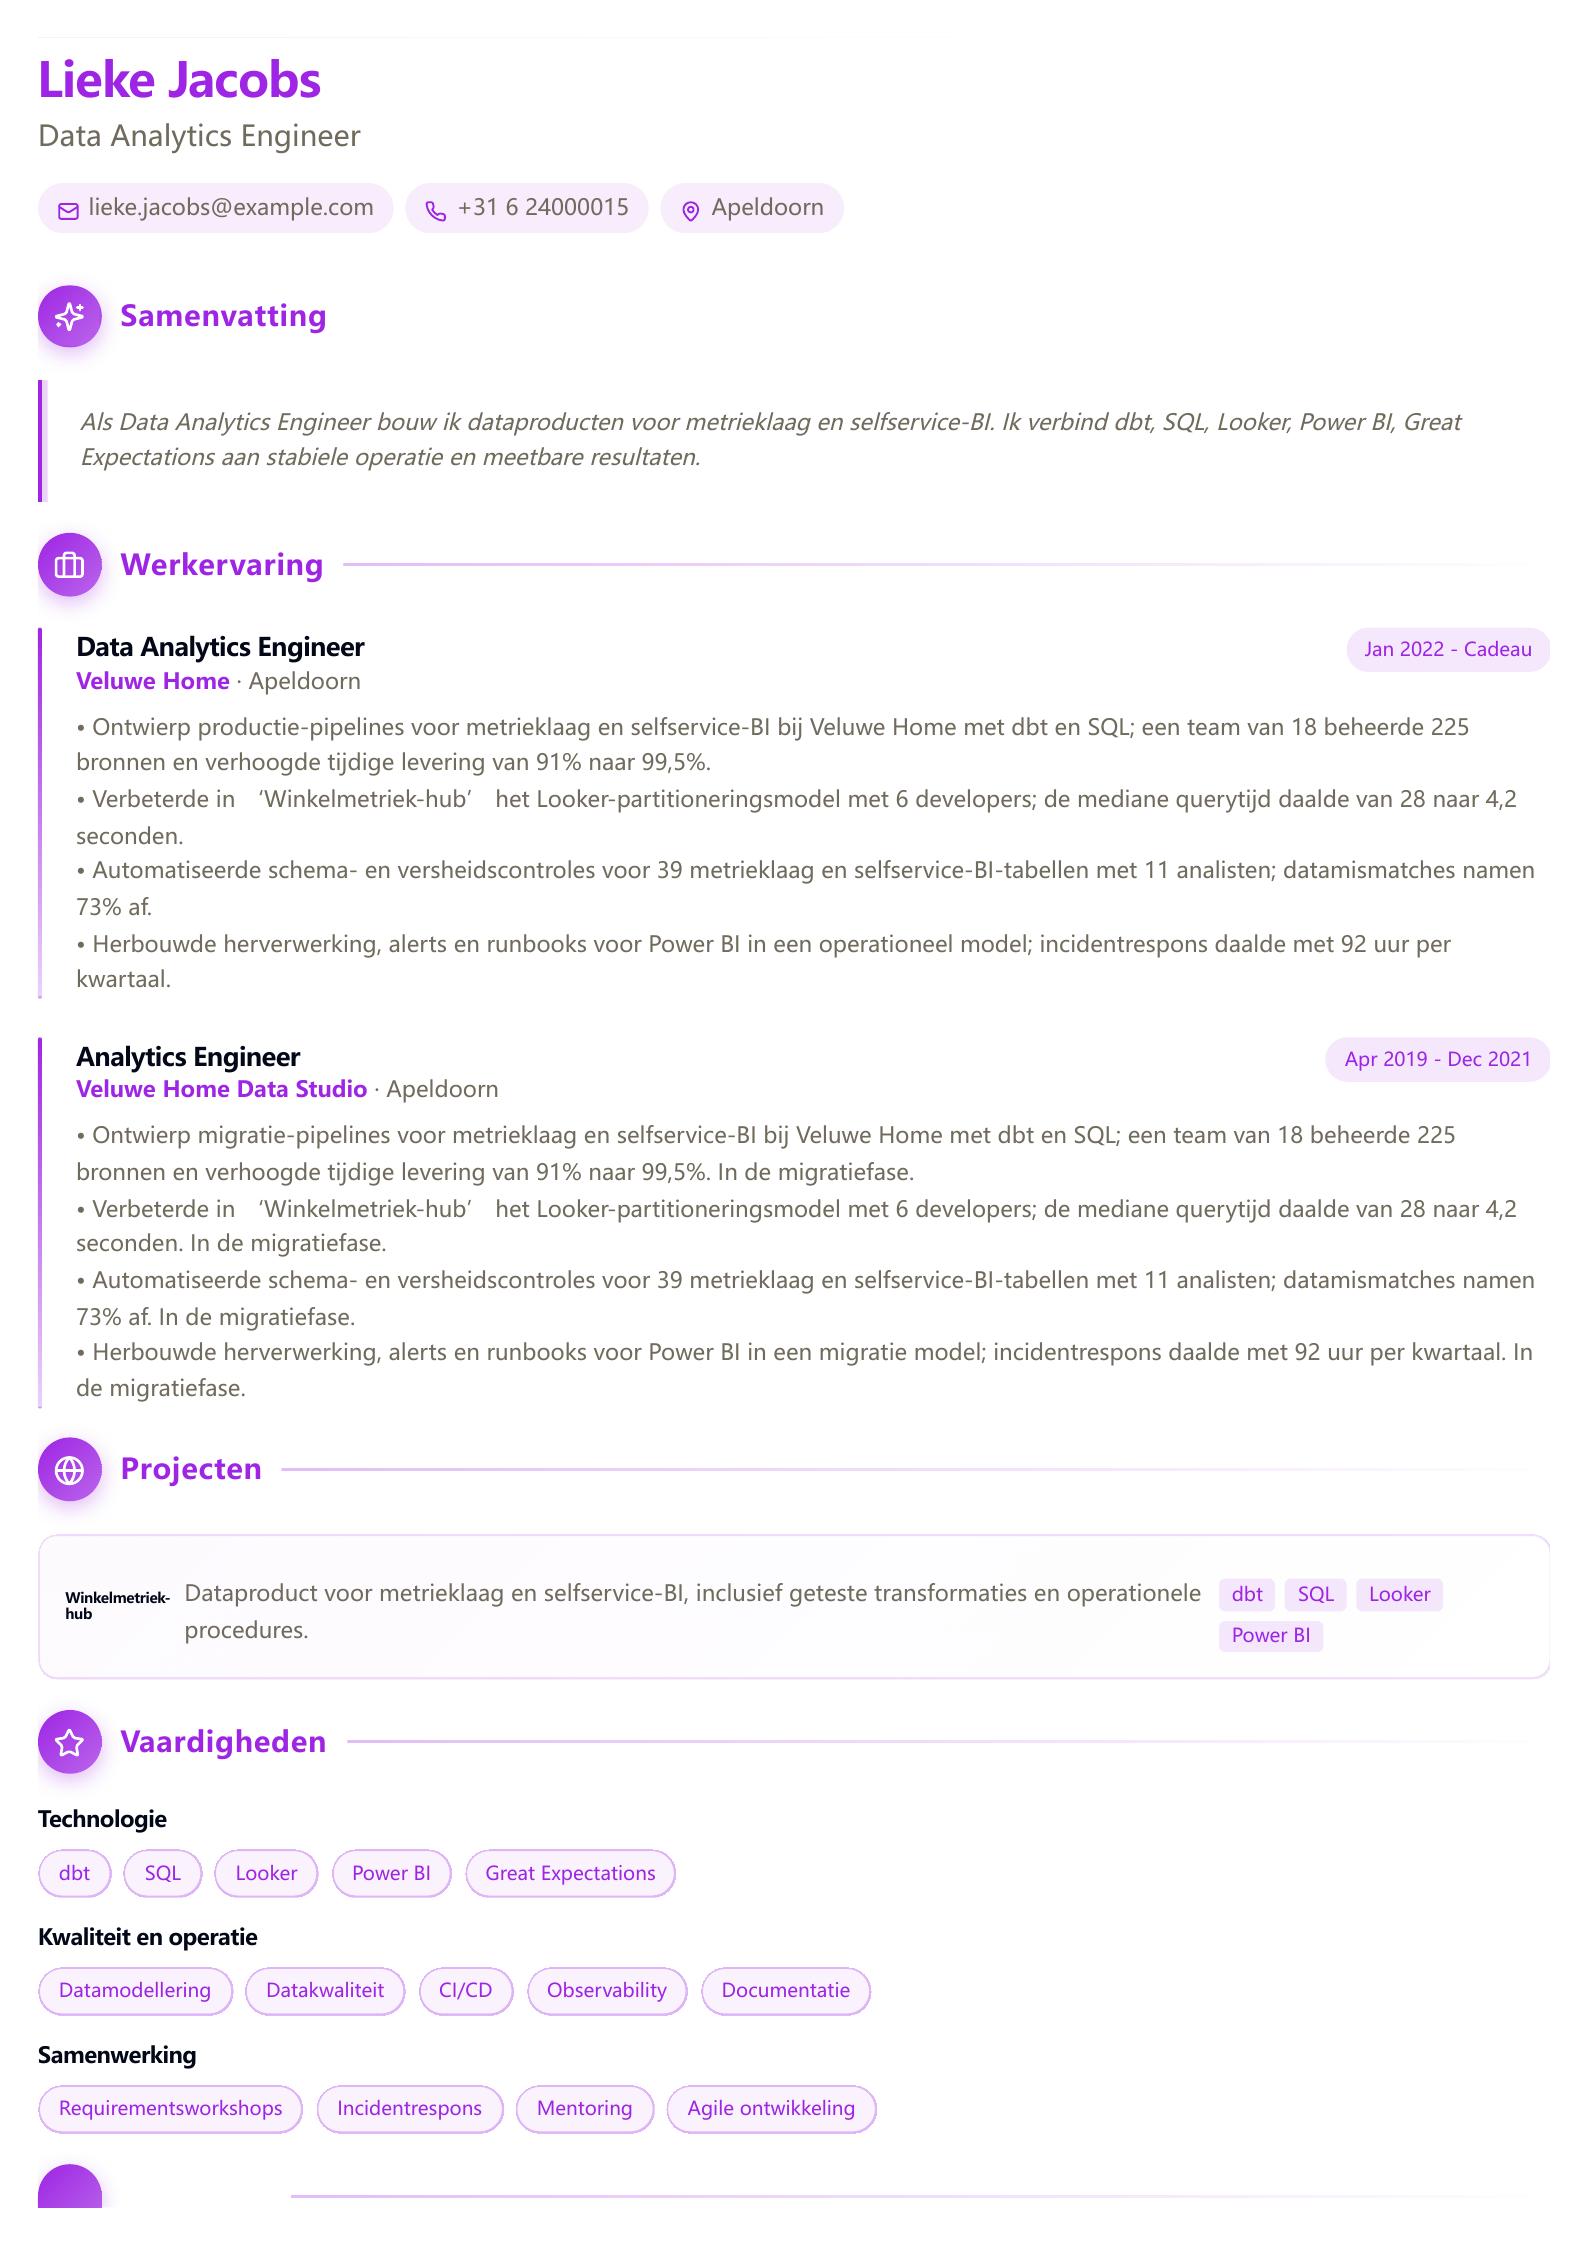
Nederlands cv-voorbeeld voor Data Analytics Engineer, met pipeline-scope, samenwerking en meetbare resultaten.
Geschikt voor: Geschikt voor kandidaten voor ETL Data Engineer.
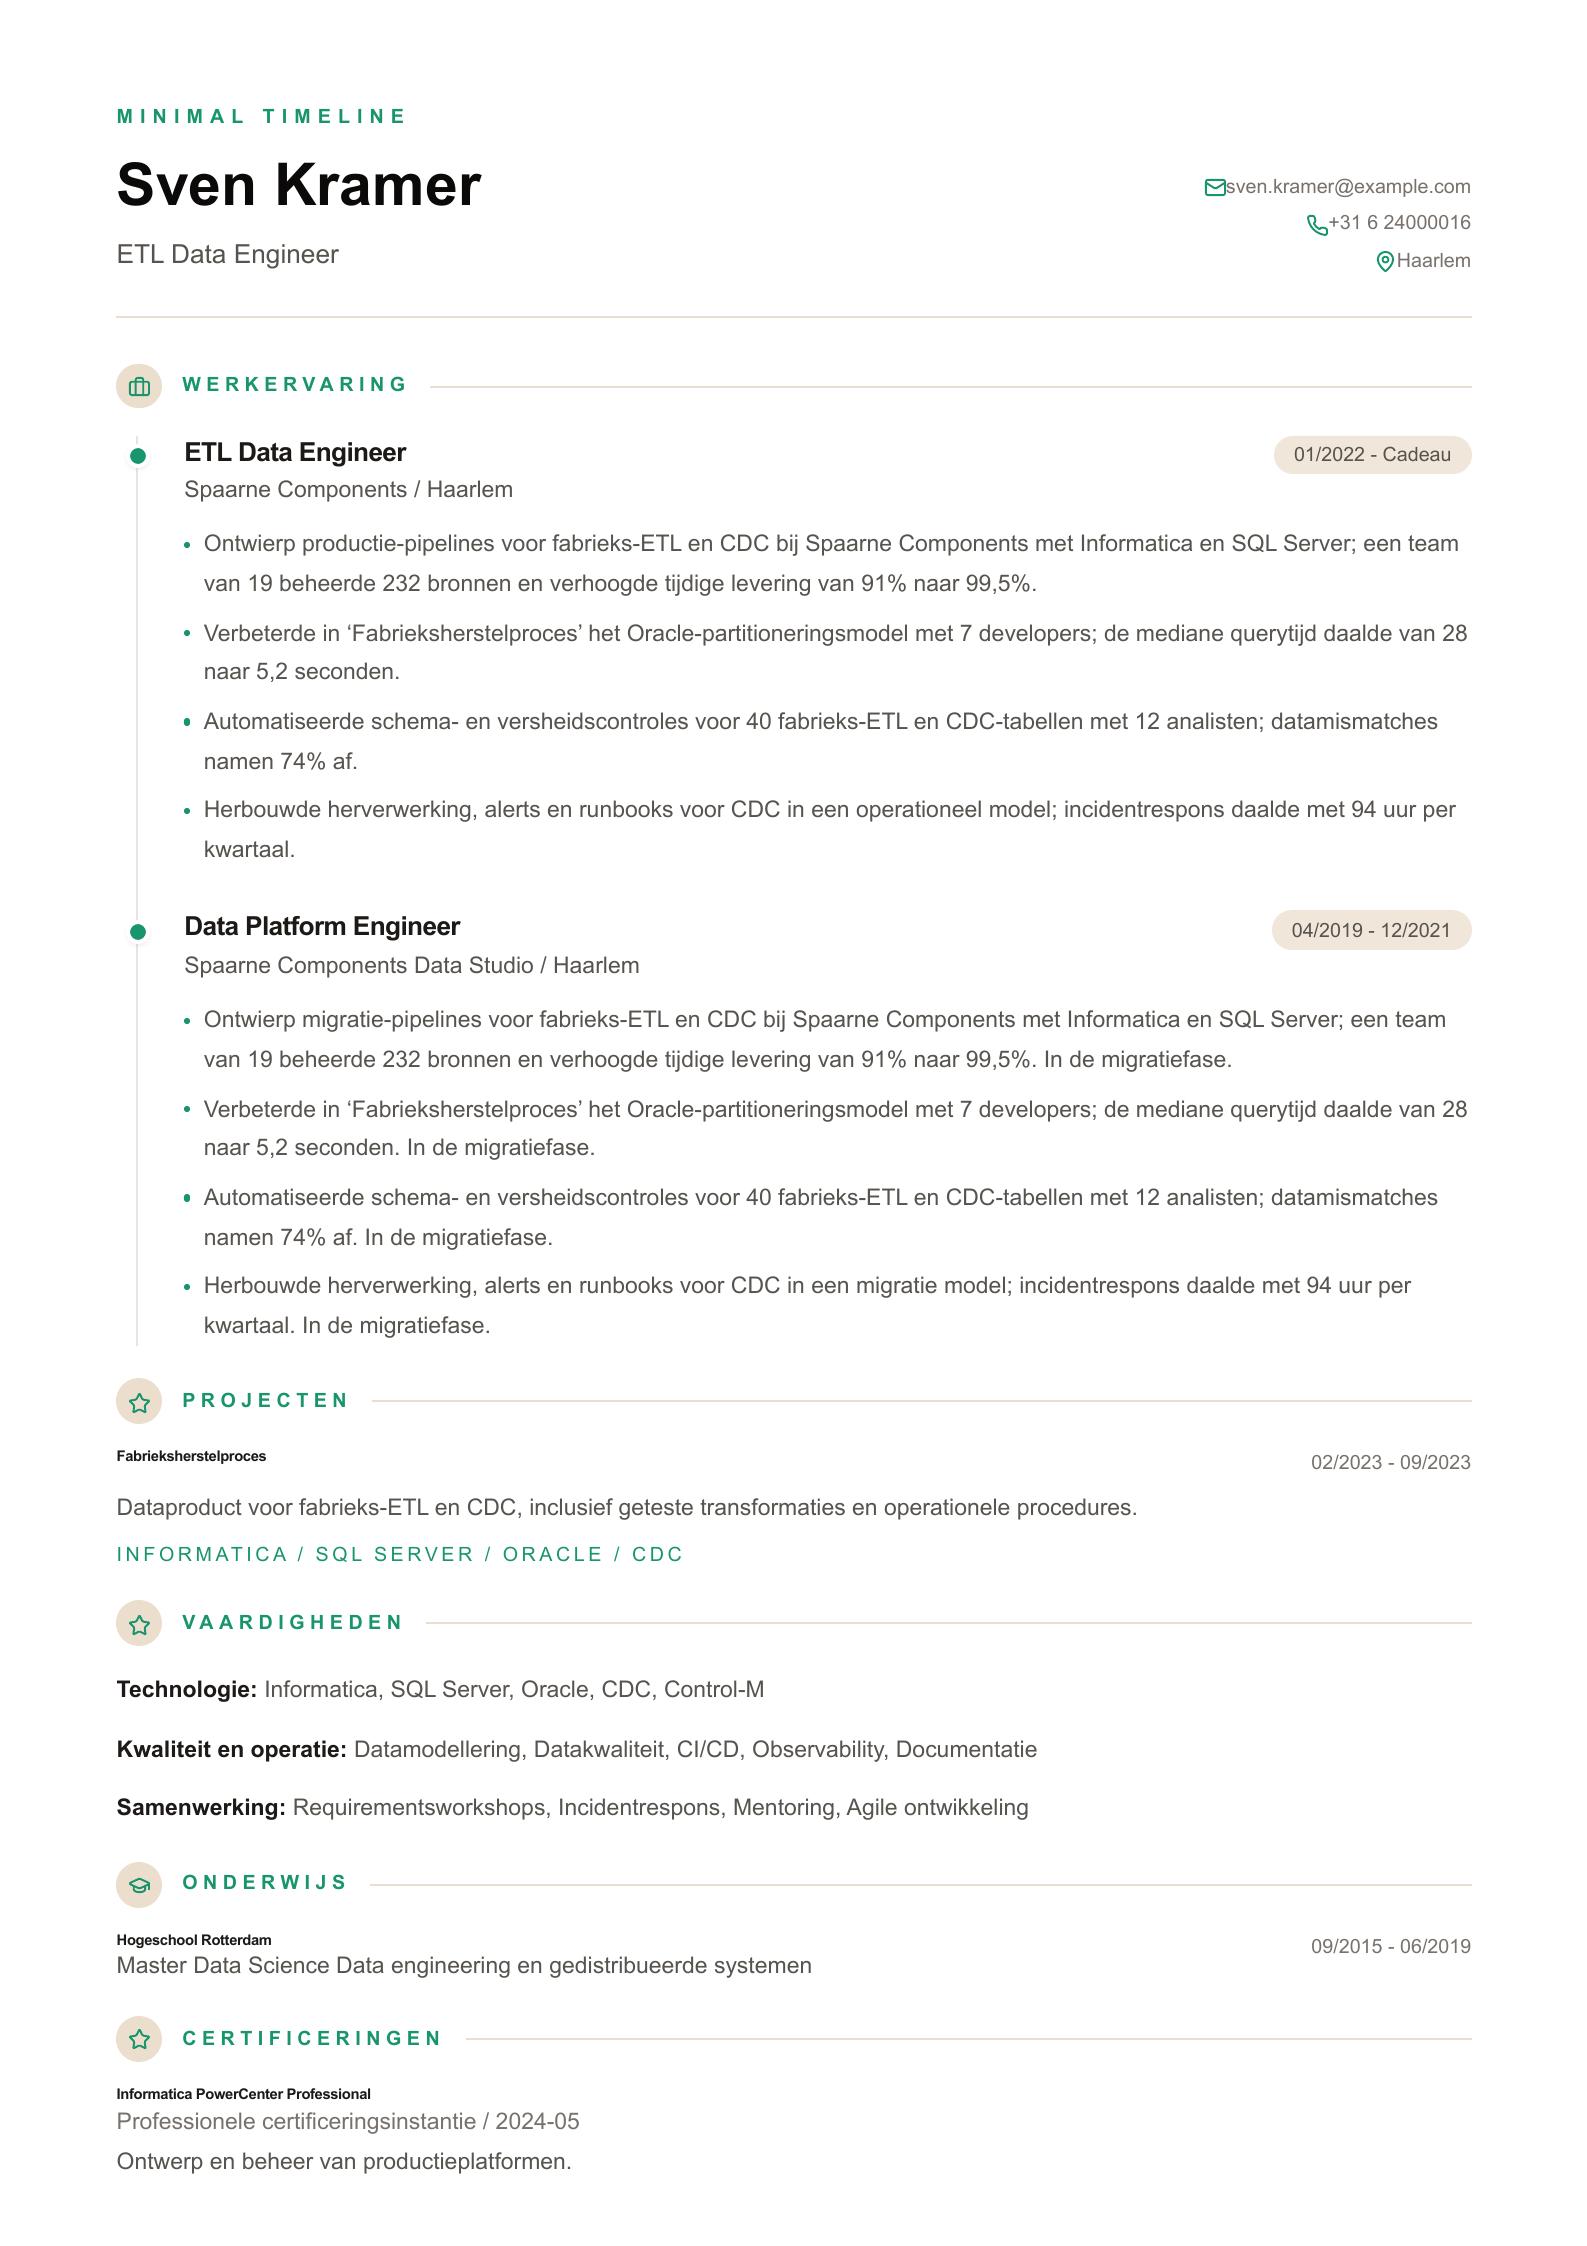
Nederlands cv-voorbeeld voor ETL Data Engineer, met pipeline-scope, samenwerking en meetbare resultaten.
Geschikt voor: Geschikt voor kandidaten voor Computer Vision Data Engineer.
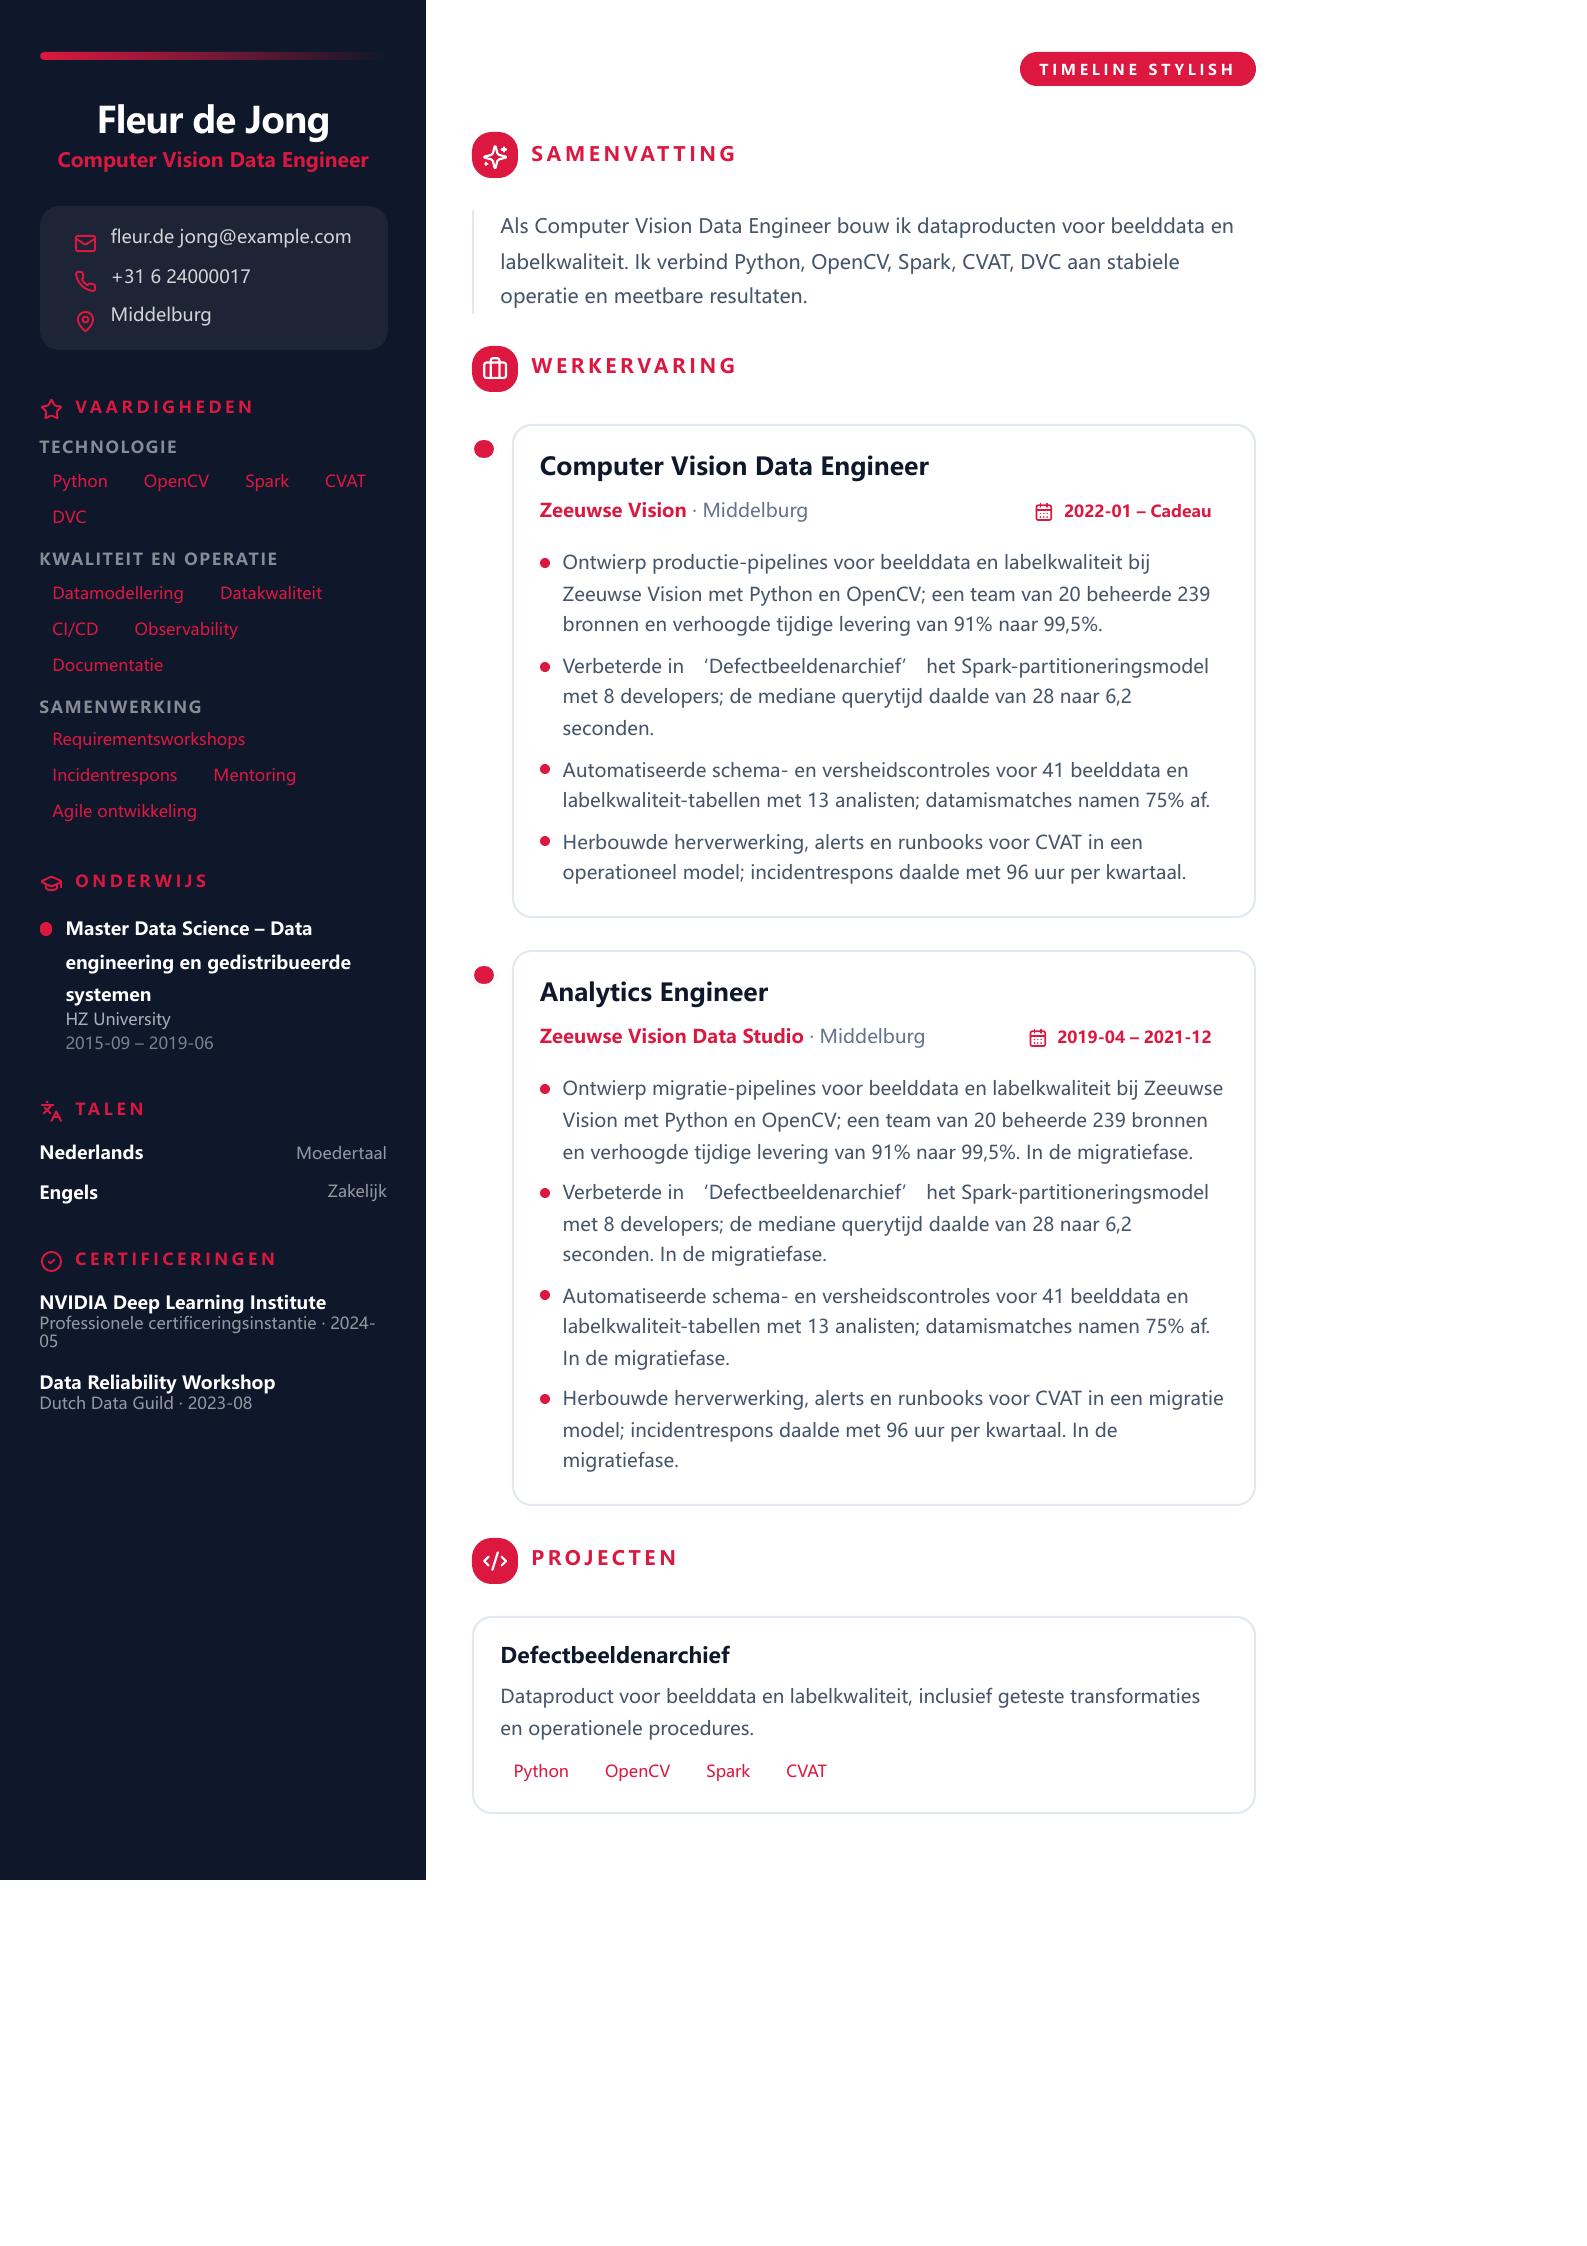
Nederlands cv-voorbeeld voor Computer Vision Data Engineer, met pipeline-scope, samenwerking en meetbare resultaten.
Noem eerst de verbetering in verwerkingstijd, versheid, foutpercentage, kosten of stabiliteit en leg daarna uit welk systeem je veranderde.
Noem niet alleen producten. Beschrijf partitionering, incremental modellen, CDC, datacontracten, orkestratie, toegangsbeheer, backfills en monitoring.
Vermeld bronnen, tabellen, rijen, markten, gebruikers en teamgrootte zodat de omvang van het werk duidelijk wordt.
Noteer de waarde voor en na de wijziging en de meetperiode. Gebruik alleen cijfers die je tijdens een gesprek kunt onderbouwen.
Voorbeeld van een goede bullet
• Introduceerde incrementele Spark-verwerking voor 180.000 URL's, samen met 8 developers en 3 analisten. De mediane indexupdate ging van 52 naar 17 minuten en foutieve rijen van 2,8% naar 0,4%.
Aan het begin van je loopbaan is één pagina vaak genoeg. Gebruik twee pagina's als je meerdere clouds, platformverantwoordelijkheid of technische leiding moet toelichten.
Noem talen, orkestratie, opslag, verwerkingsengines, cloud en kwaliteitstools die je echt in productie gebruikte. Koppel ze aan concrete bullets.
Gebruik cijfers wanneer je de bron kunt uitleggen. Datavolume, latency, kosten, foutpercentage, doorlooptijd en testdekking zijn bruikbare maatstaven.
Ja. Open een voorbeeld in de editor en vervang de fictieve gegevens door je eigen ervaring. Houd de volgorde probleem, actie, schaal en resultaat aan.