CV inżyniera danych
Przyda się przy: pipeline’y, modelowanie i niezawodność
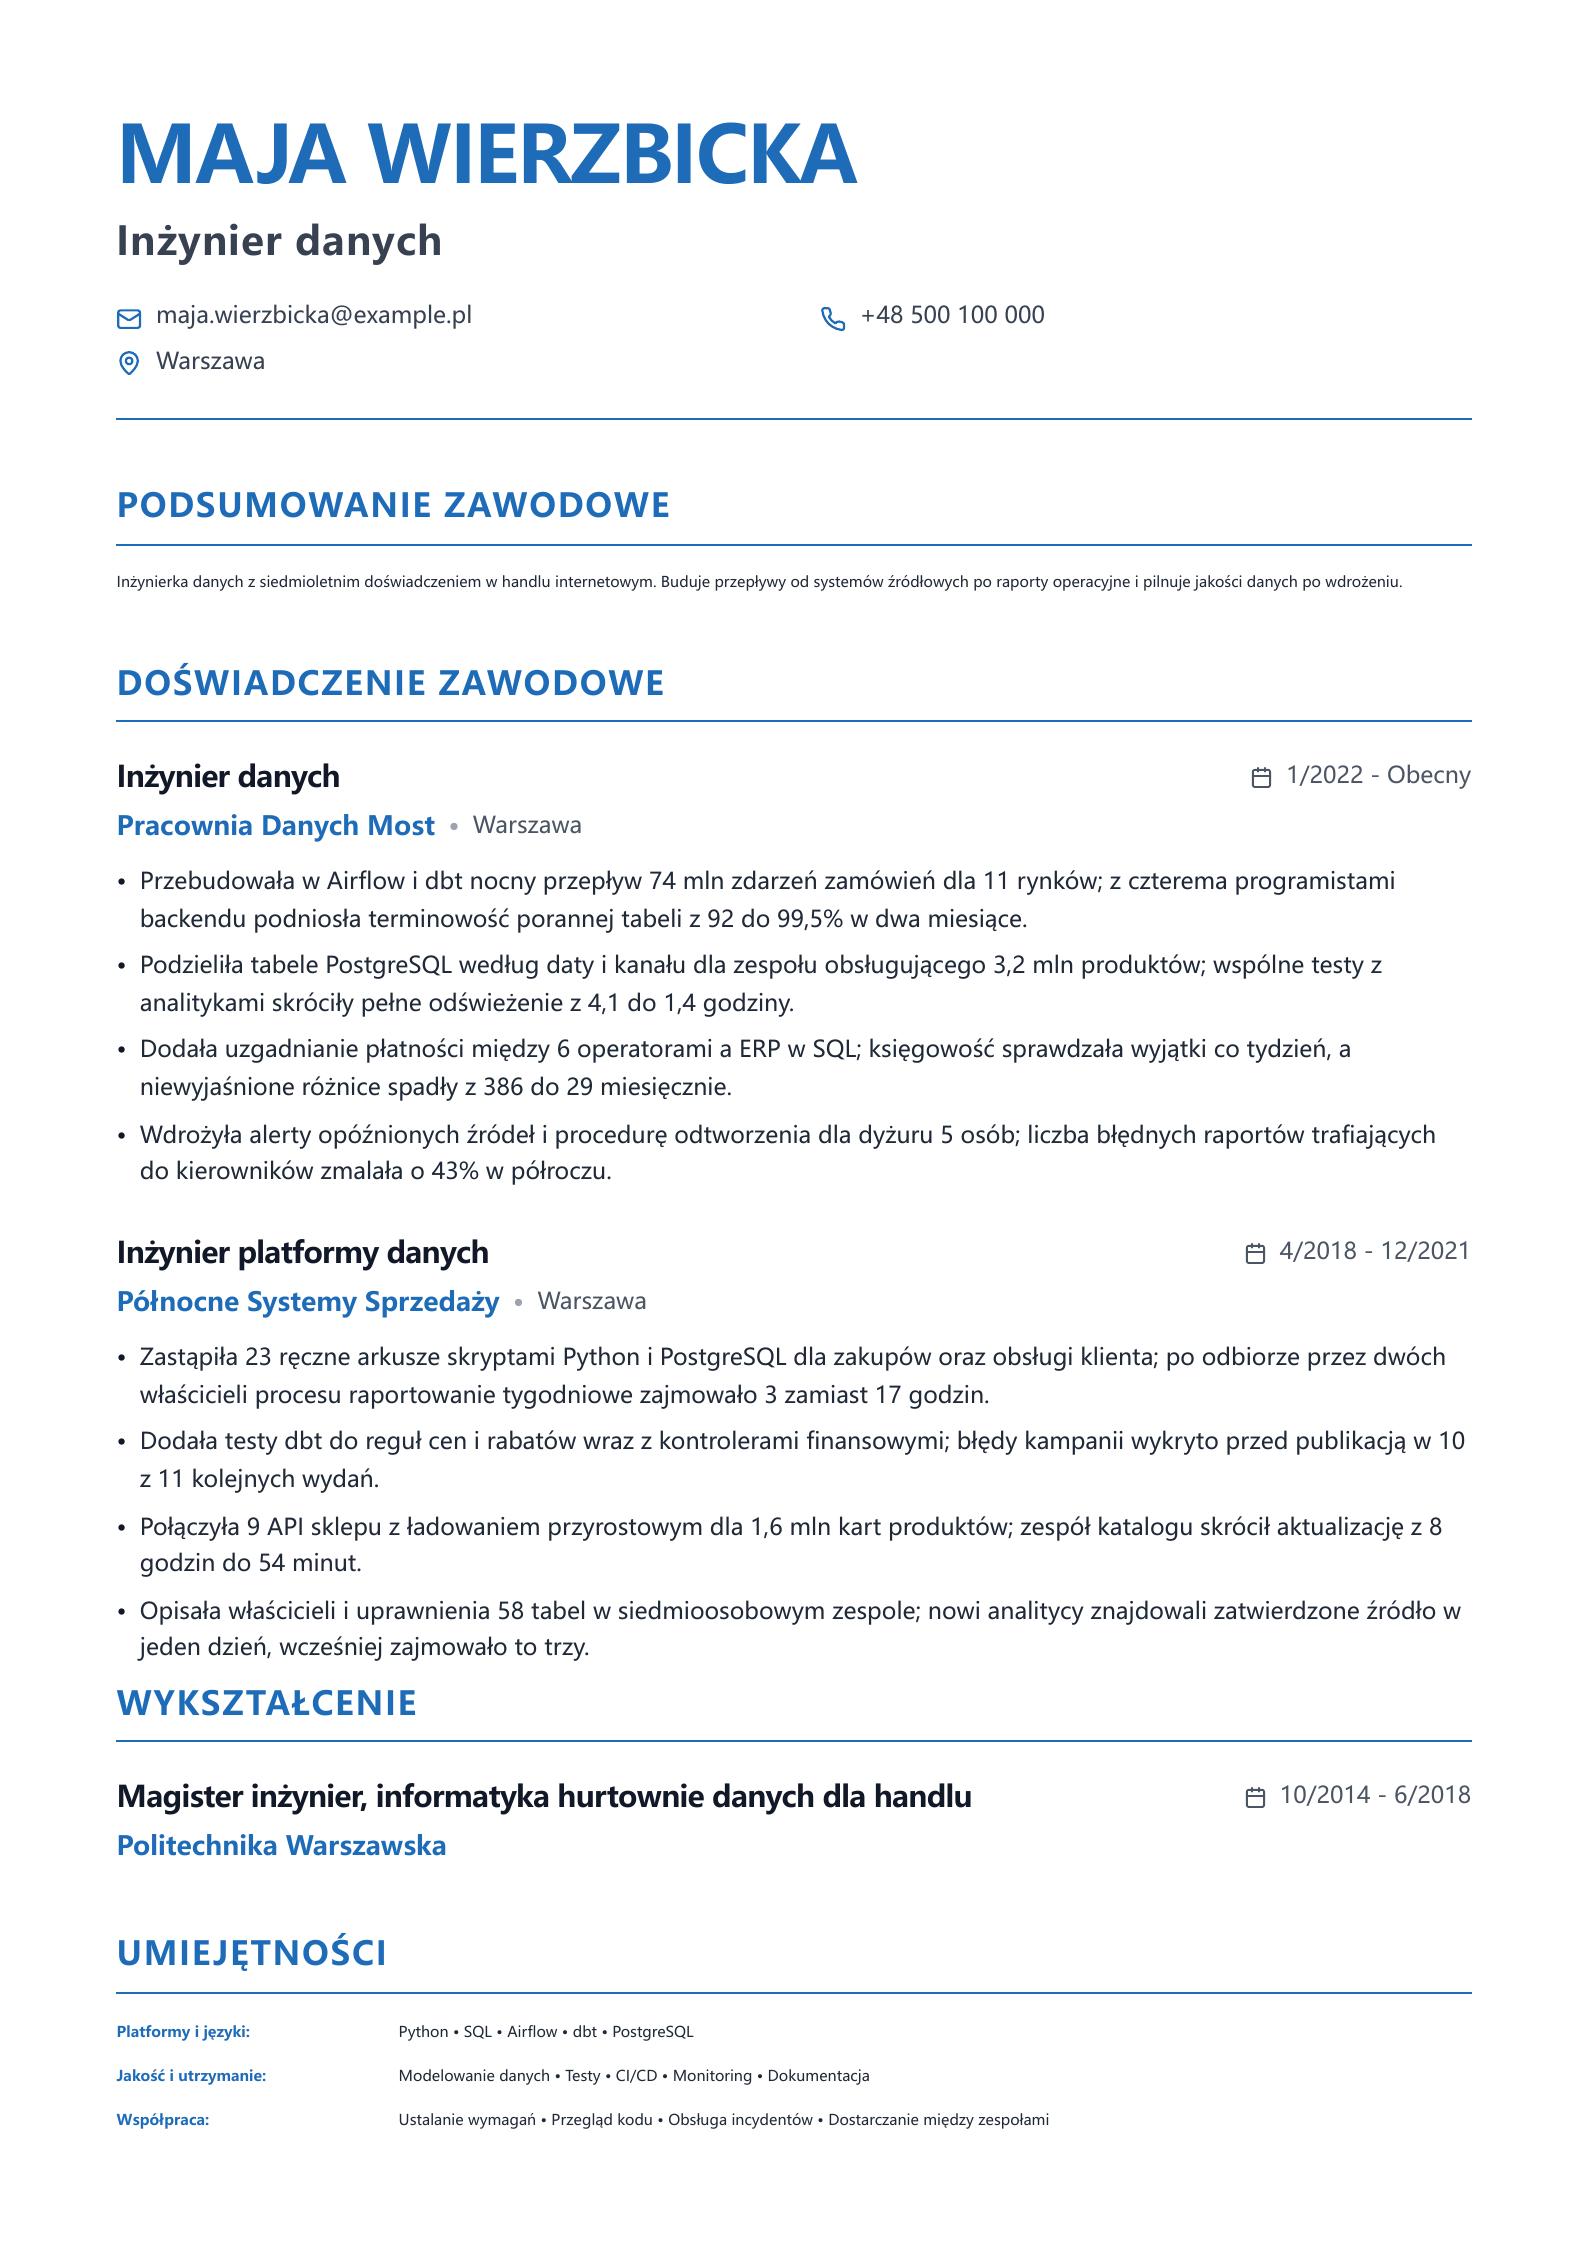
Przykład ogólnego CV inżynierki danych pracującej z zamówieniami, magazynem i analityką sprzedaży.
Porównaj CV dla pracy z chmurą, ETL, strumieniami, hurtowniami danych i computer vision. Każdy przykład pokazuje, jak połączyć techniczną decyzję z zakresem współpracy i wynikiem.
Znajdź przykład według platformy, poziomu doświadczenia lub specjalizacji i dopasuj go do własnej ścieżki zawodowej.
Przyda się przy: pipeline’y, modelowanie i niezawodność
Przykład ogólnego CV inżynierki danych pracującej z zamówieniami, magazynem i analityką sprzedaży.
Przyda się przy: Azure Data Factory, Synapse i IoT
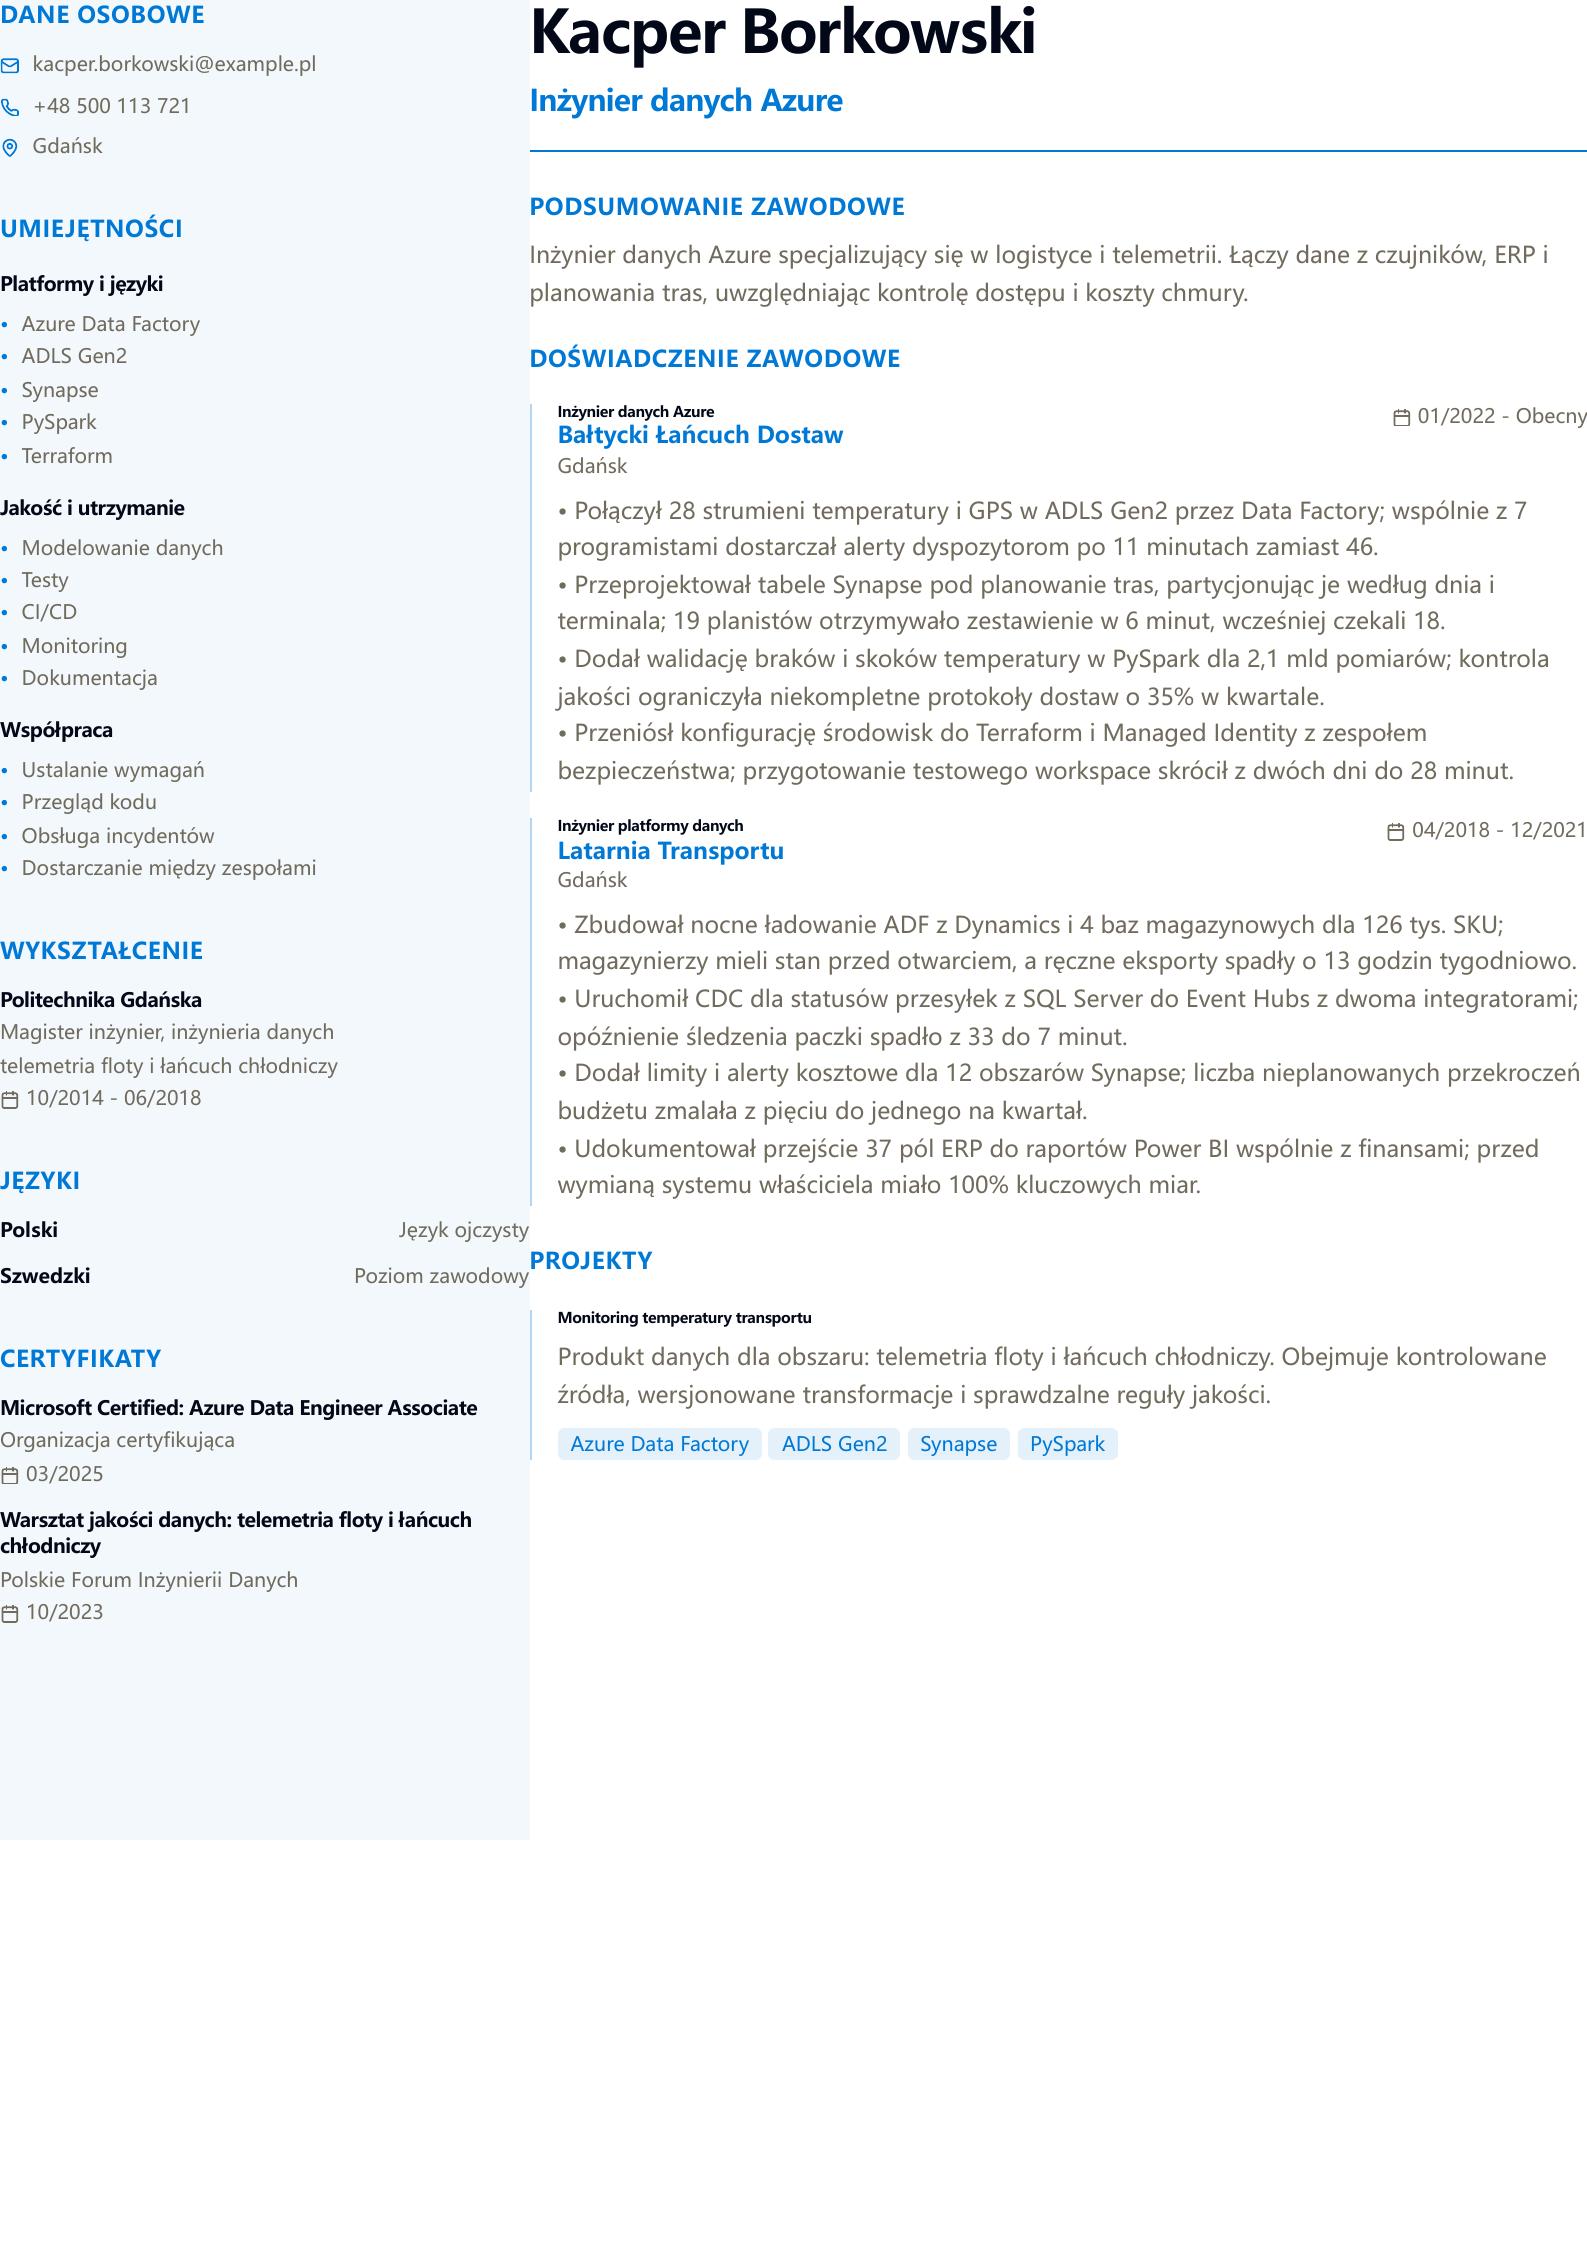
CV pokazuje pracę z usługami Azure przy telemetrii transportowej i raportowaniu dostaw.
Przyda się przy: Kinesis, S3, Glue i Redshift
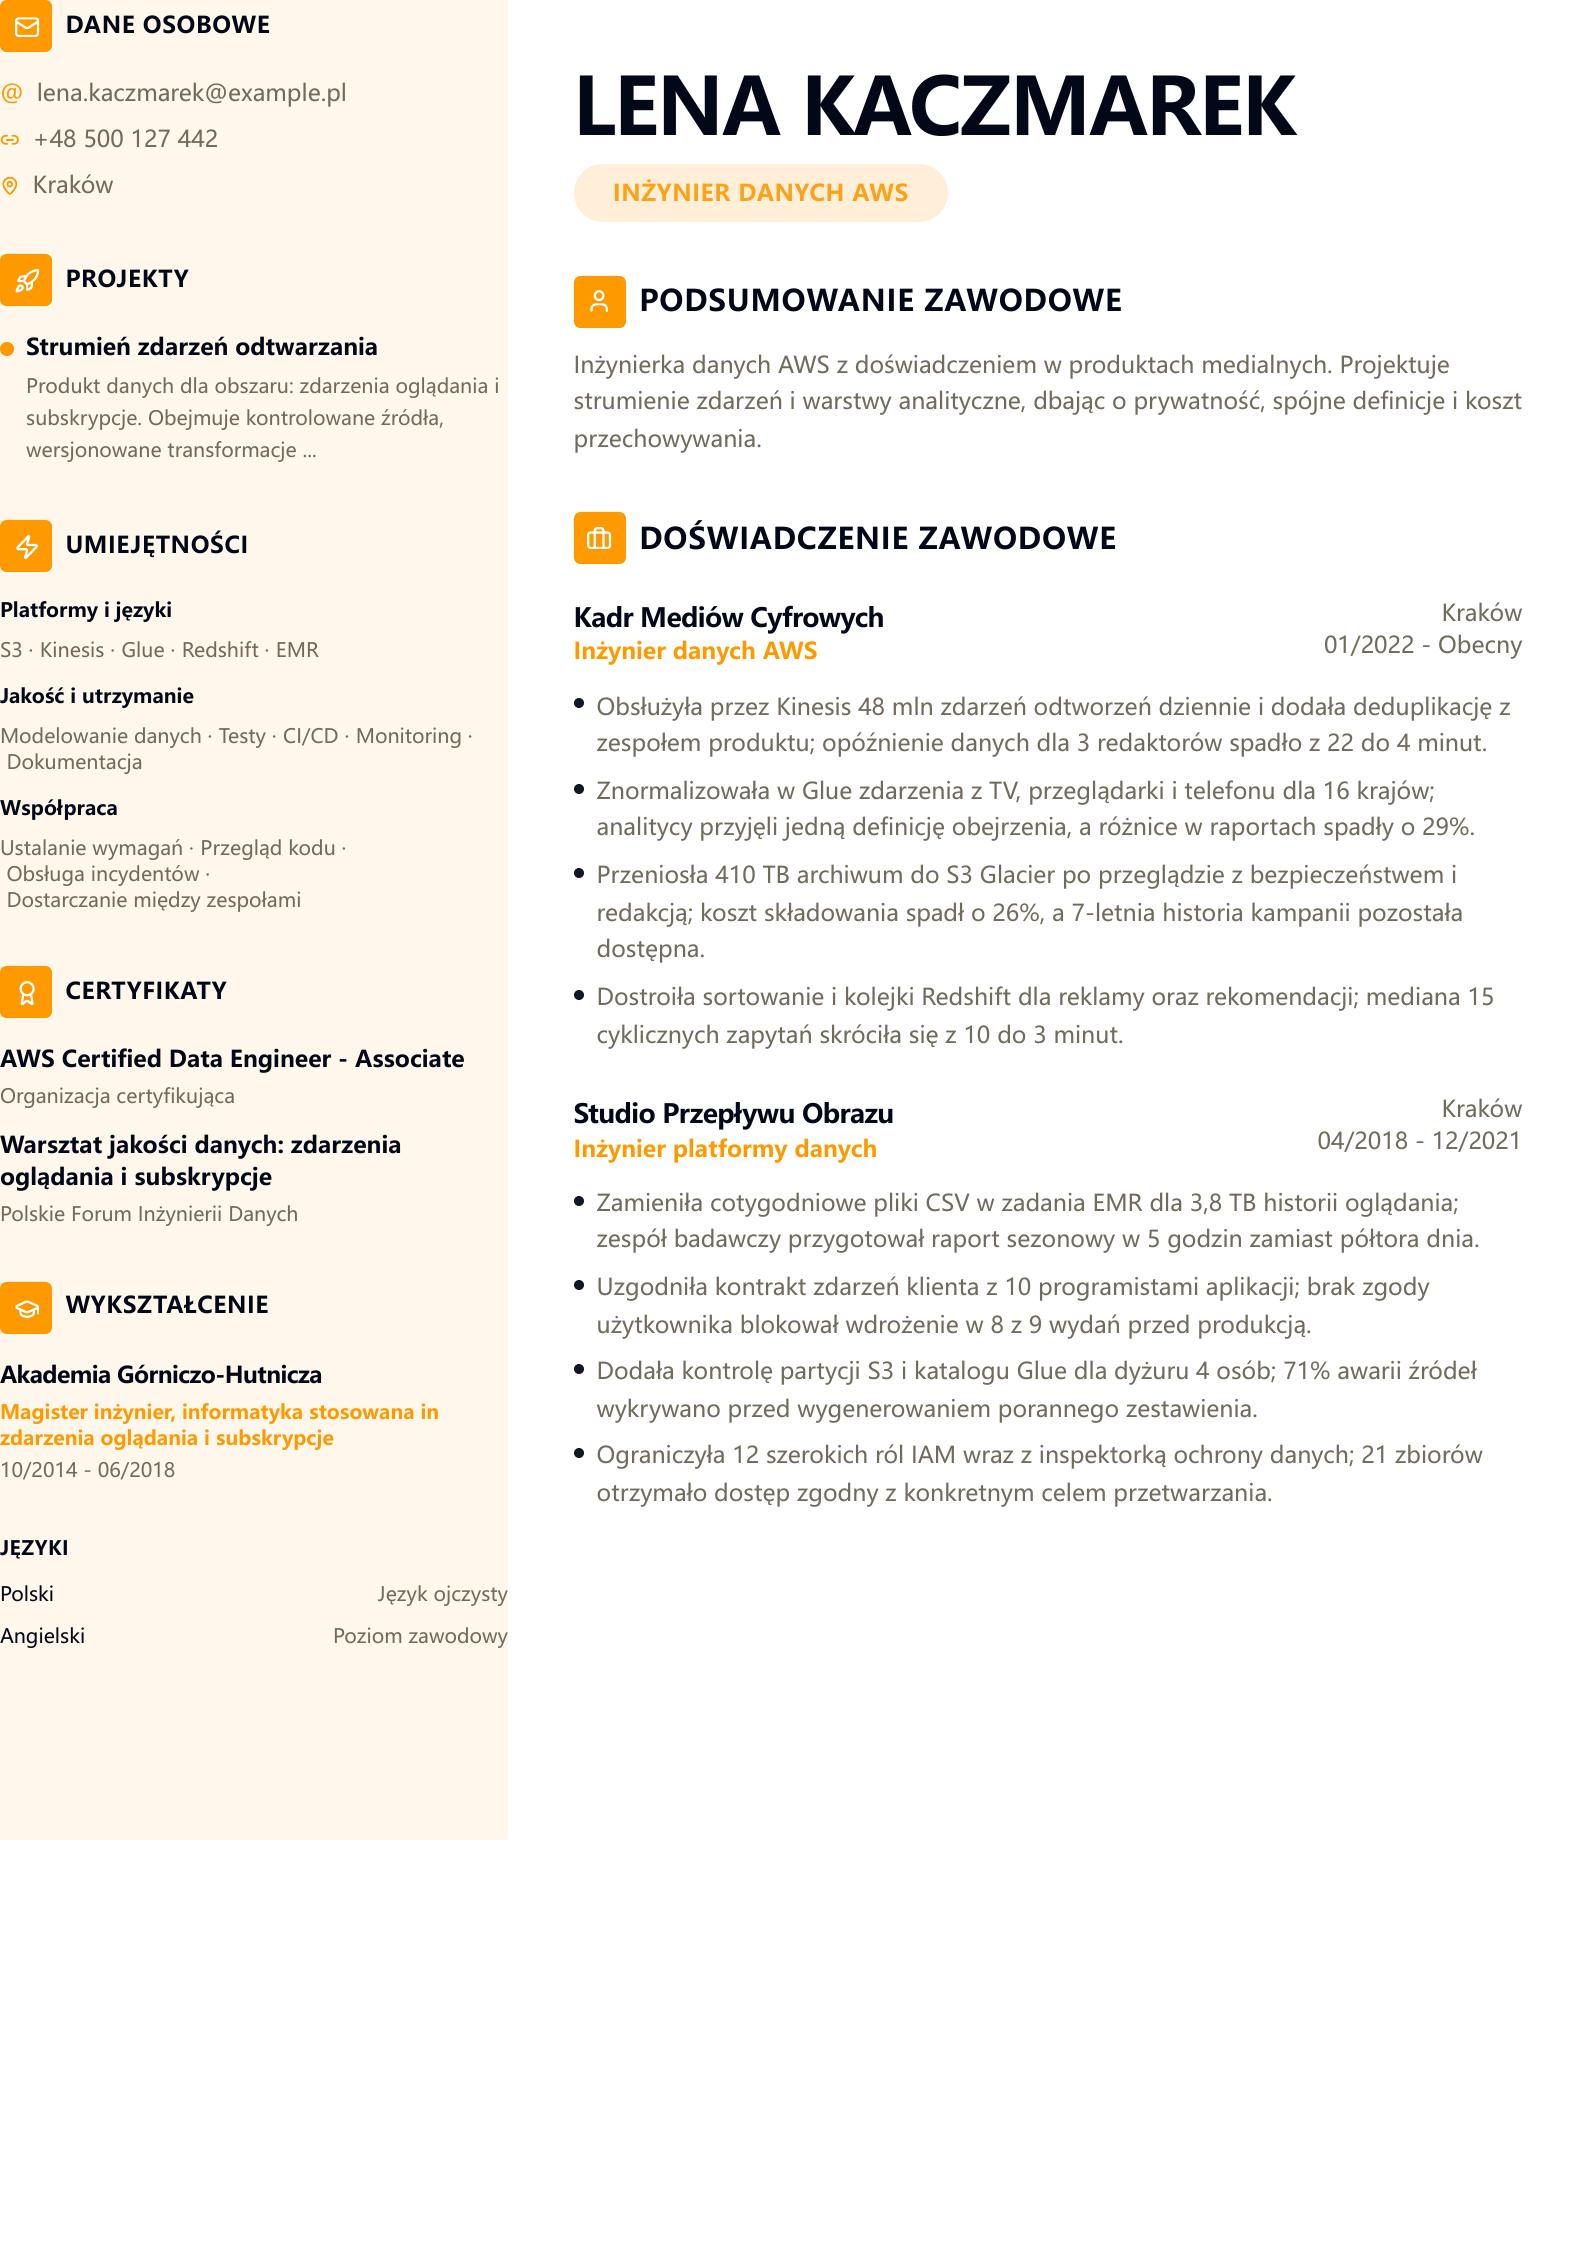
Przykład dla platform medialnych zbierających zdarzenia z aplikacji, telewizorów i serwisów WWW.
Przyda się przy: BigQuery, Dataflow i dane kampanii
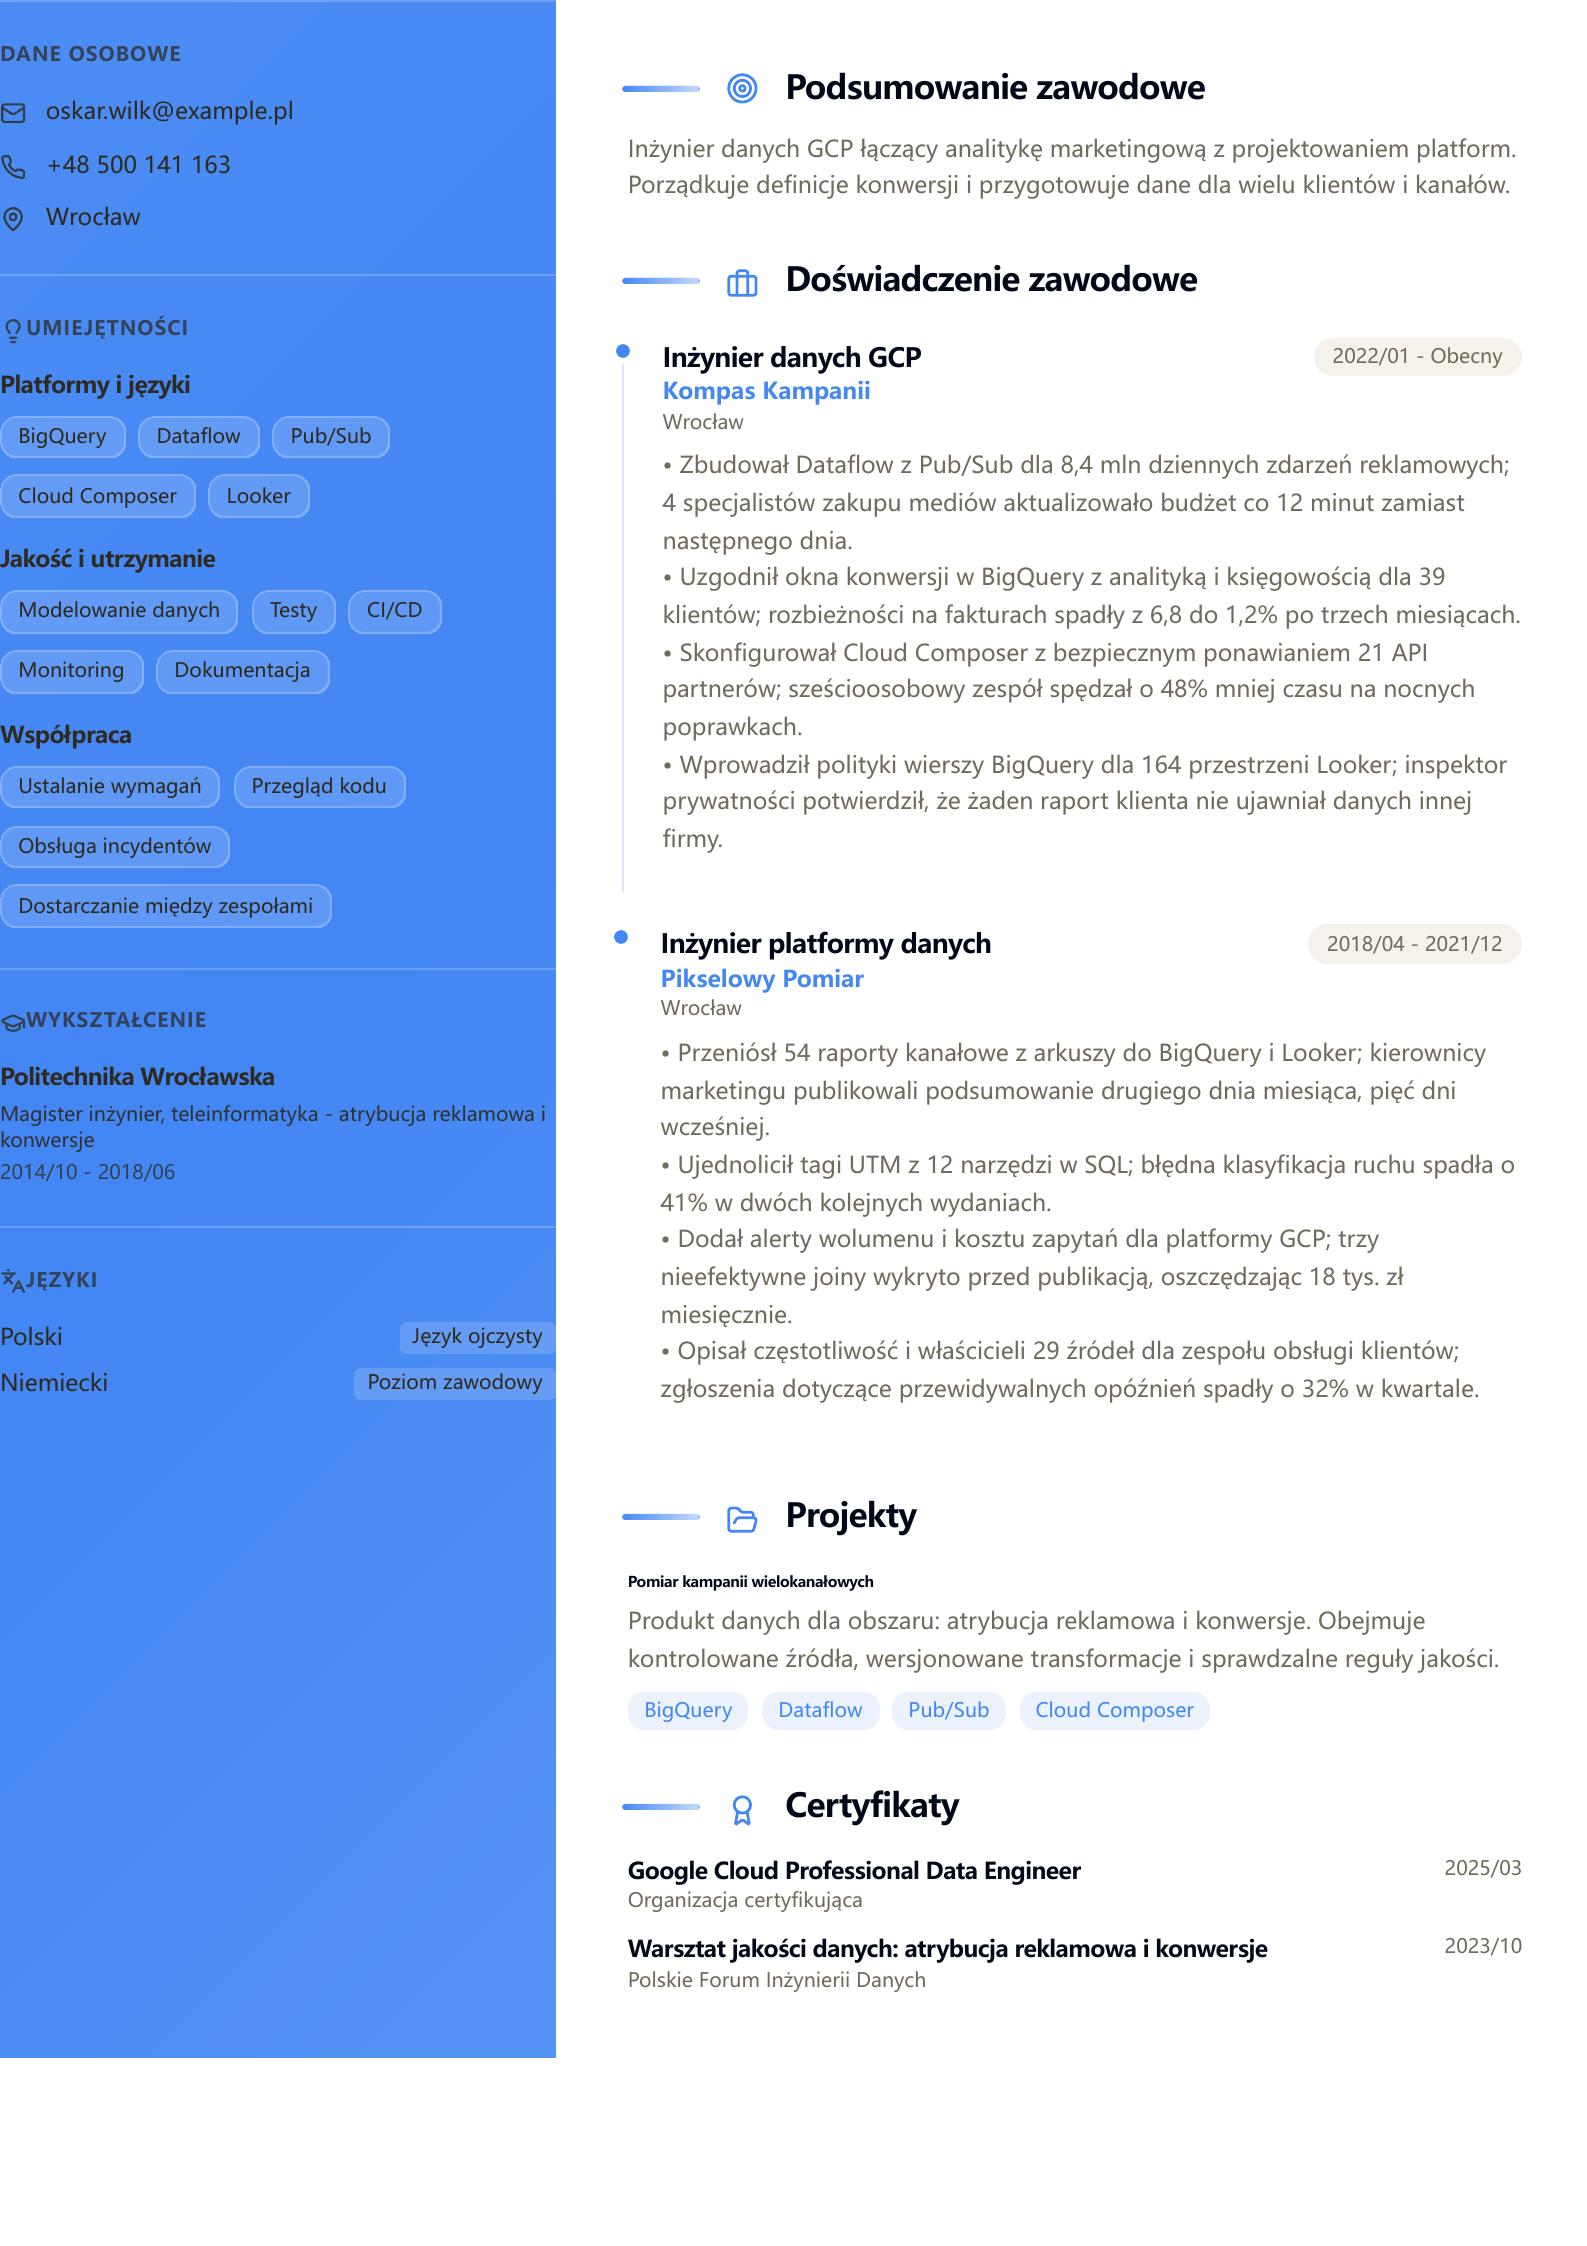
Przykład pracy z BigQuery, Dataflow i Pub/Sub w zespole obsługującym kampanie reklamowe.
Przyda się przy: Snowflake, dbt i modele finansowe
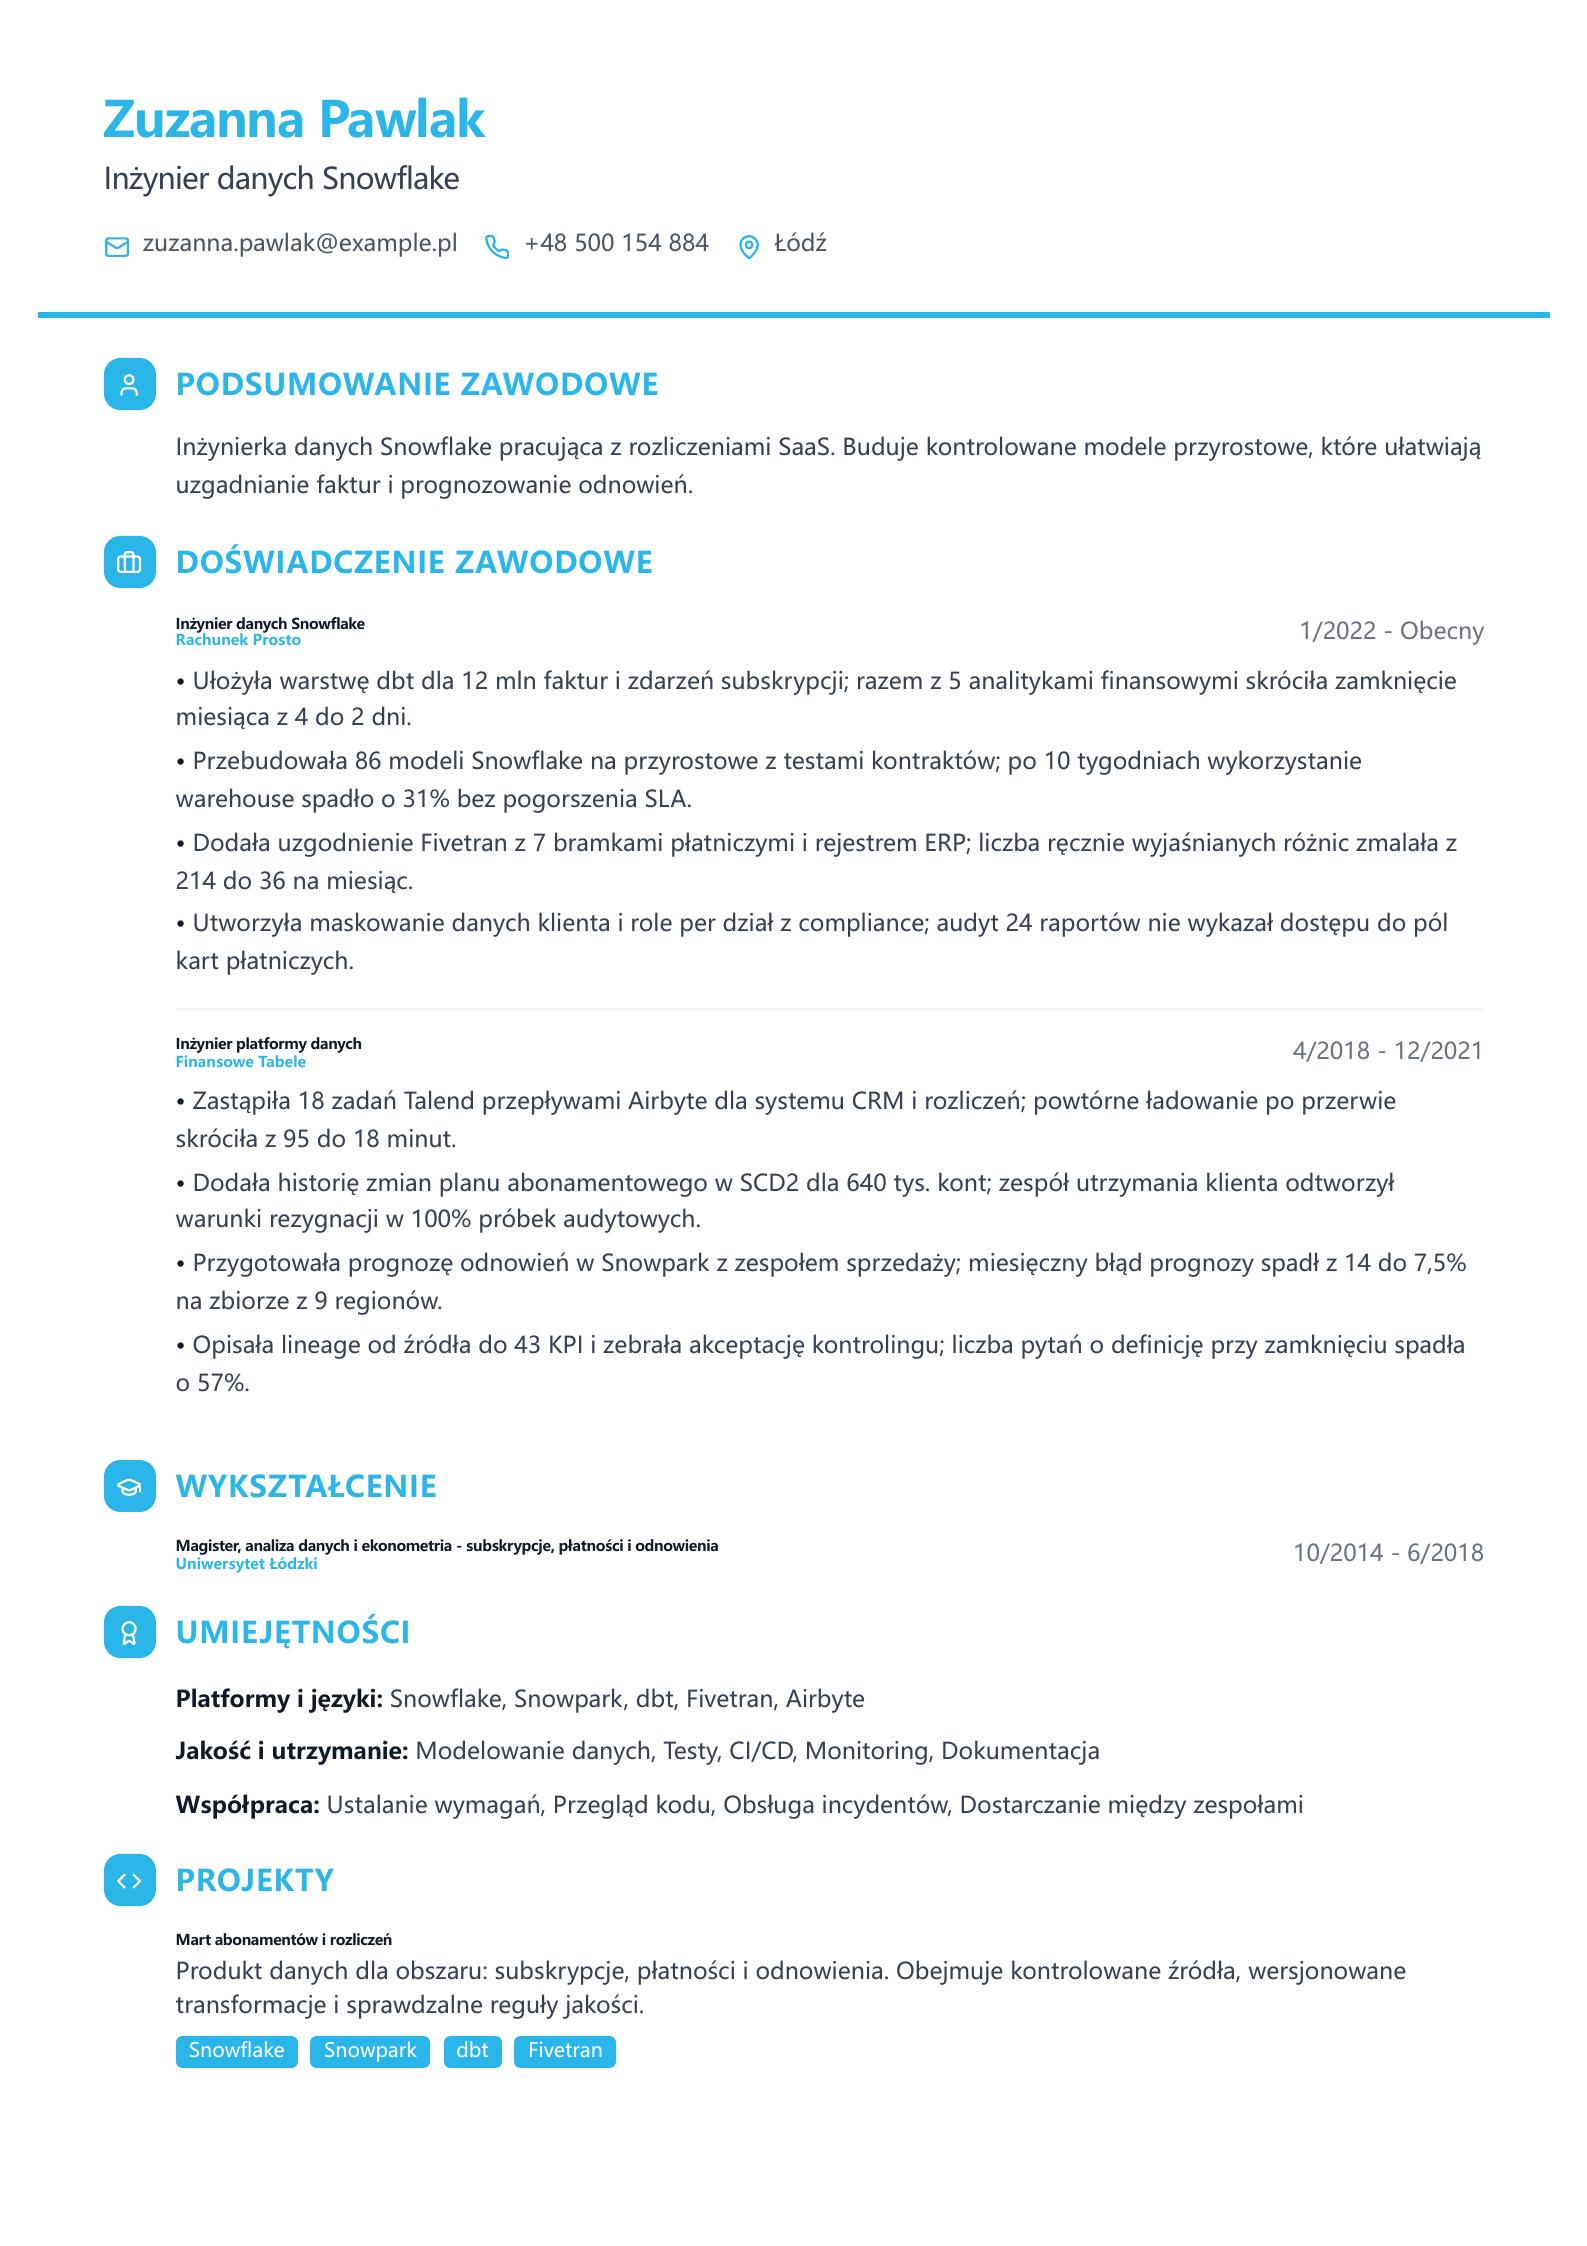
CV koncentruje się na hurtowni Snowflake, transformacjach dbt i uzgadnianiu płatności.
Przyda się przy: Kafka, Spark, Flink i wolumeny zdarzeń
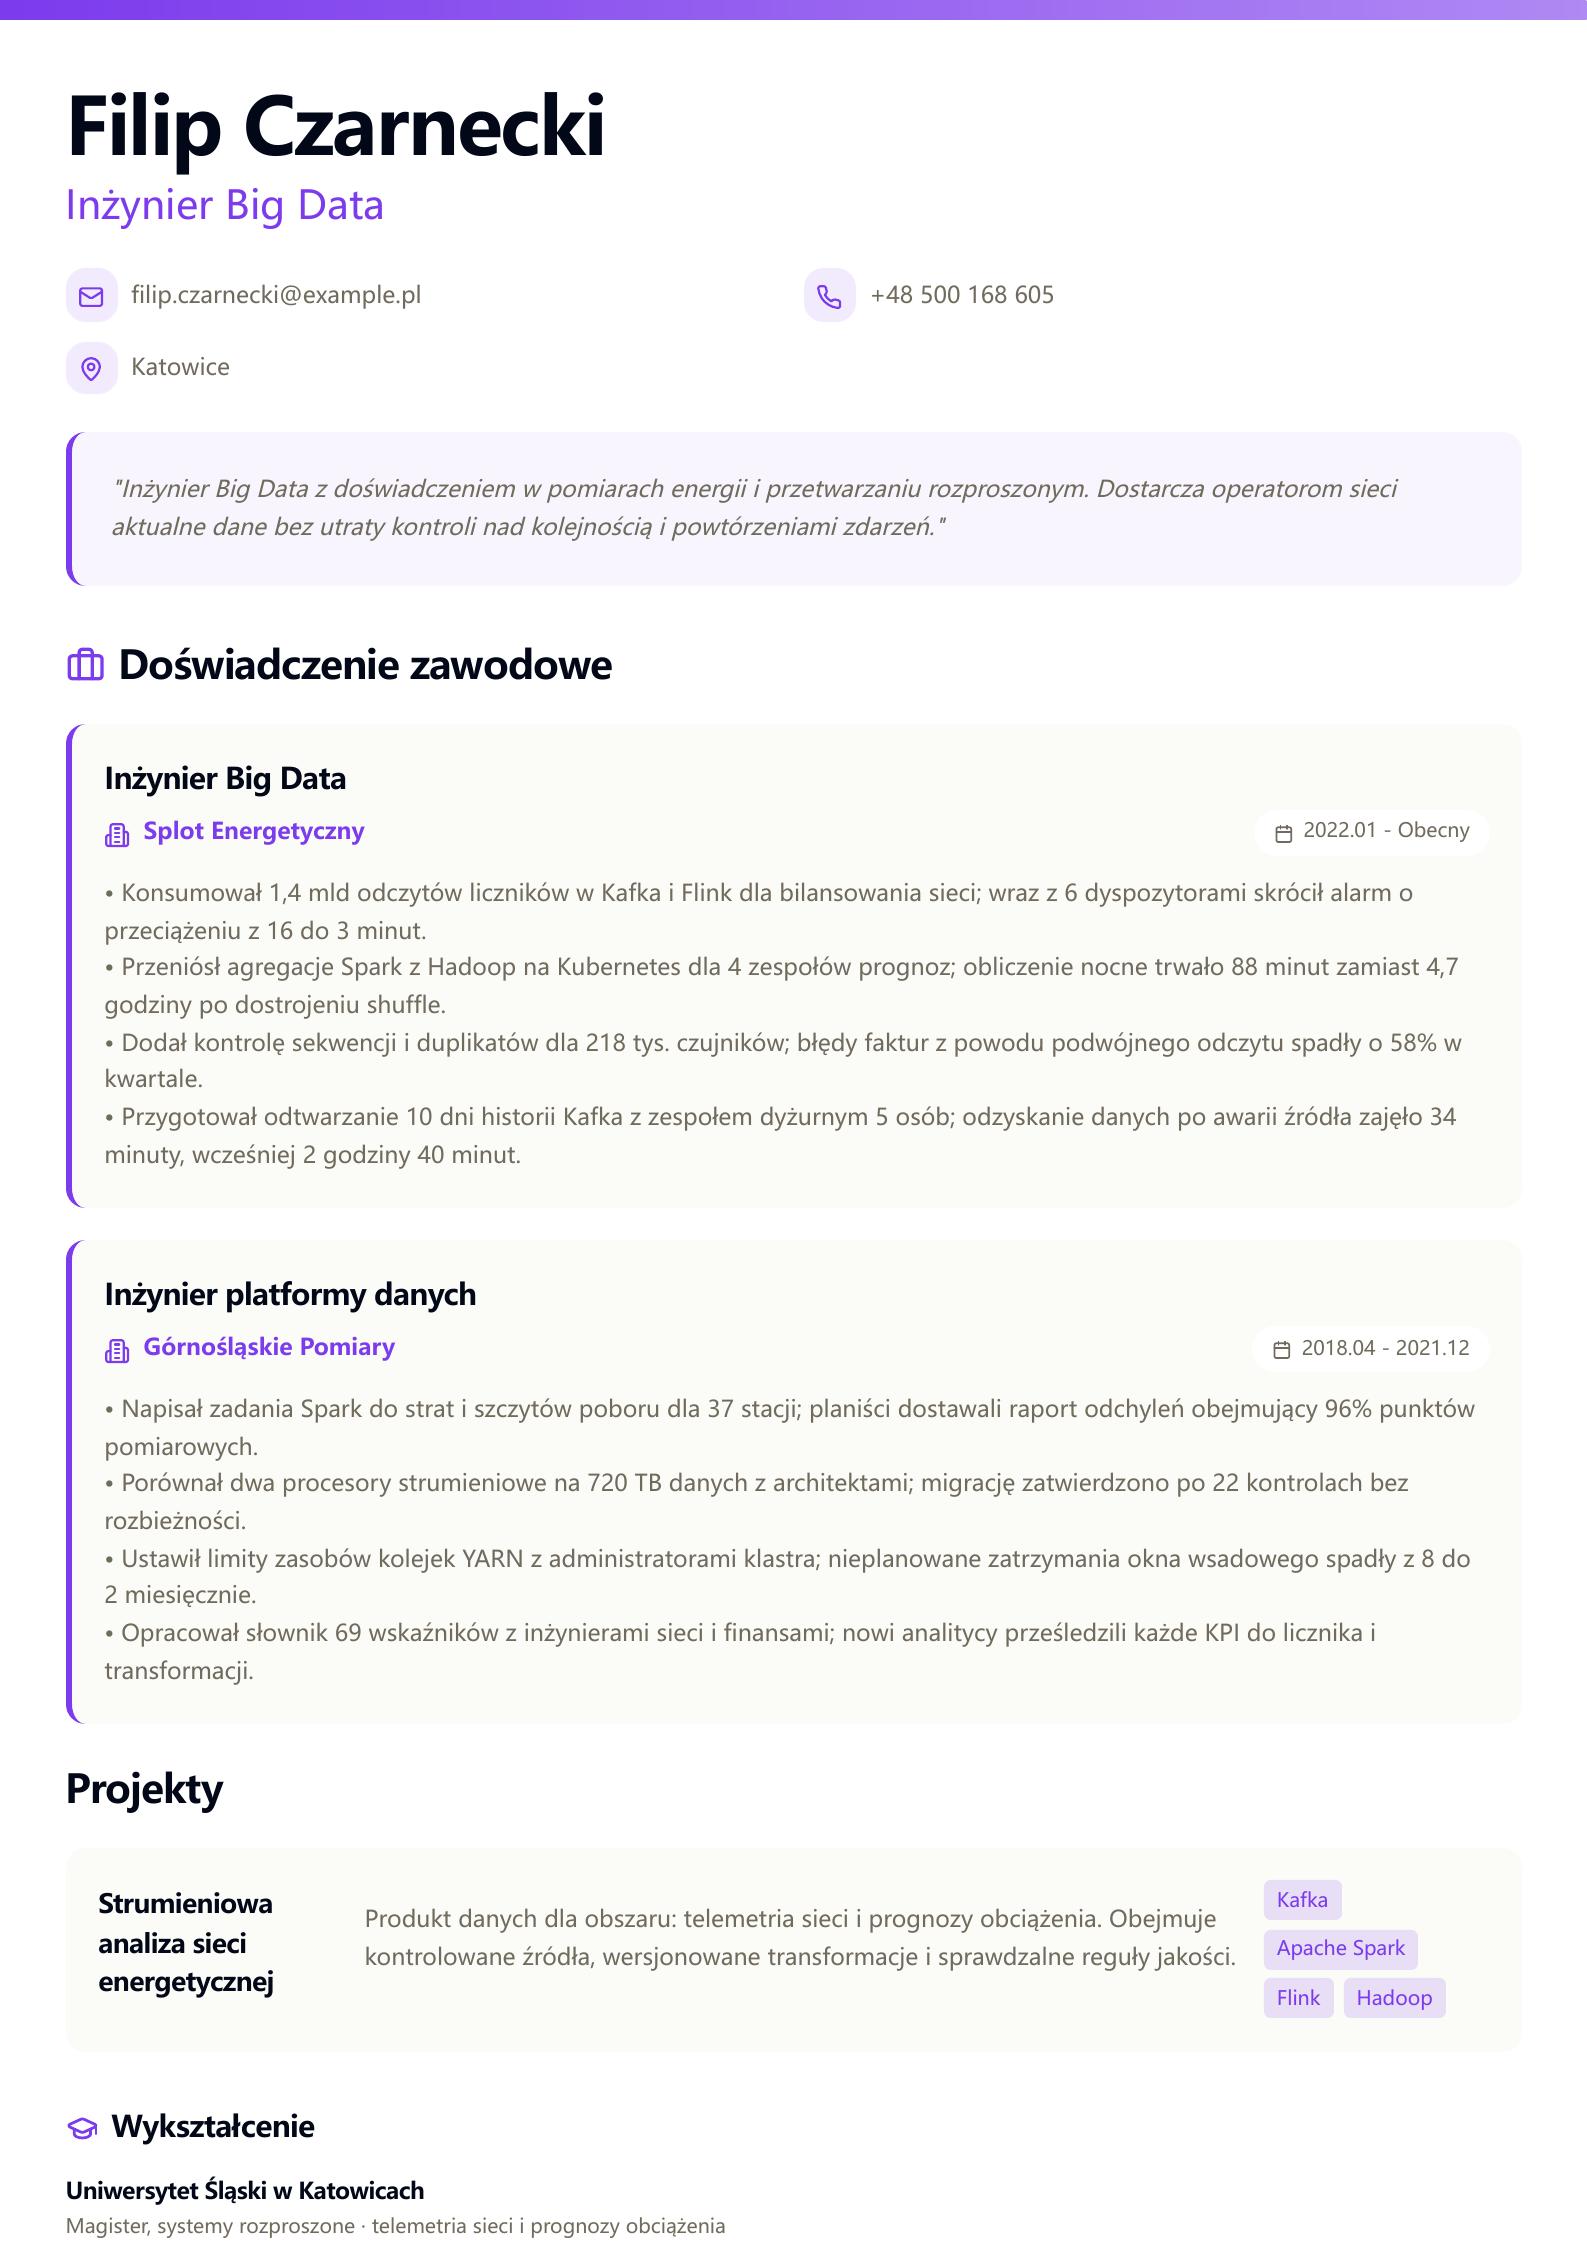
Przykład przetwarzania miliardów pomiarów z sieci energetycznej w czasie zbliżonym do rzeczywistego.
Przyda się przy: telemetria, pojemność i niezawodność
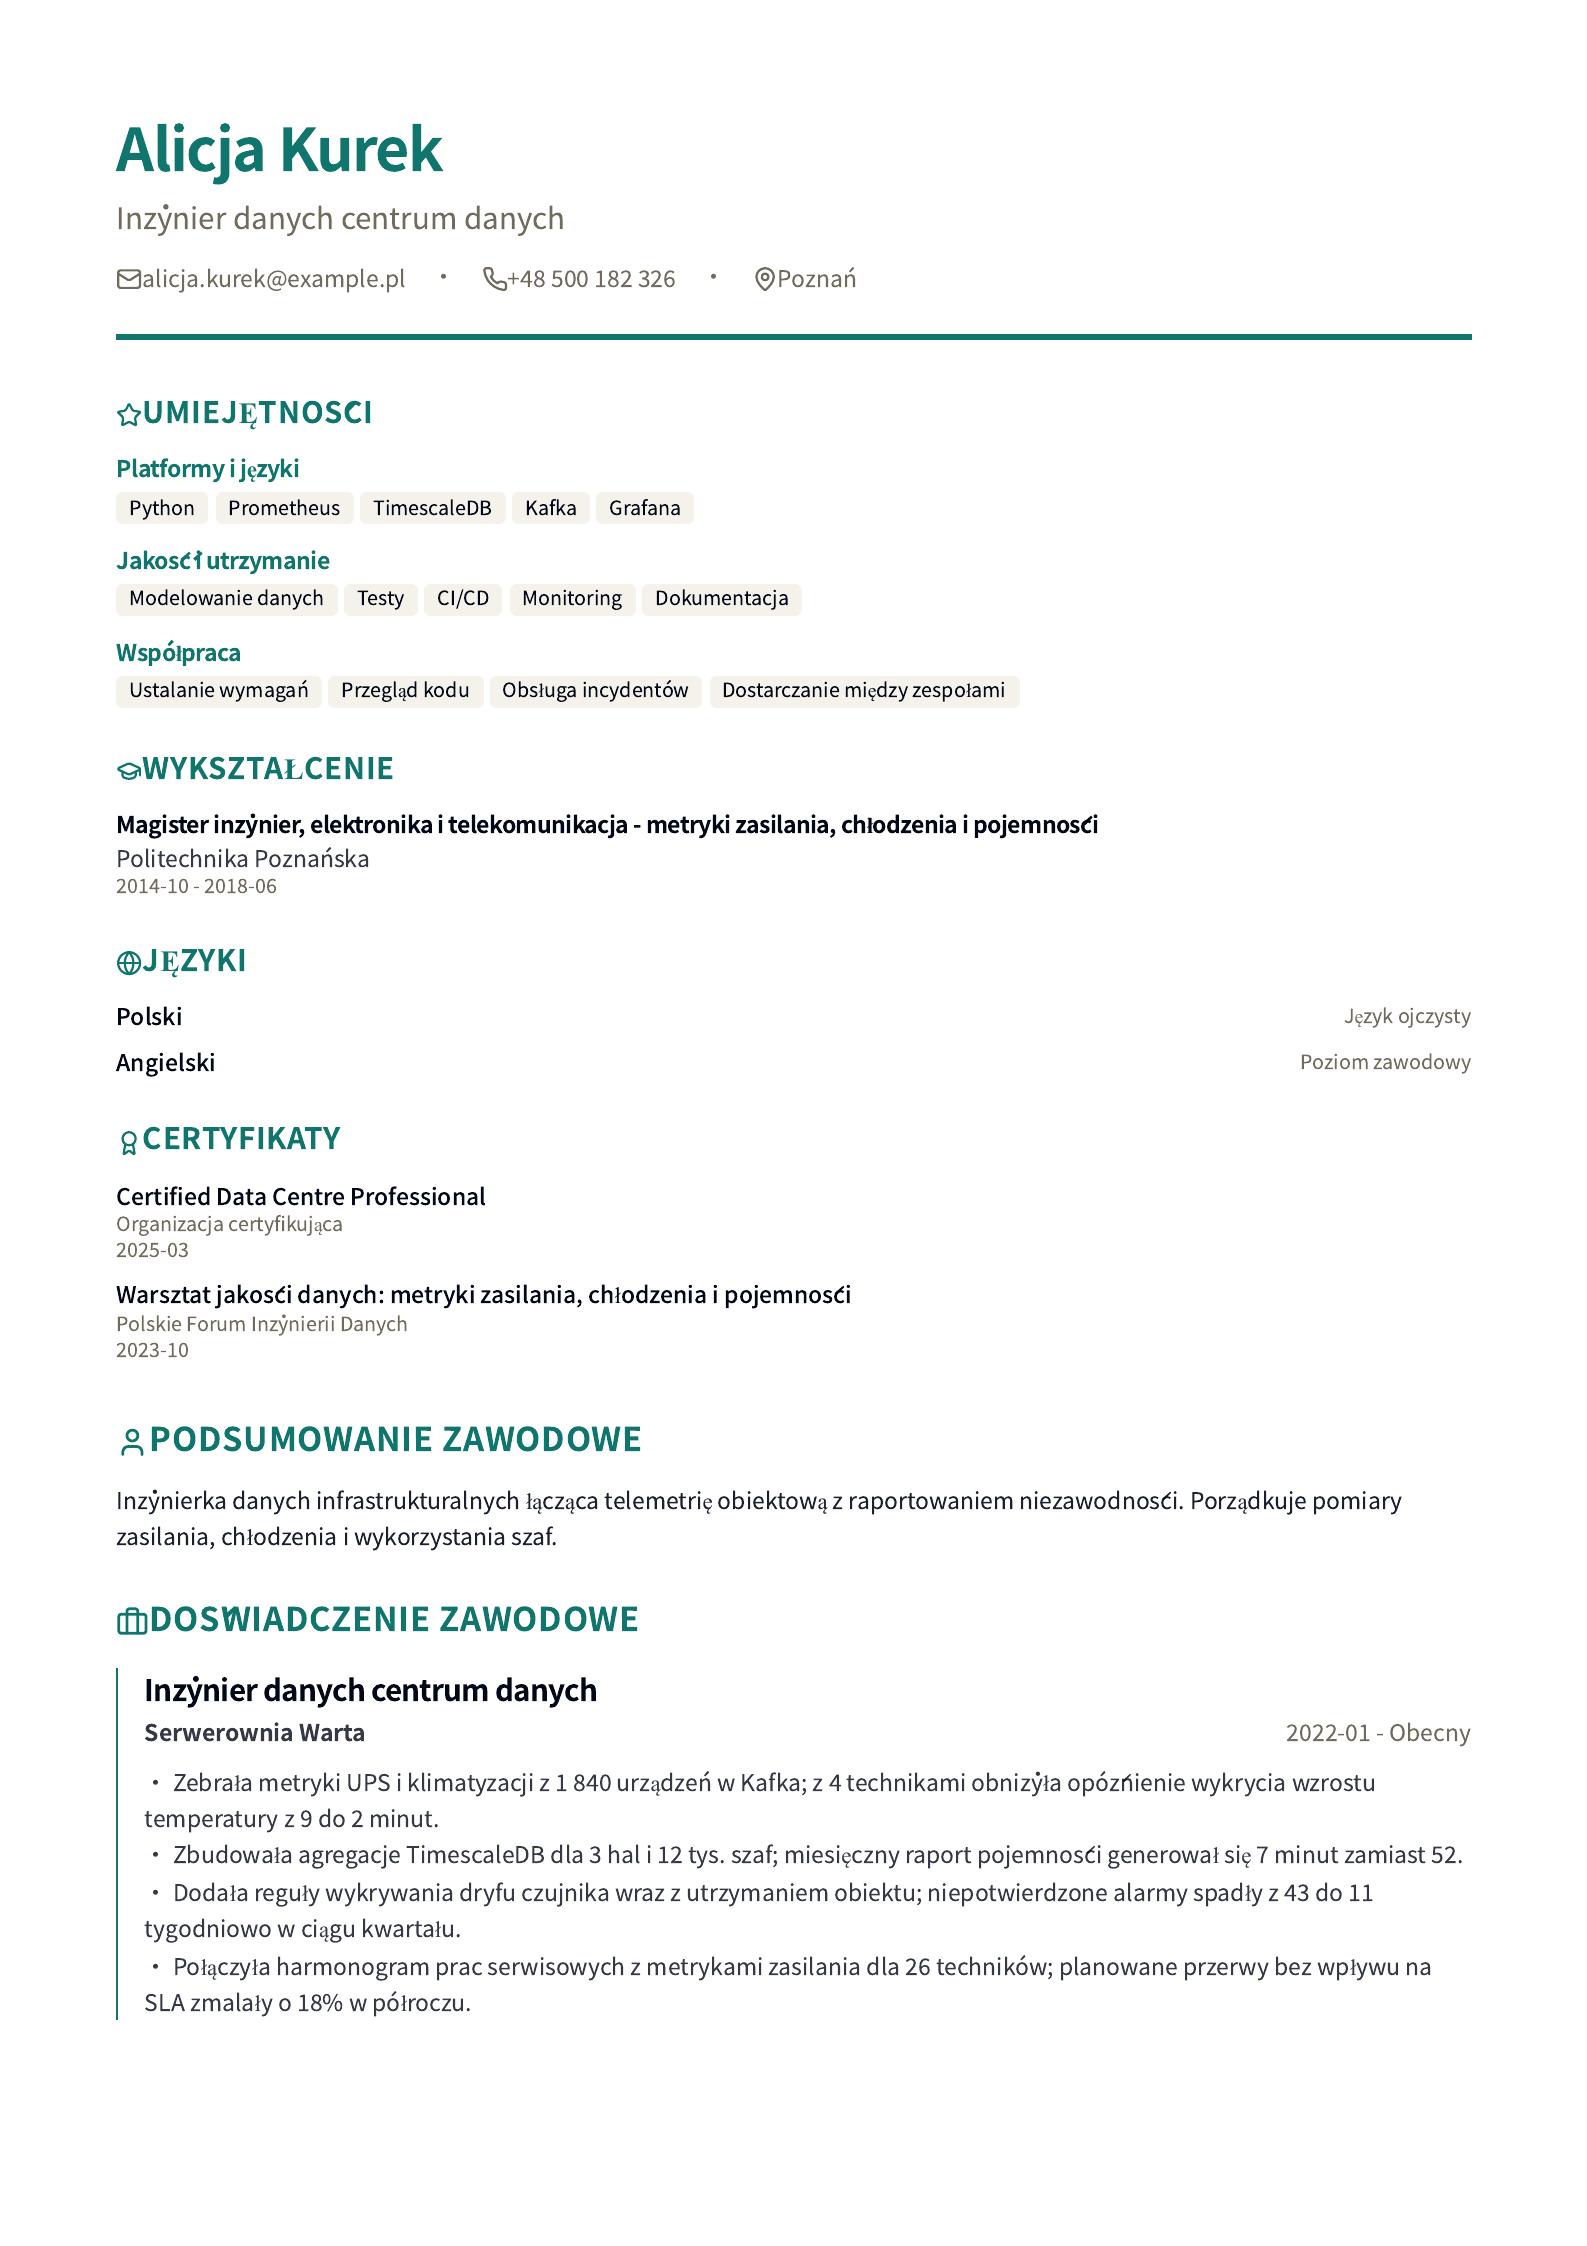
Przykład dla osób budujących przepływy telemetryczne dla centrów danych i infrastruktury krytycznej.
Przyda się przy: Databricks, Delta Lake i IoT
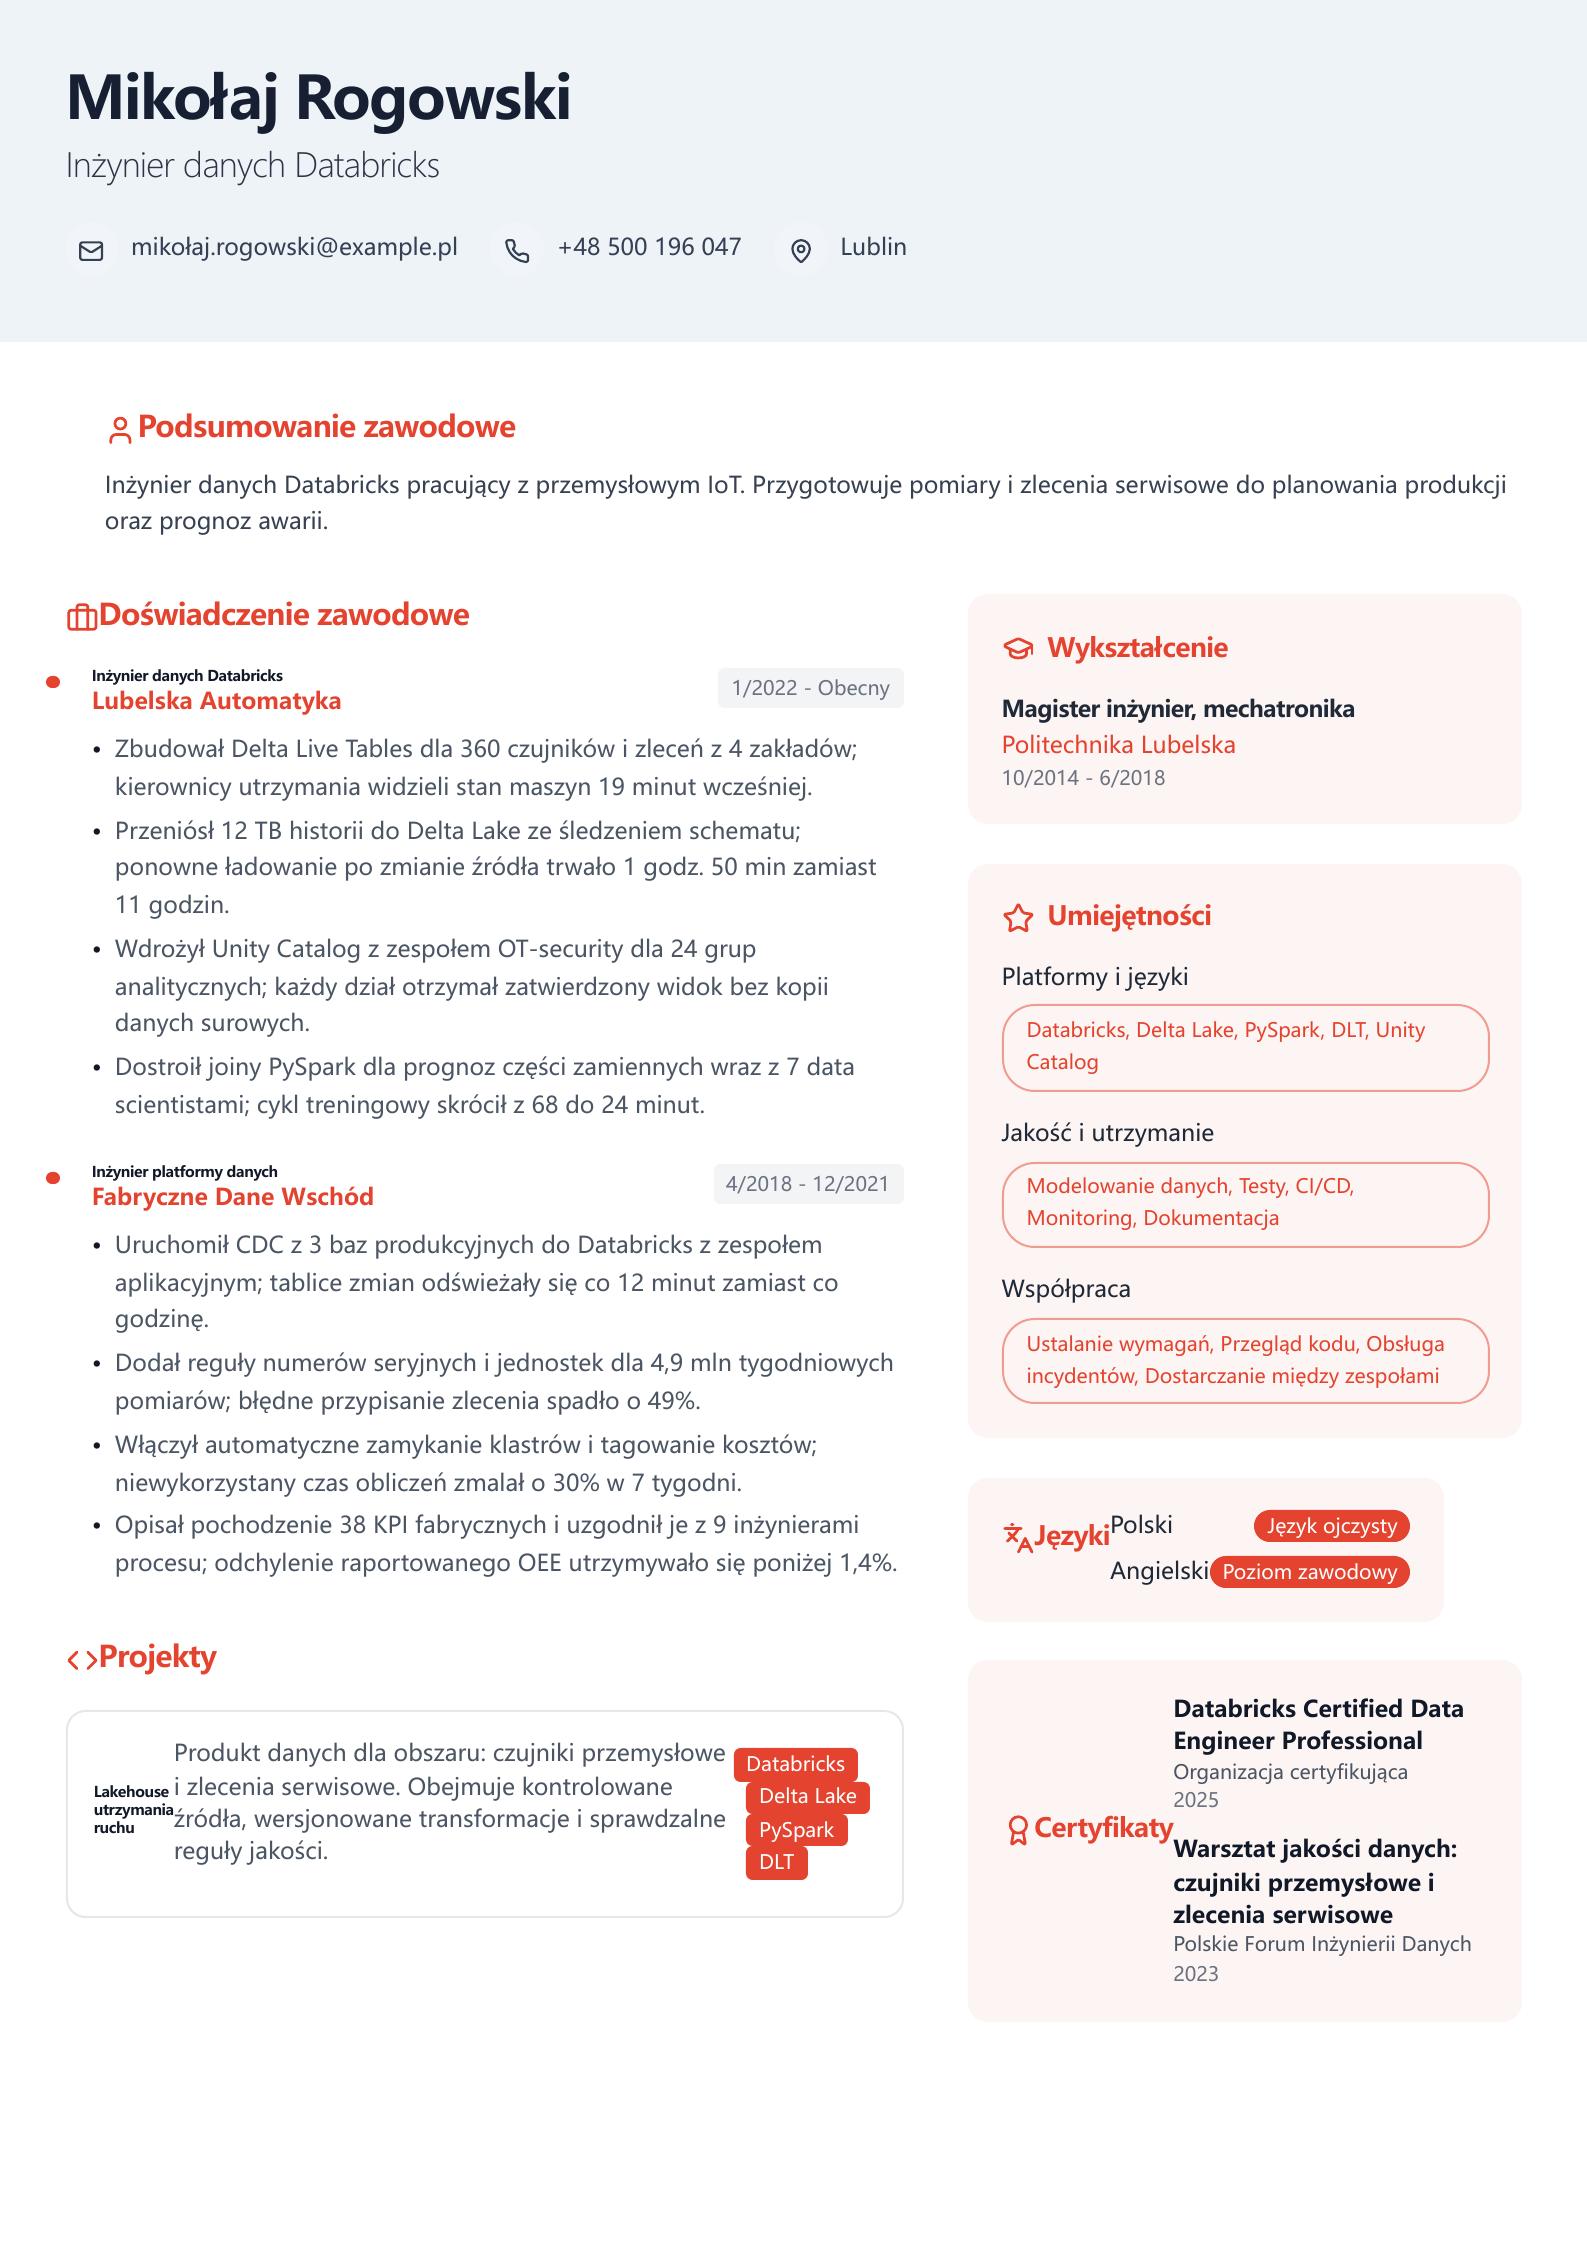
CV pokazuje zastosowanie Delta Lake i Unity Catalog dla danych z kilku zakładów produkcyjnych.
Przyda się przy: pierwsza praca, praktyki i projekty
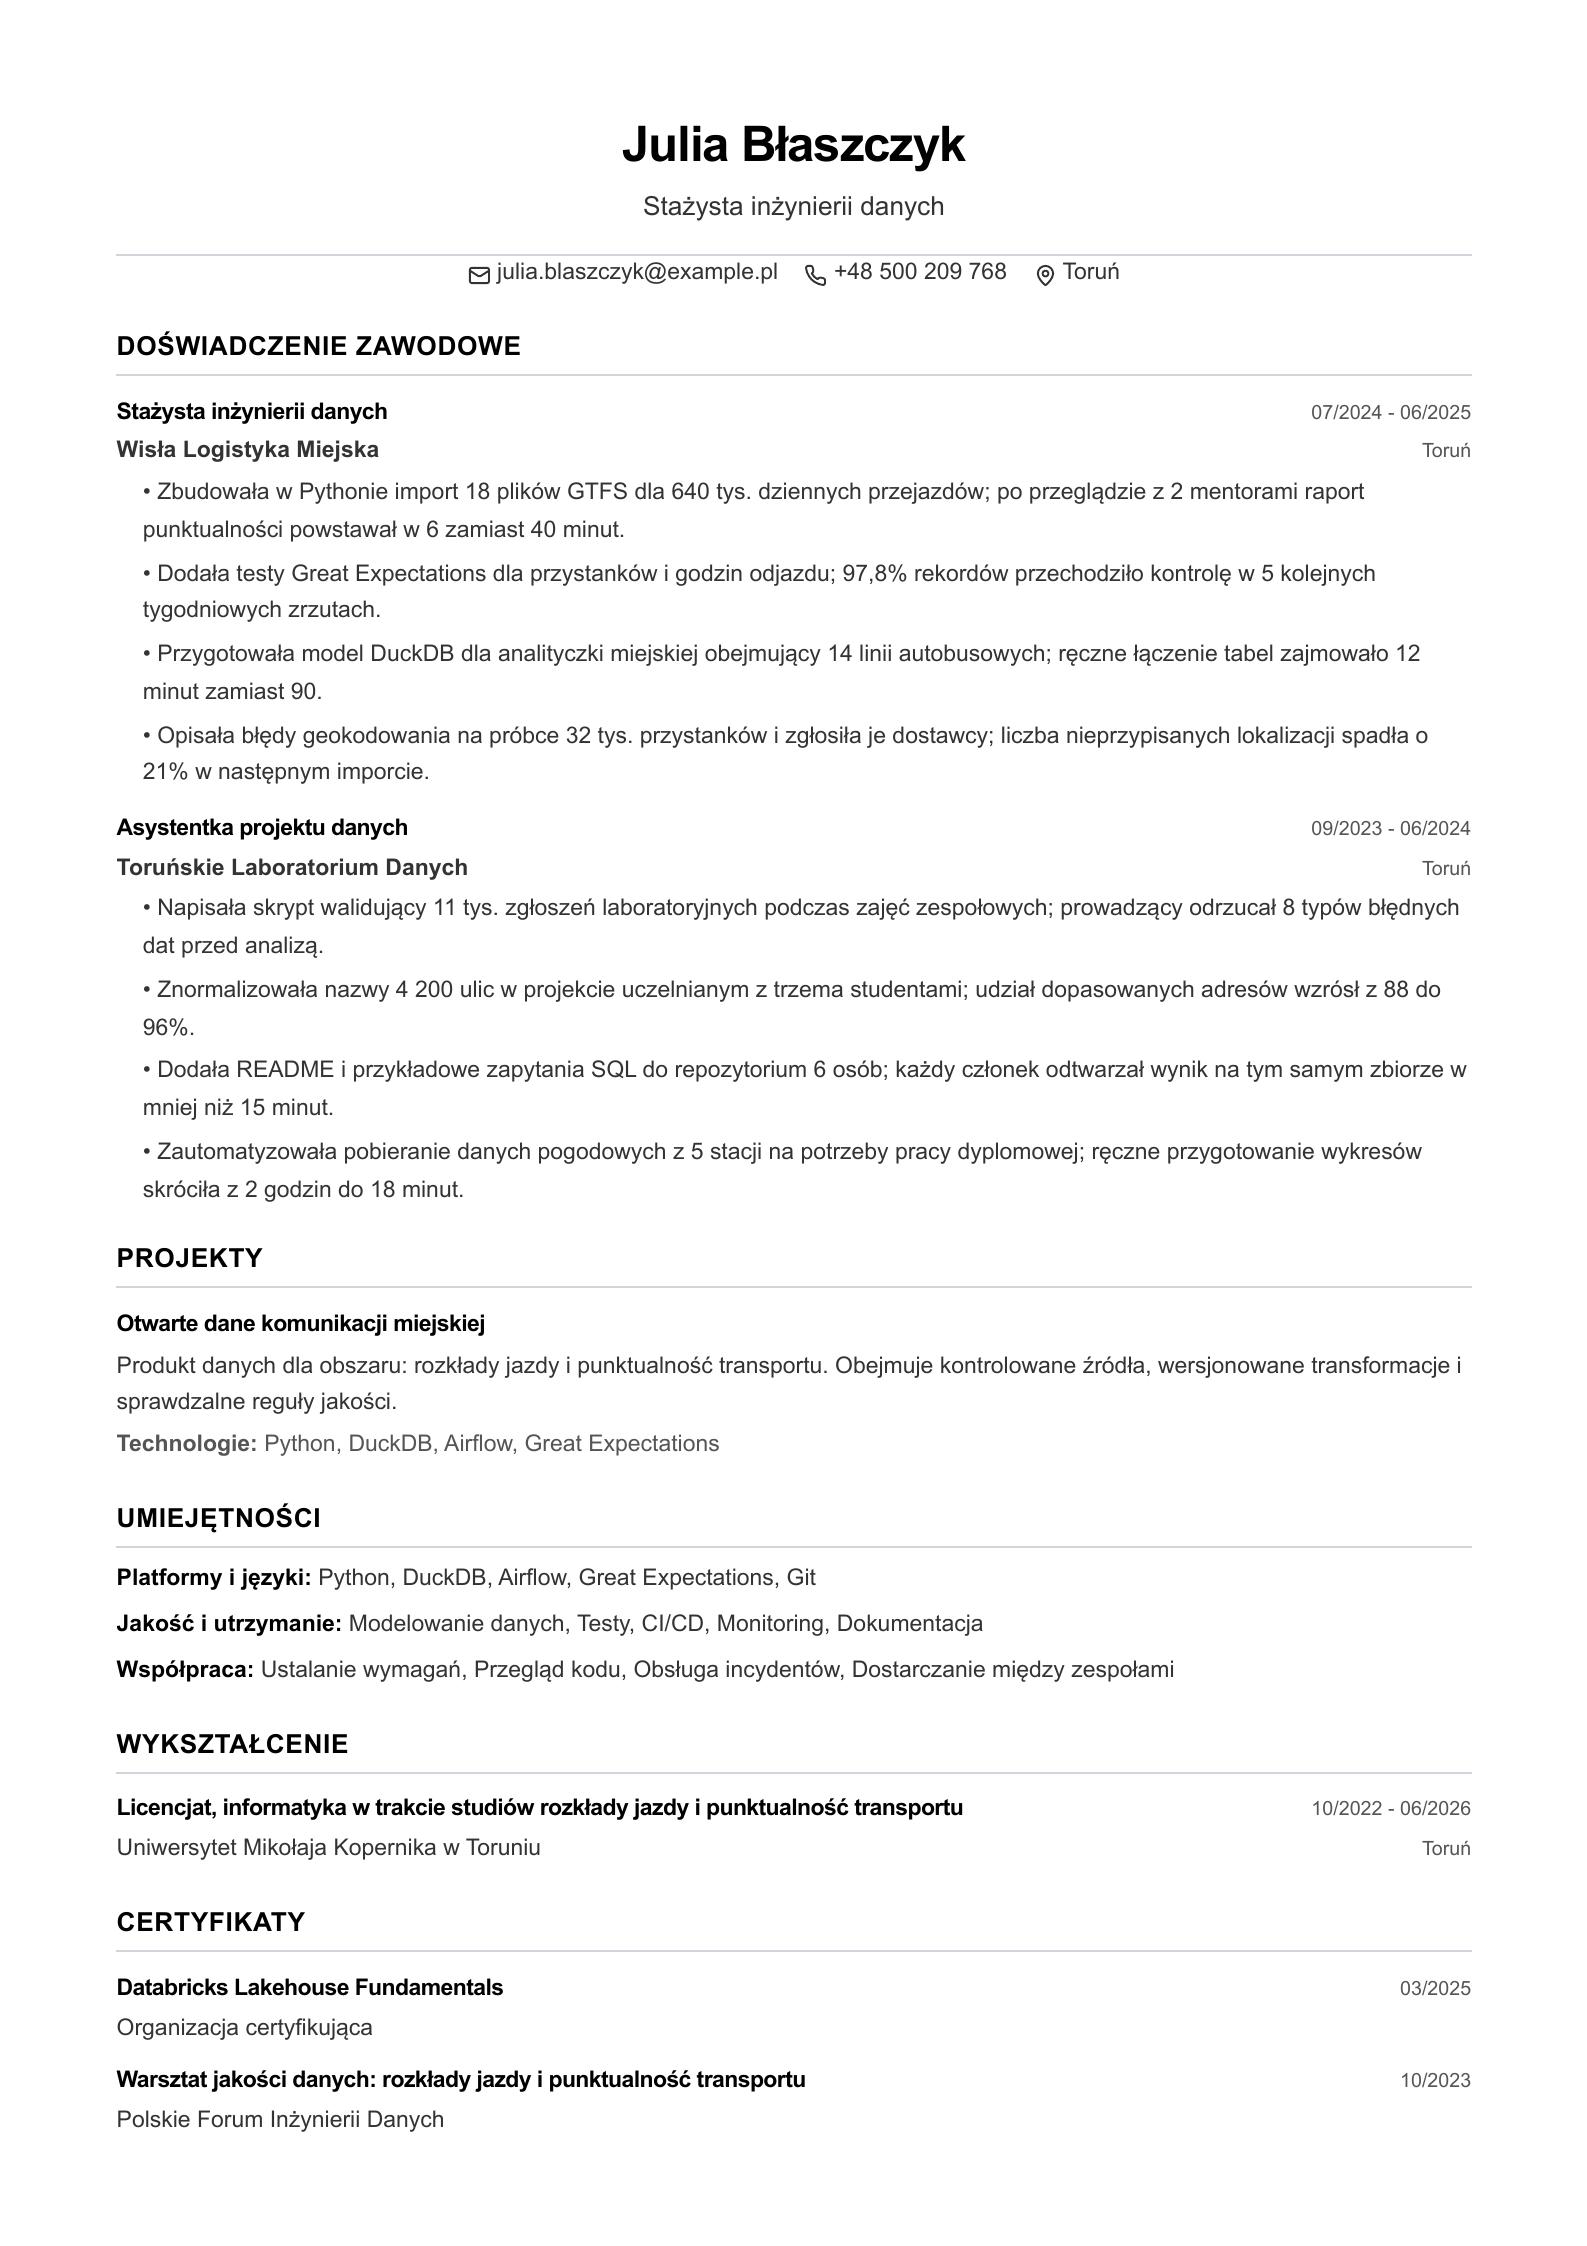
Przykład początkującej osoby, która pokazuje staż, pracę projektową i umiejętność testowania danych.
Przyda się przy: ETL, SQL i pierwsze wdrożenia
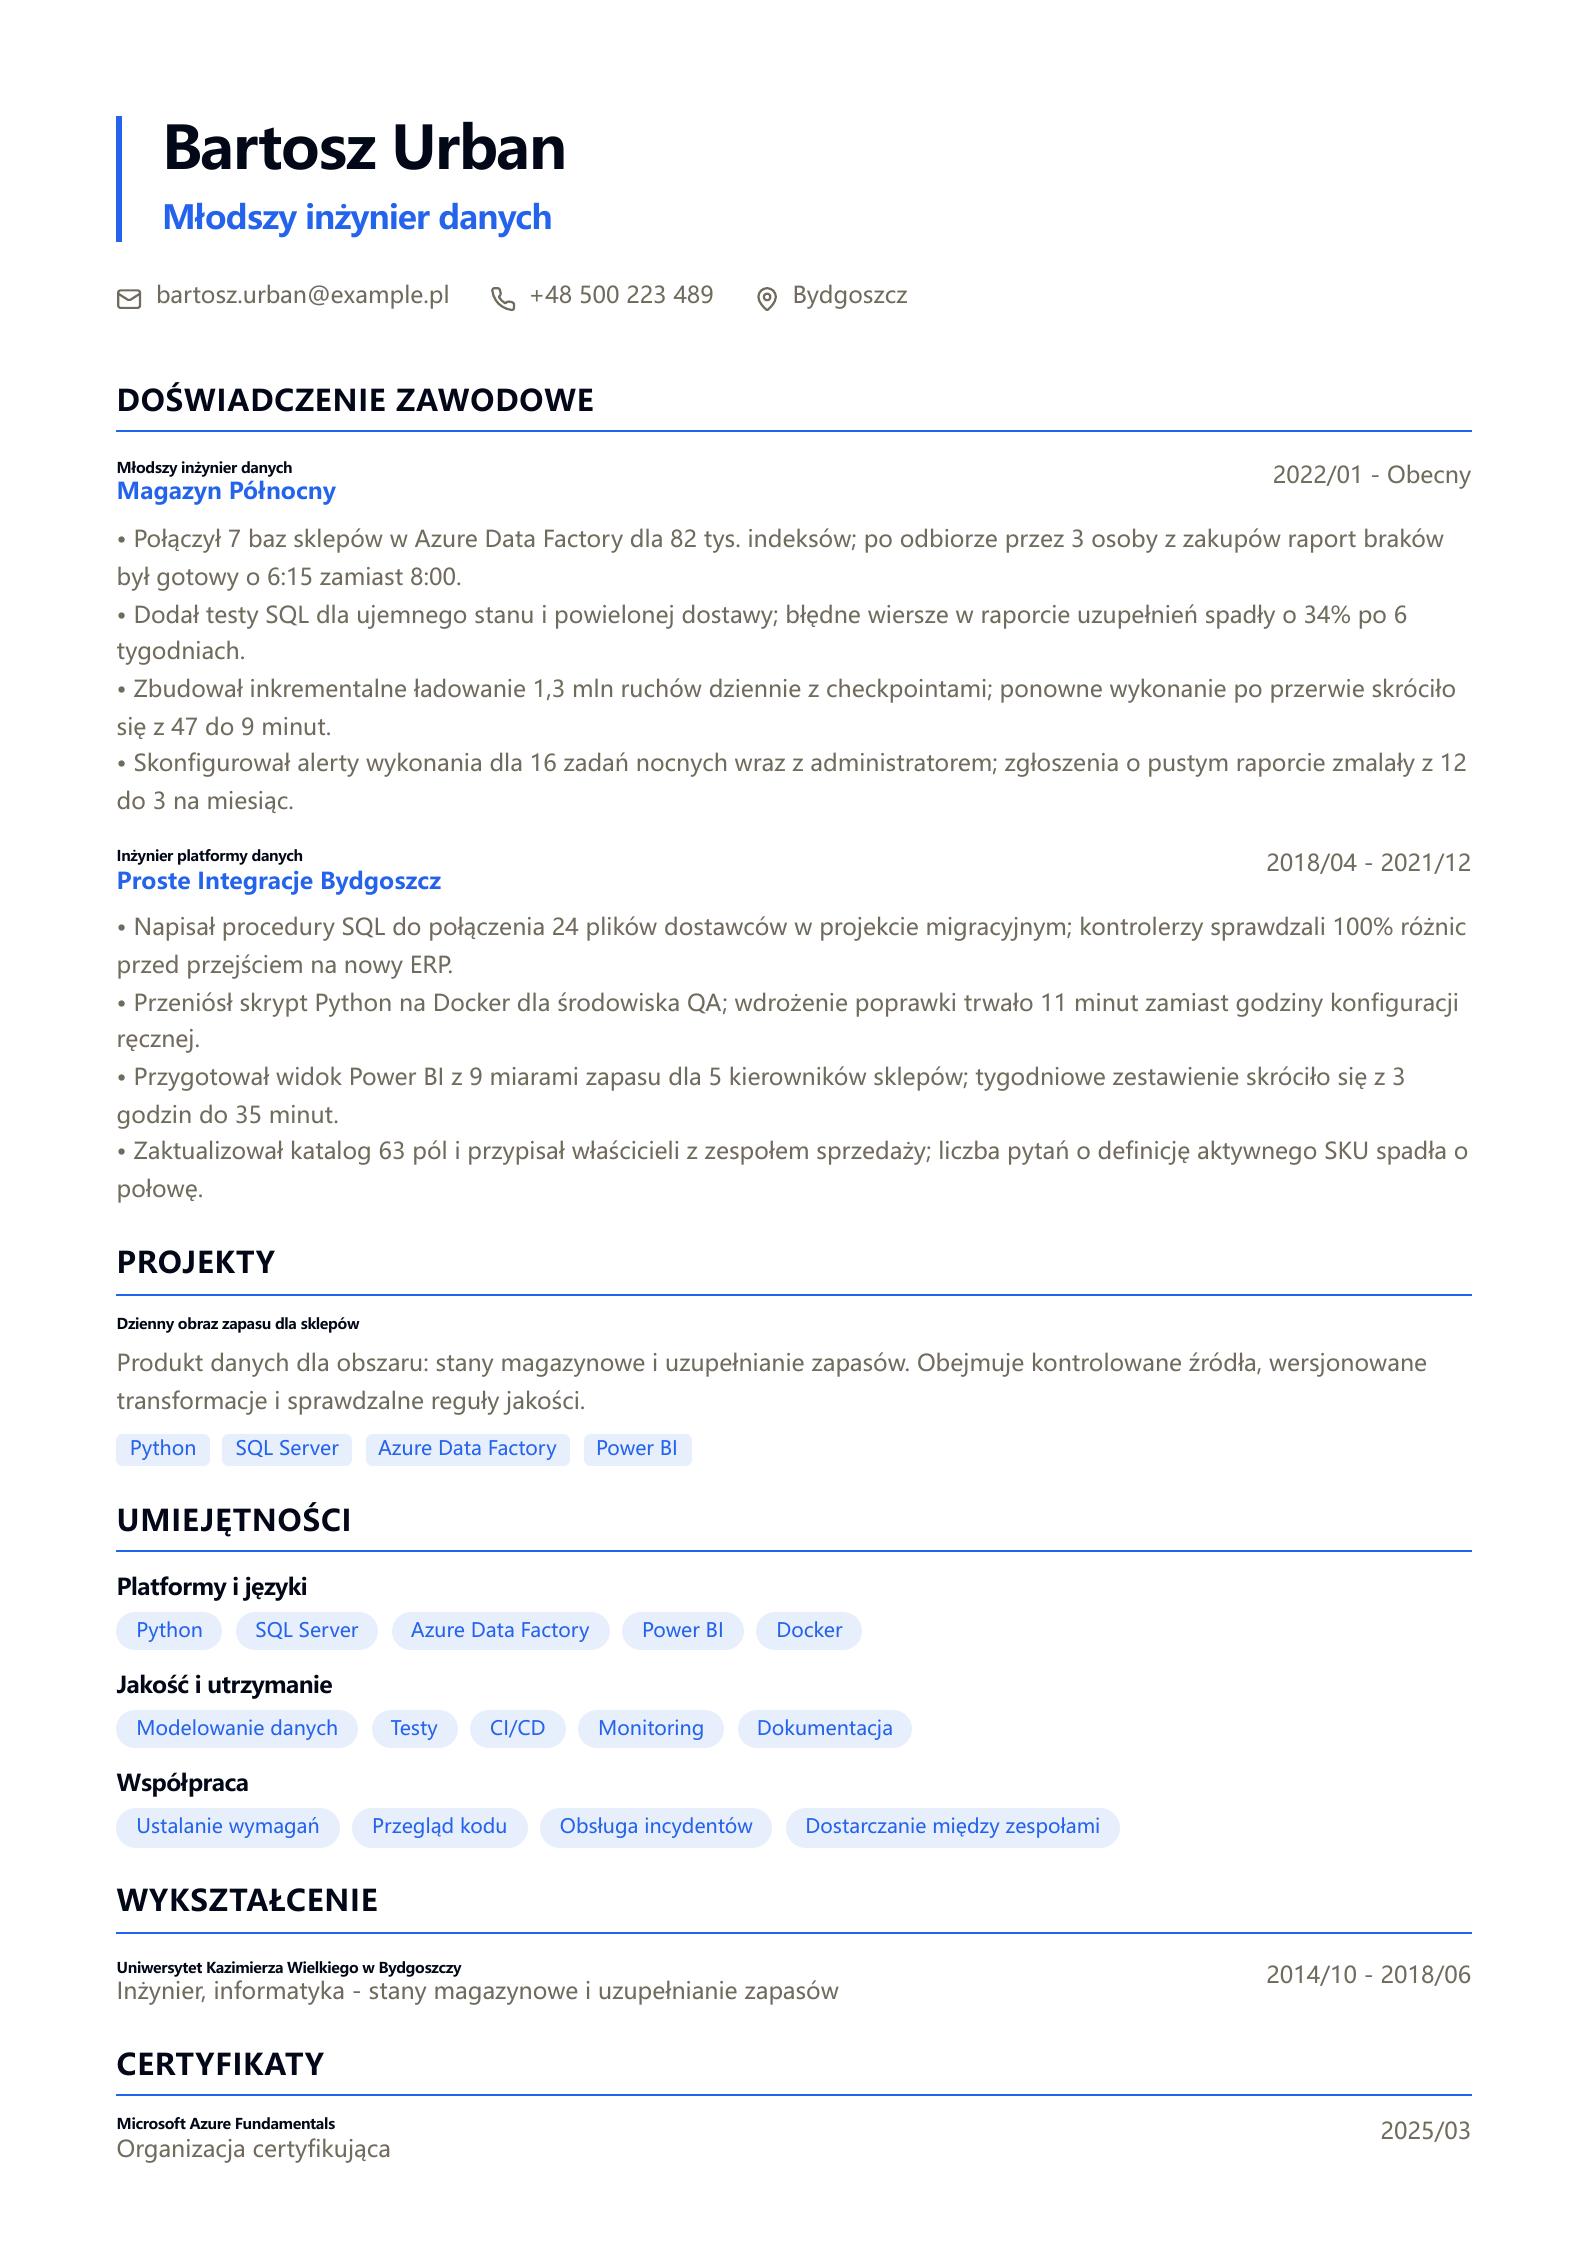
CV dla młodszego inżyniera rozwijającego przepływy ETL i raporty stanów towaru.
Przyda się przy: architektura, kontrakty i mentoring
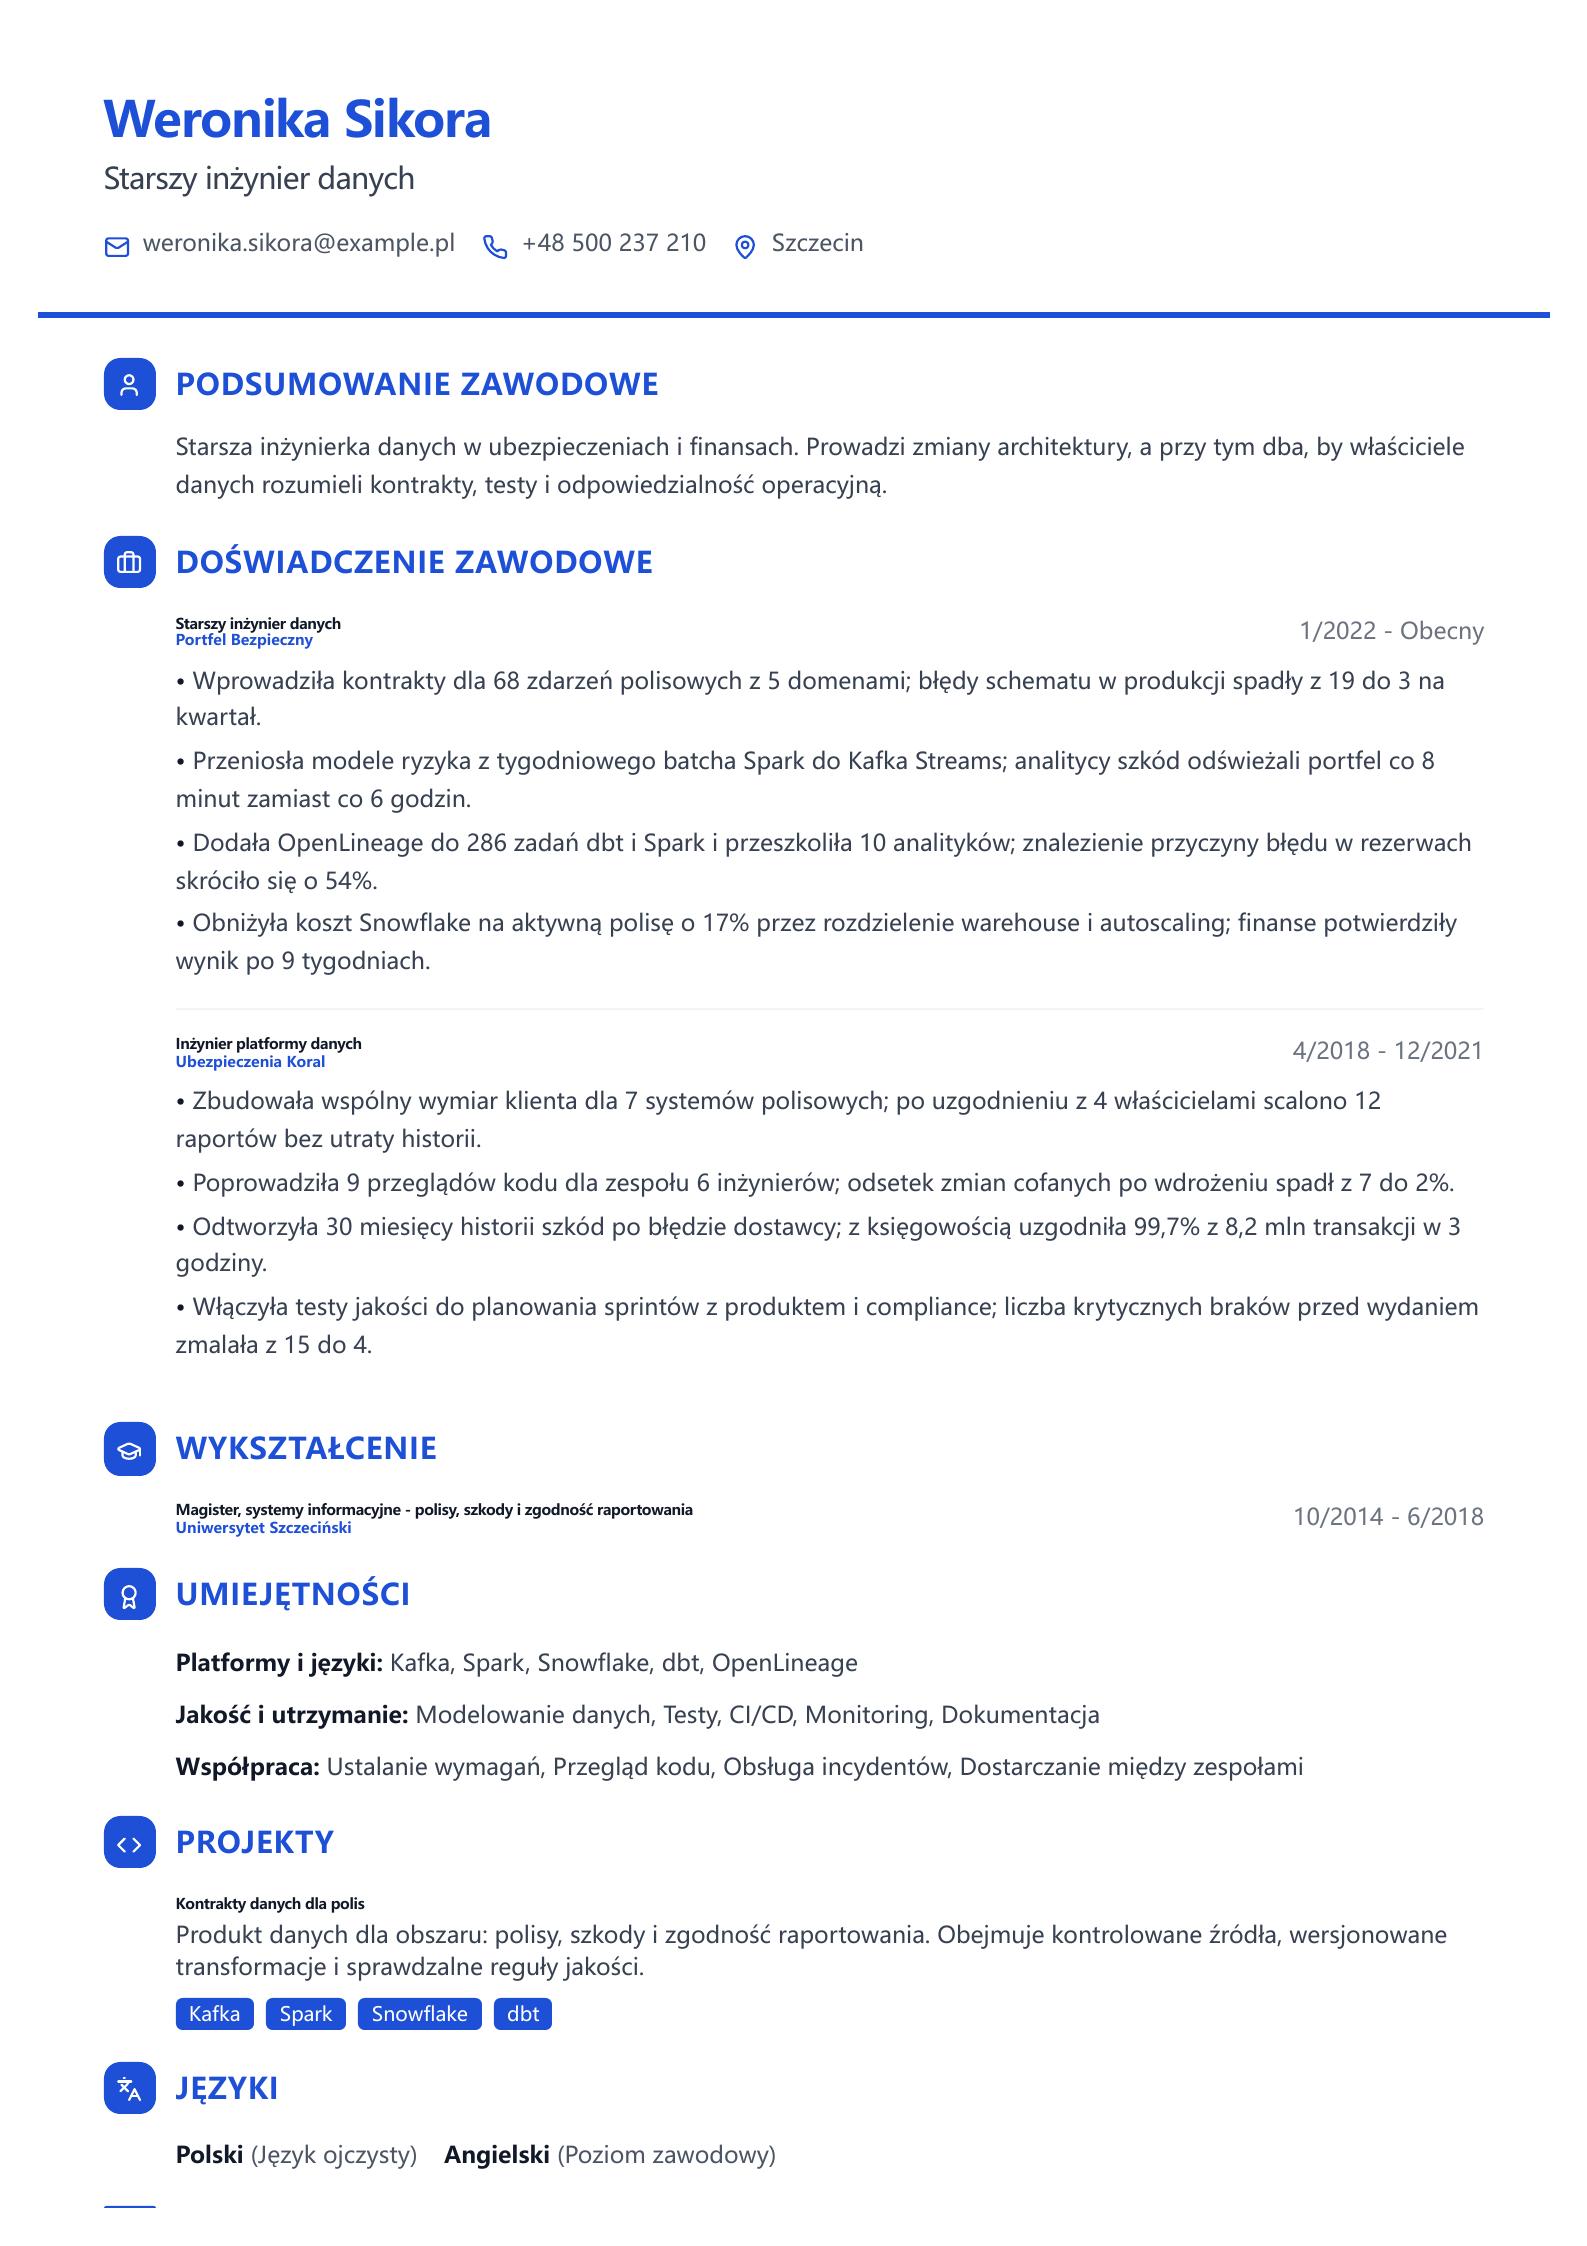
Przykład seniora prowadzącego standardy danych i rozwiązania produkcyjne w finansach.
Przyda się przy: kierunek techniczny i platformy
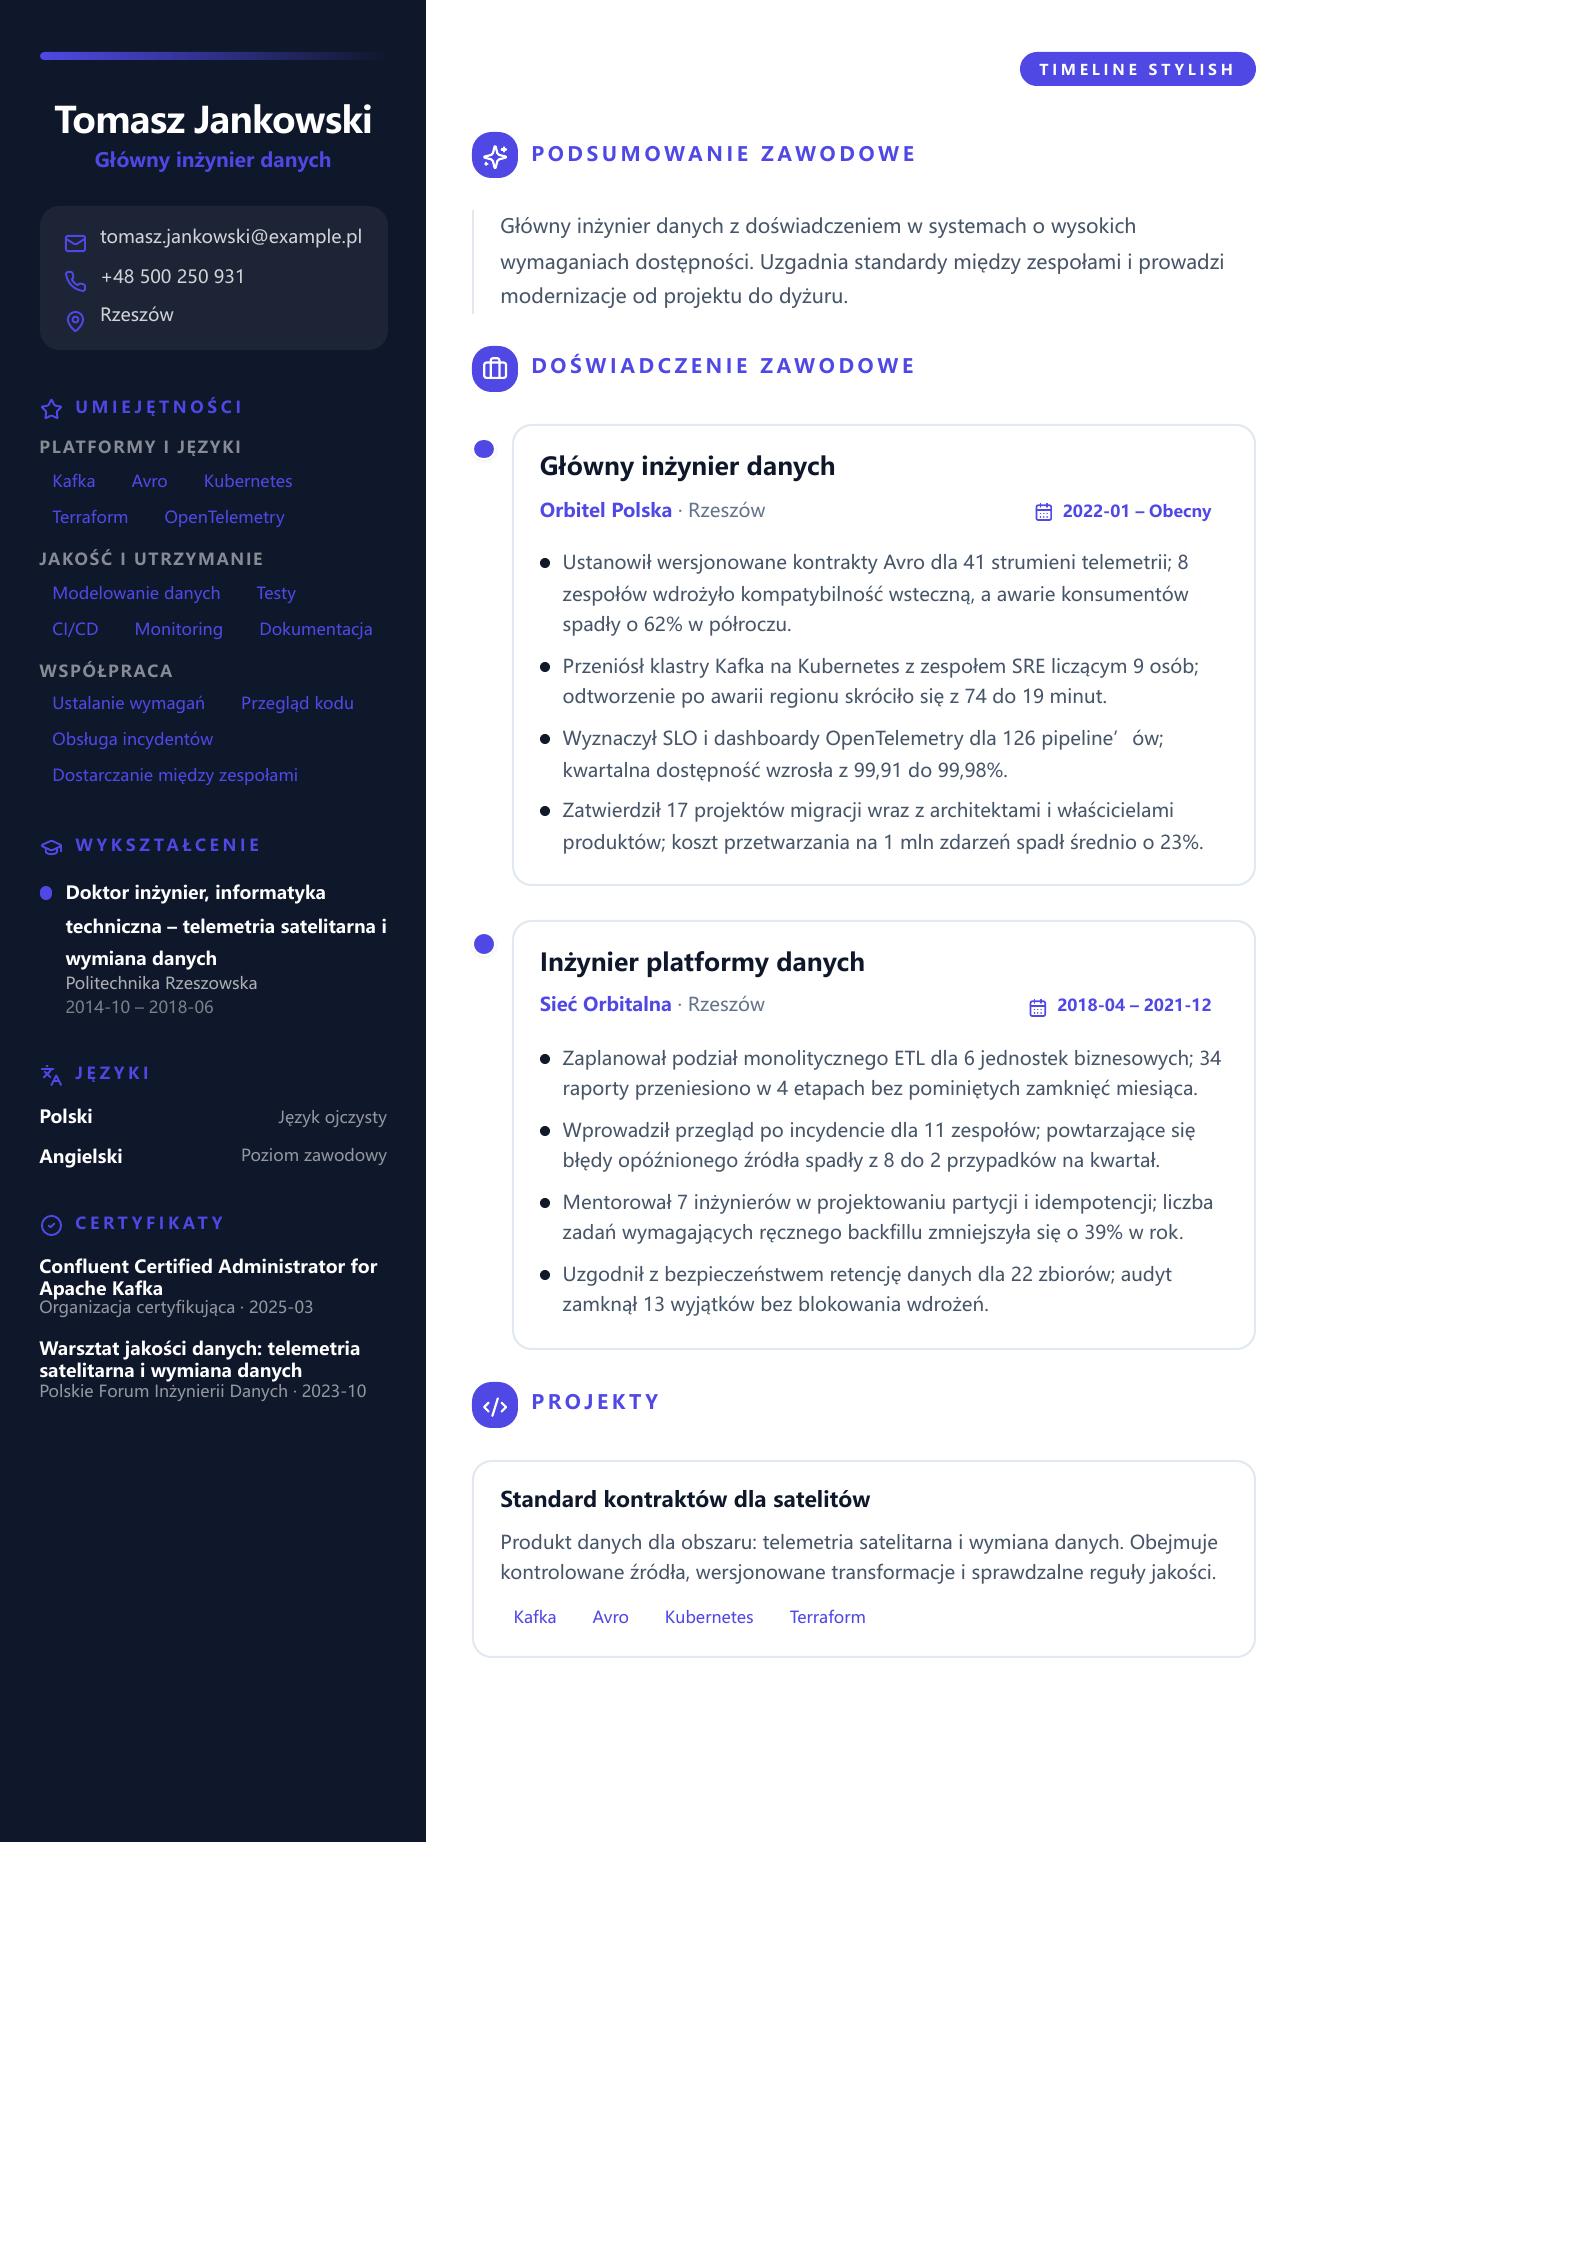
CV osoby odpowiedzialnej za standardy platformy i jej niezawodność w wielu zespołach.
Przyda się przy: PySpark, Delta Lake i przetwarzanie rozproszone
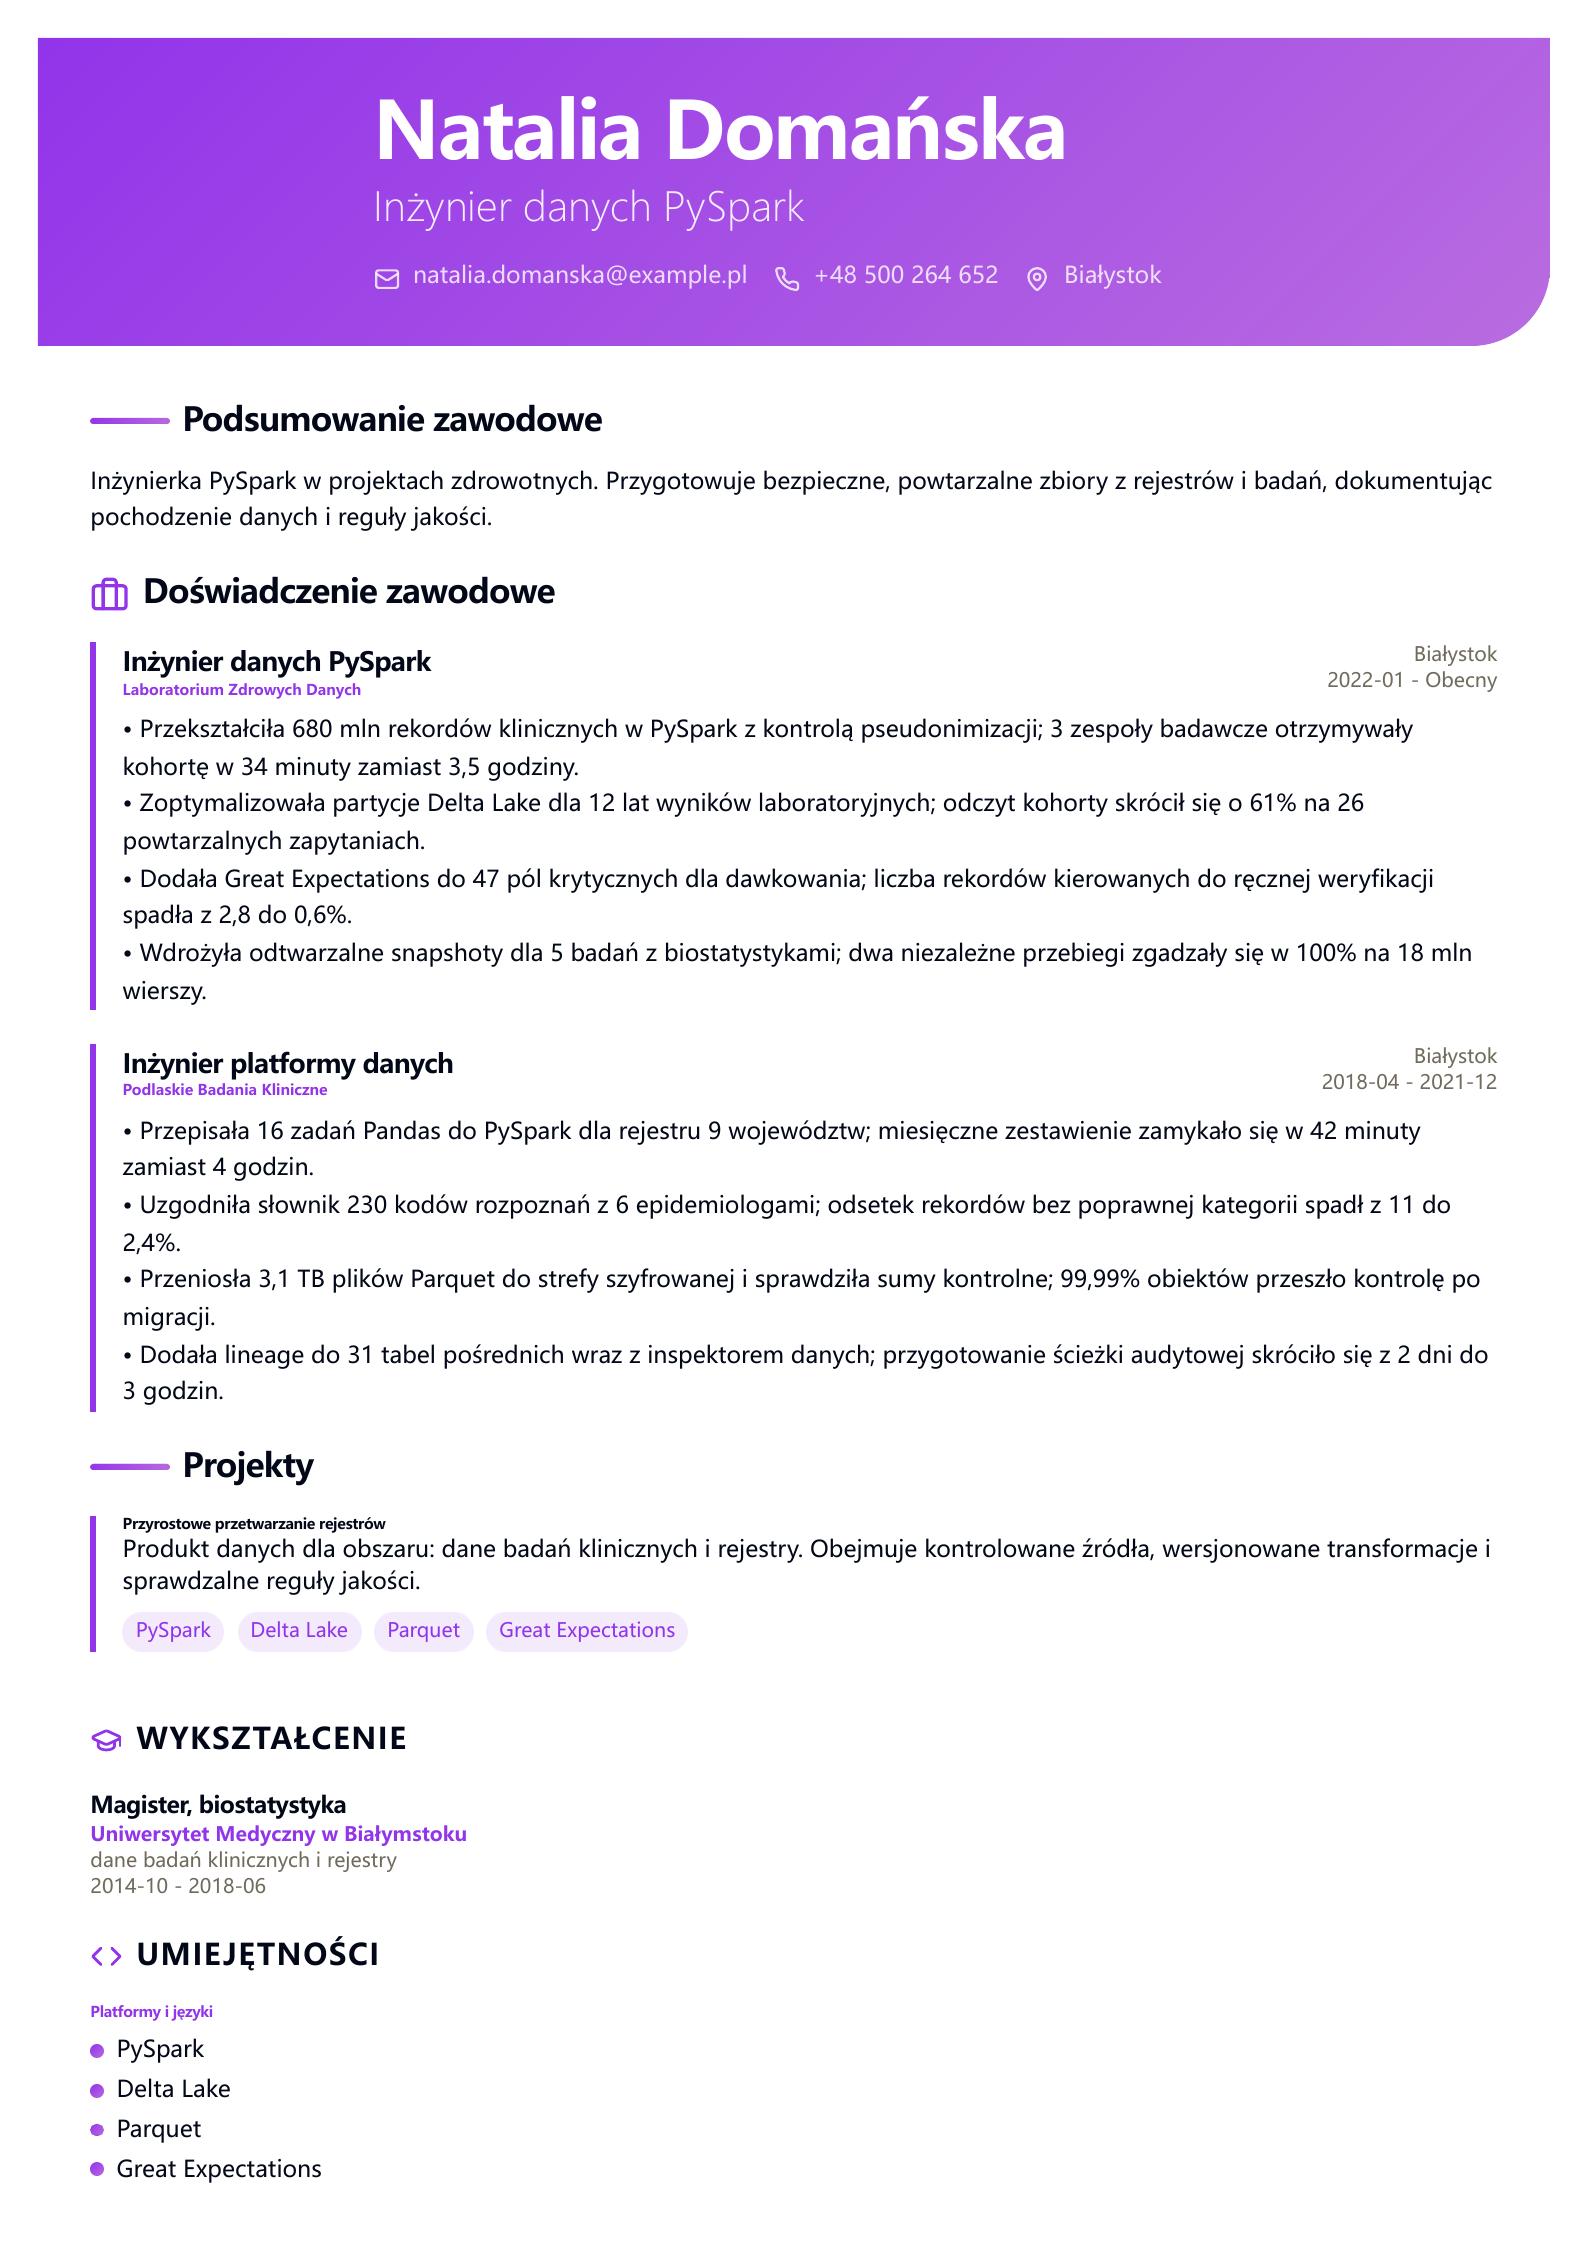
Przykład dla specjalistów Spark pracujących na dużych, wrażliwych zbiorach danych.
Przyda się przy: Python, API i dane przestrzenne
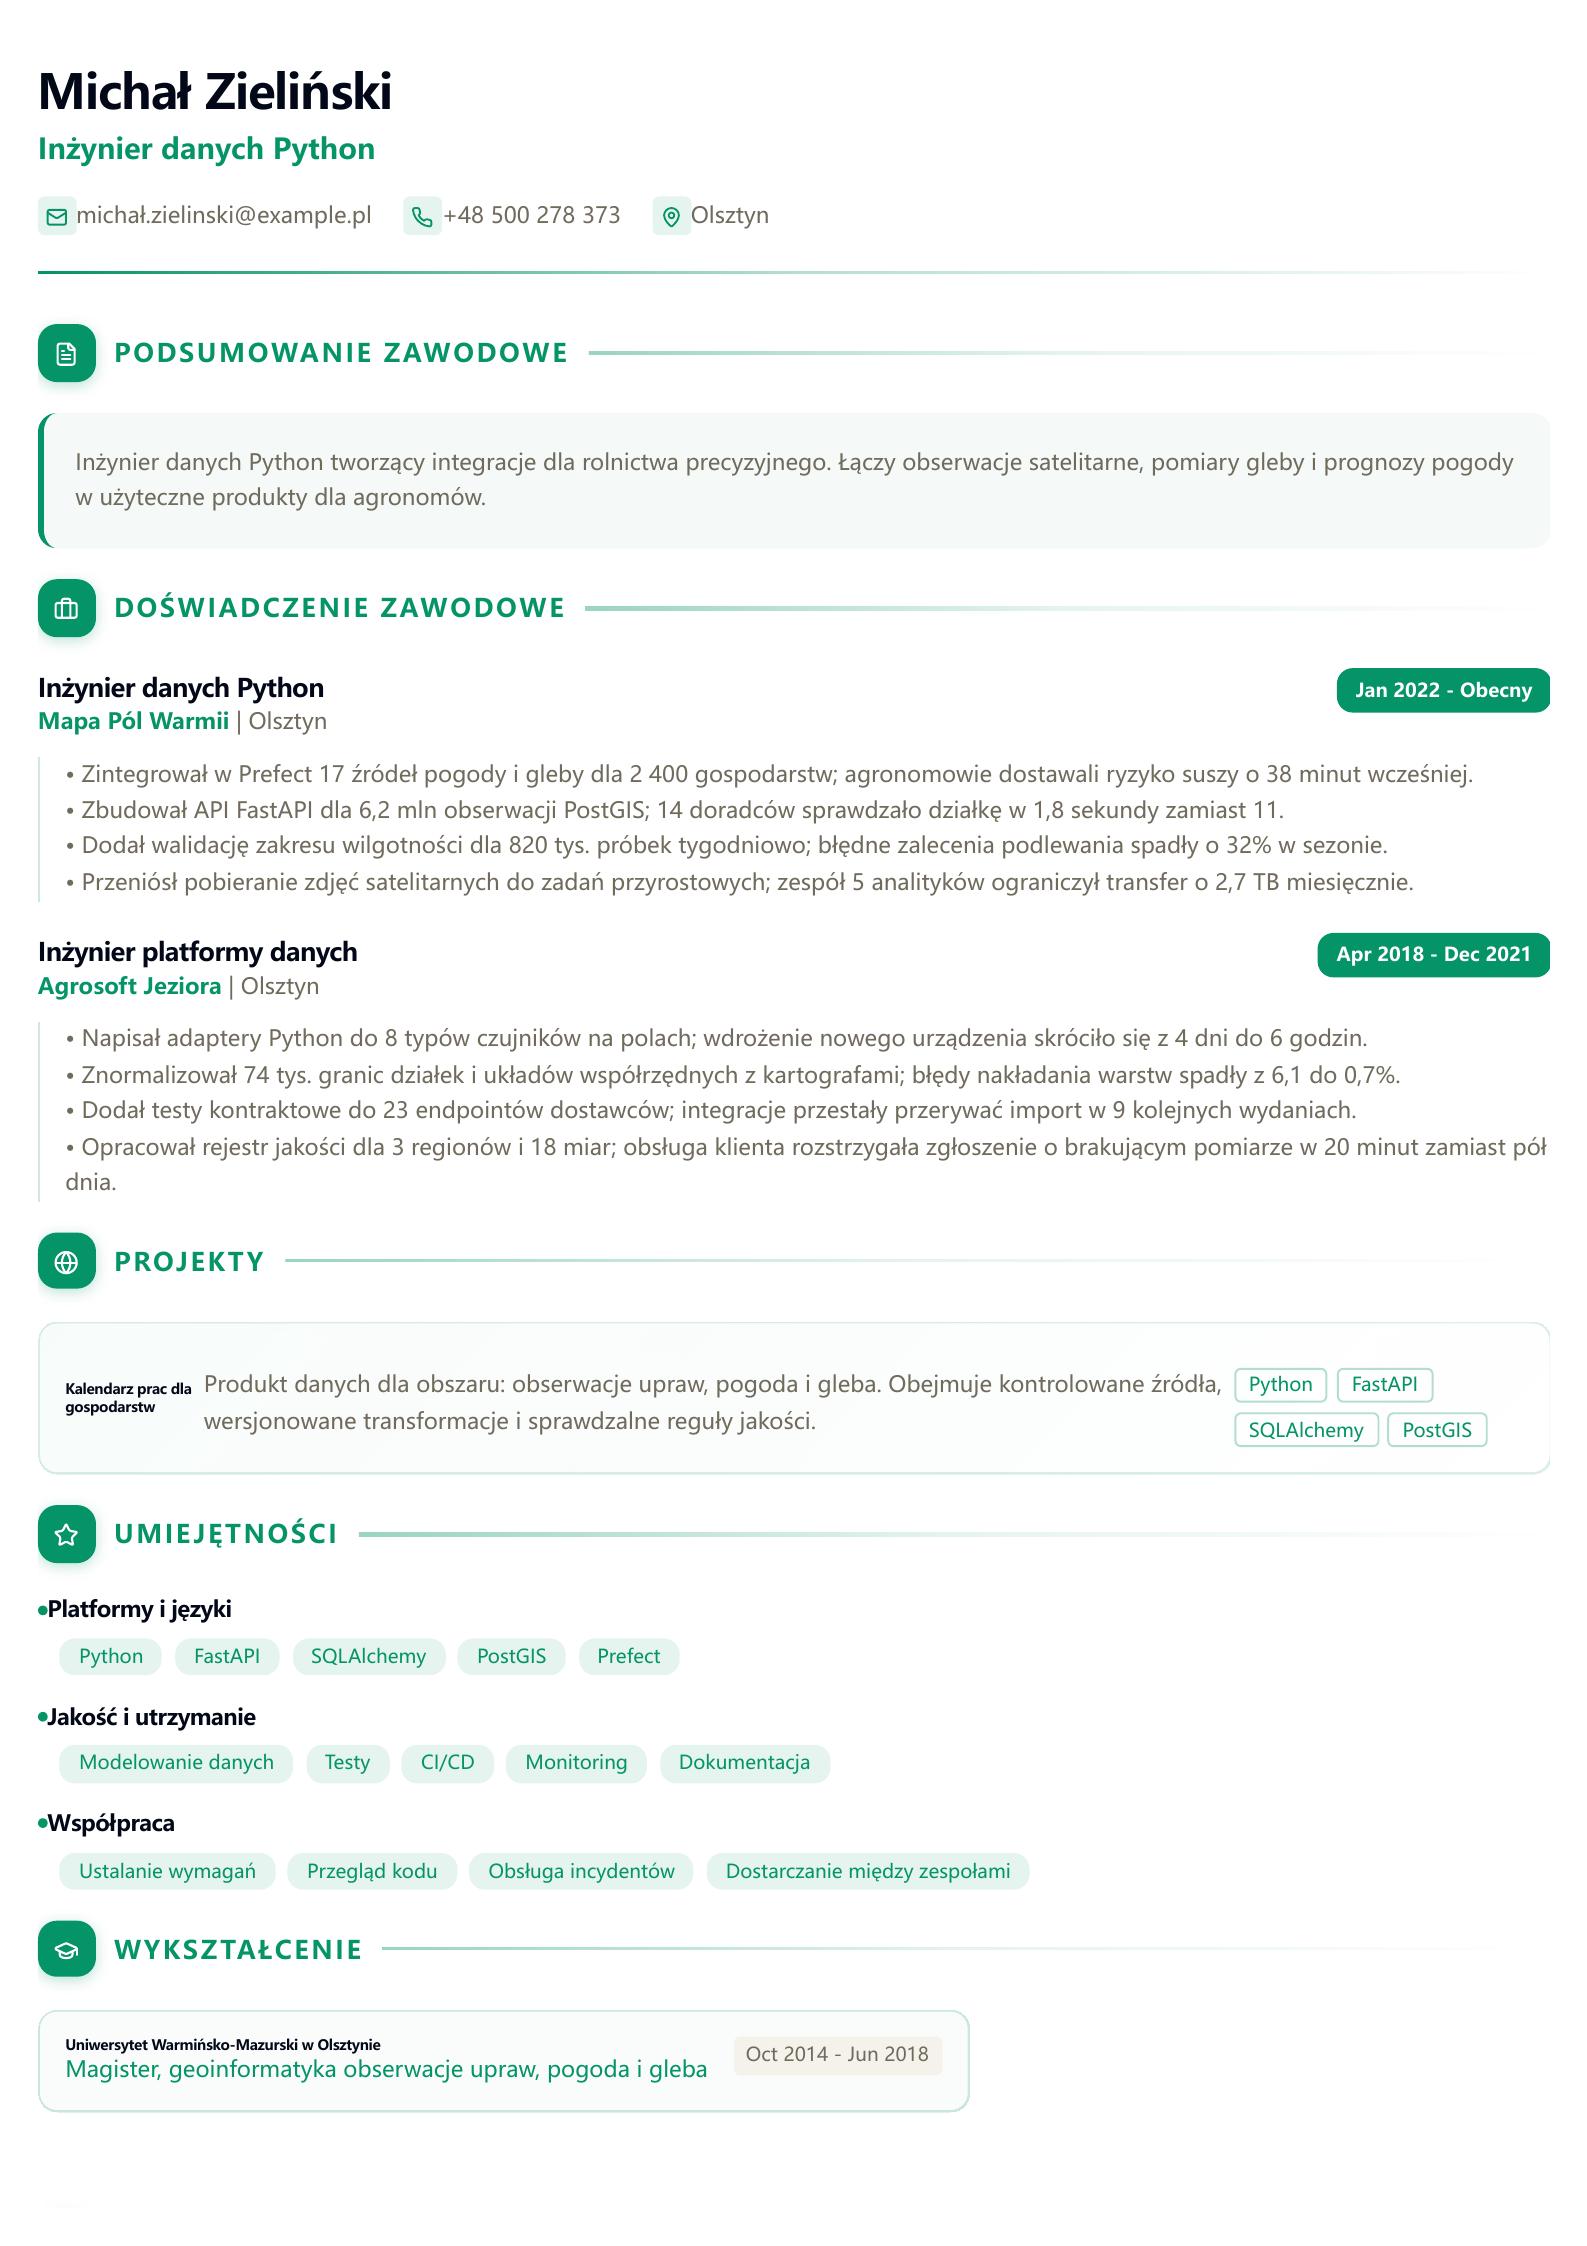
CV skupione na Pythonie, API i danych geograficznych dla planowania prac polowych.
Przyda się przy: zdarzenia produktowe i analityka społeczności
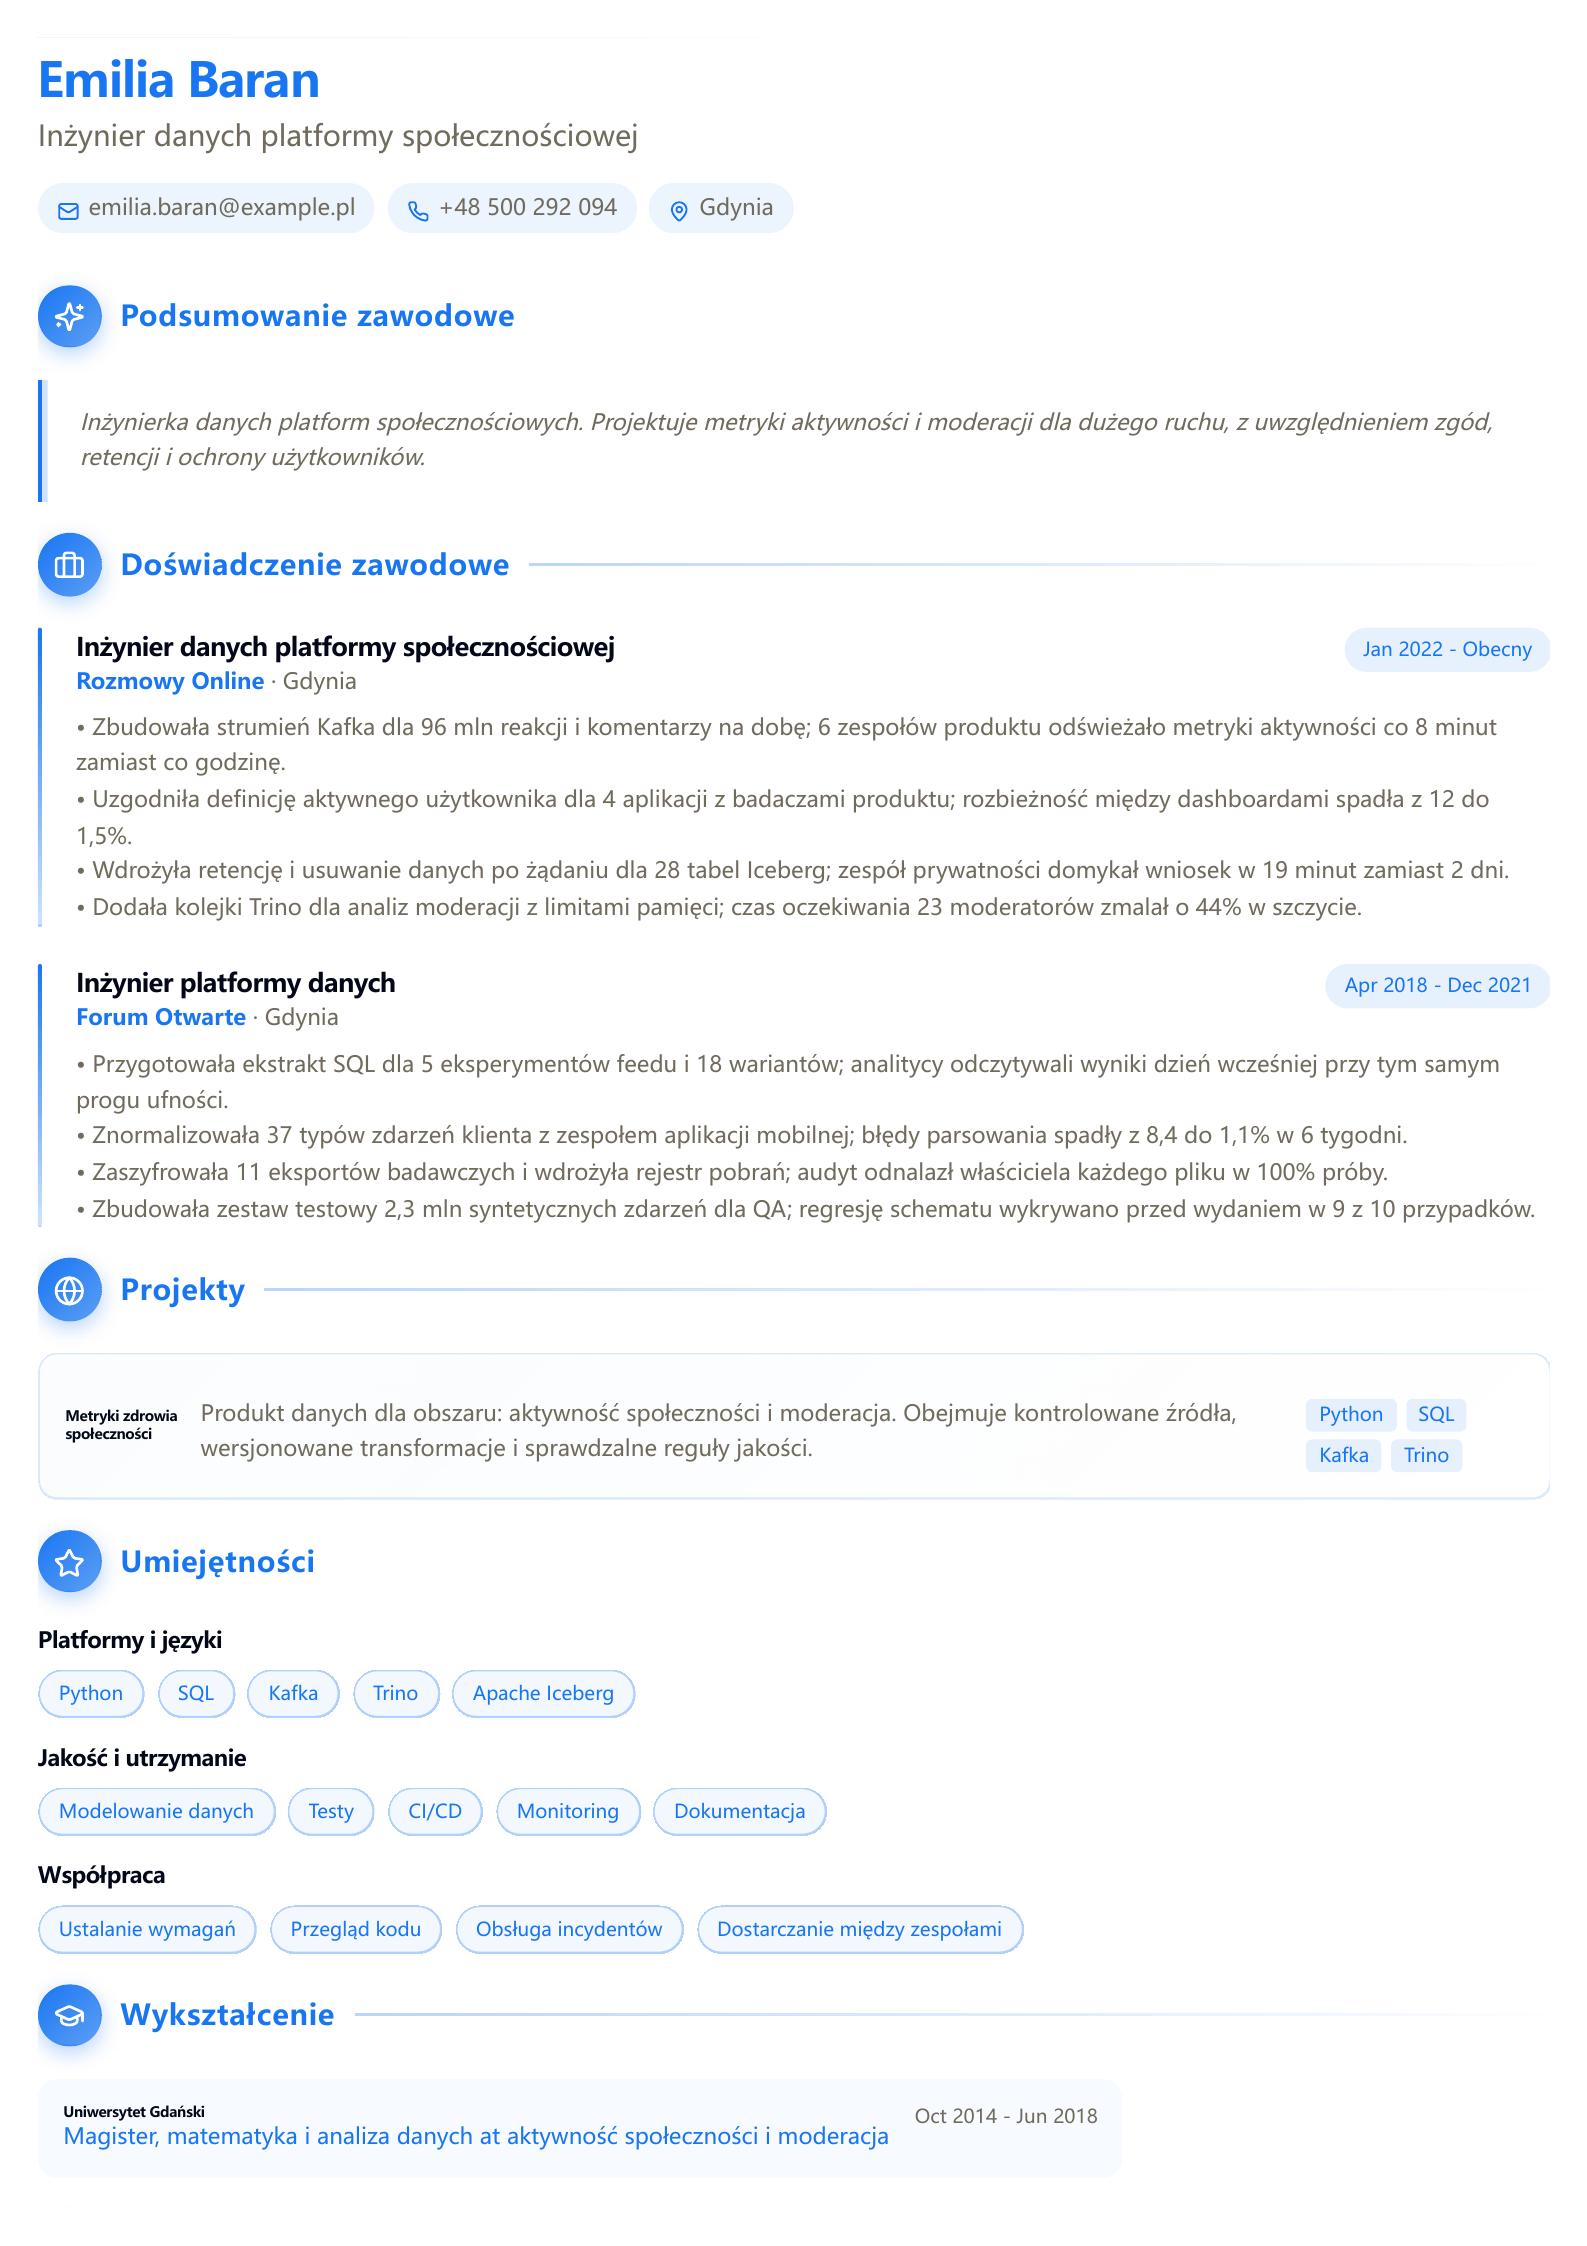
Przykład dla systemów społecznościowych przetwarzających reakcje, komentarze i zdarzenia moderacji.
Przyda się przy: dbt, metryki i samoobsługowe raportowanie
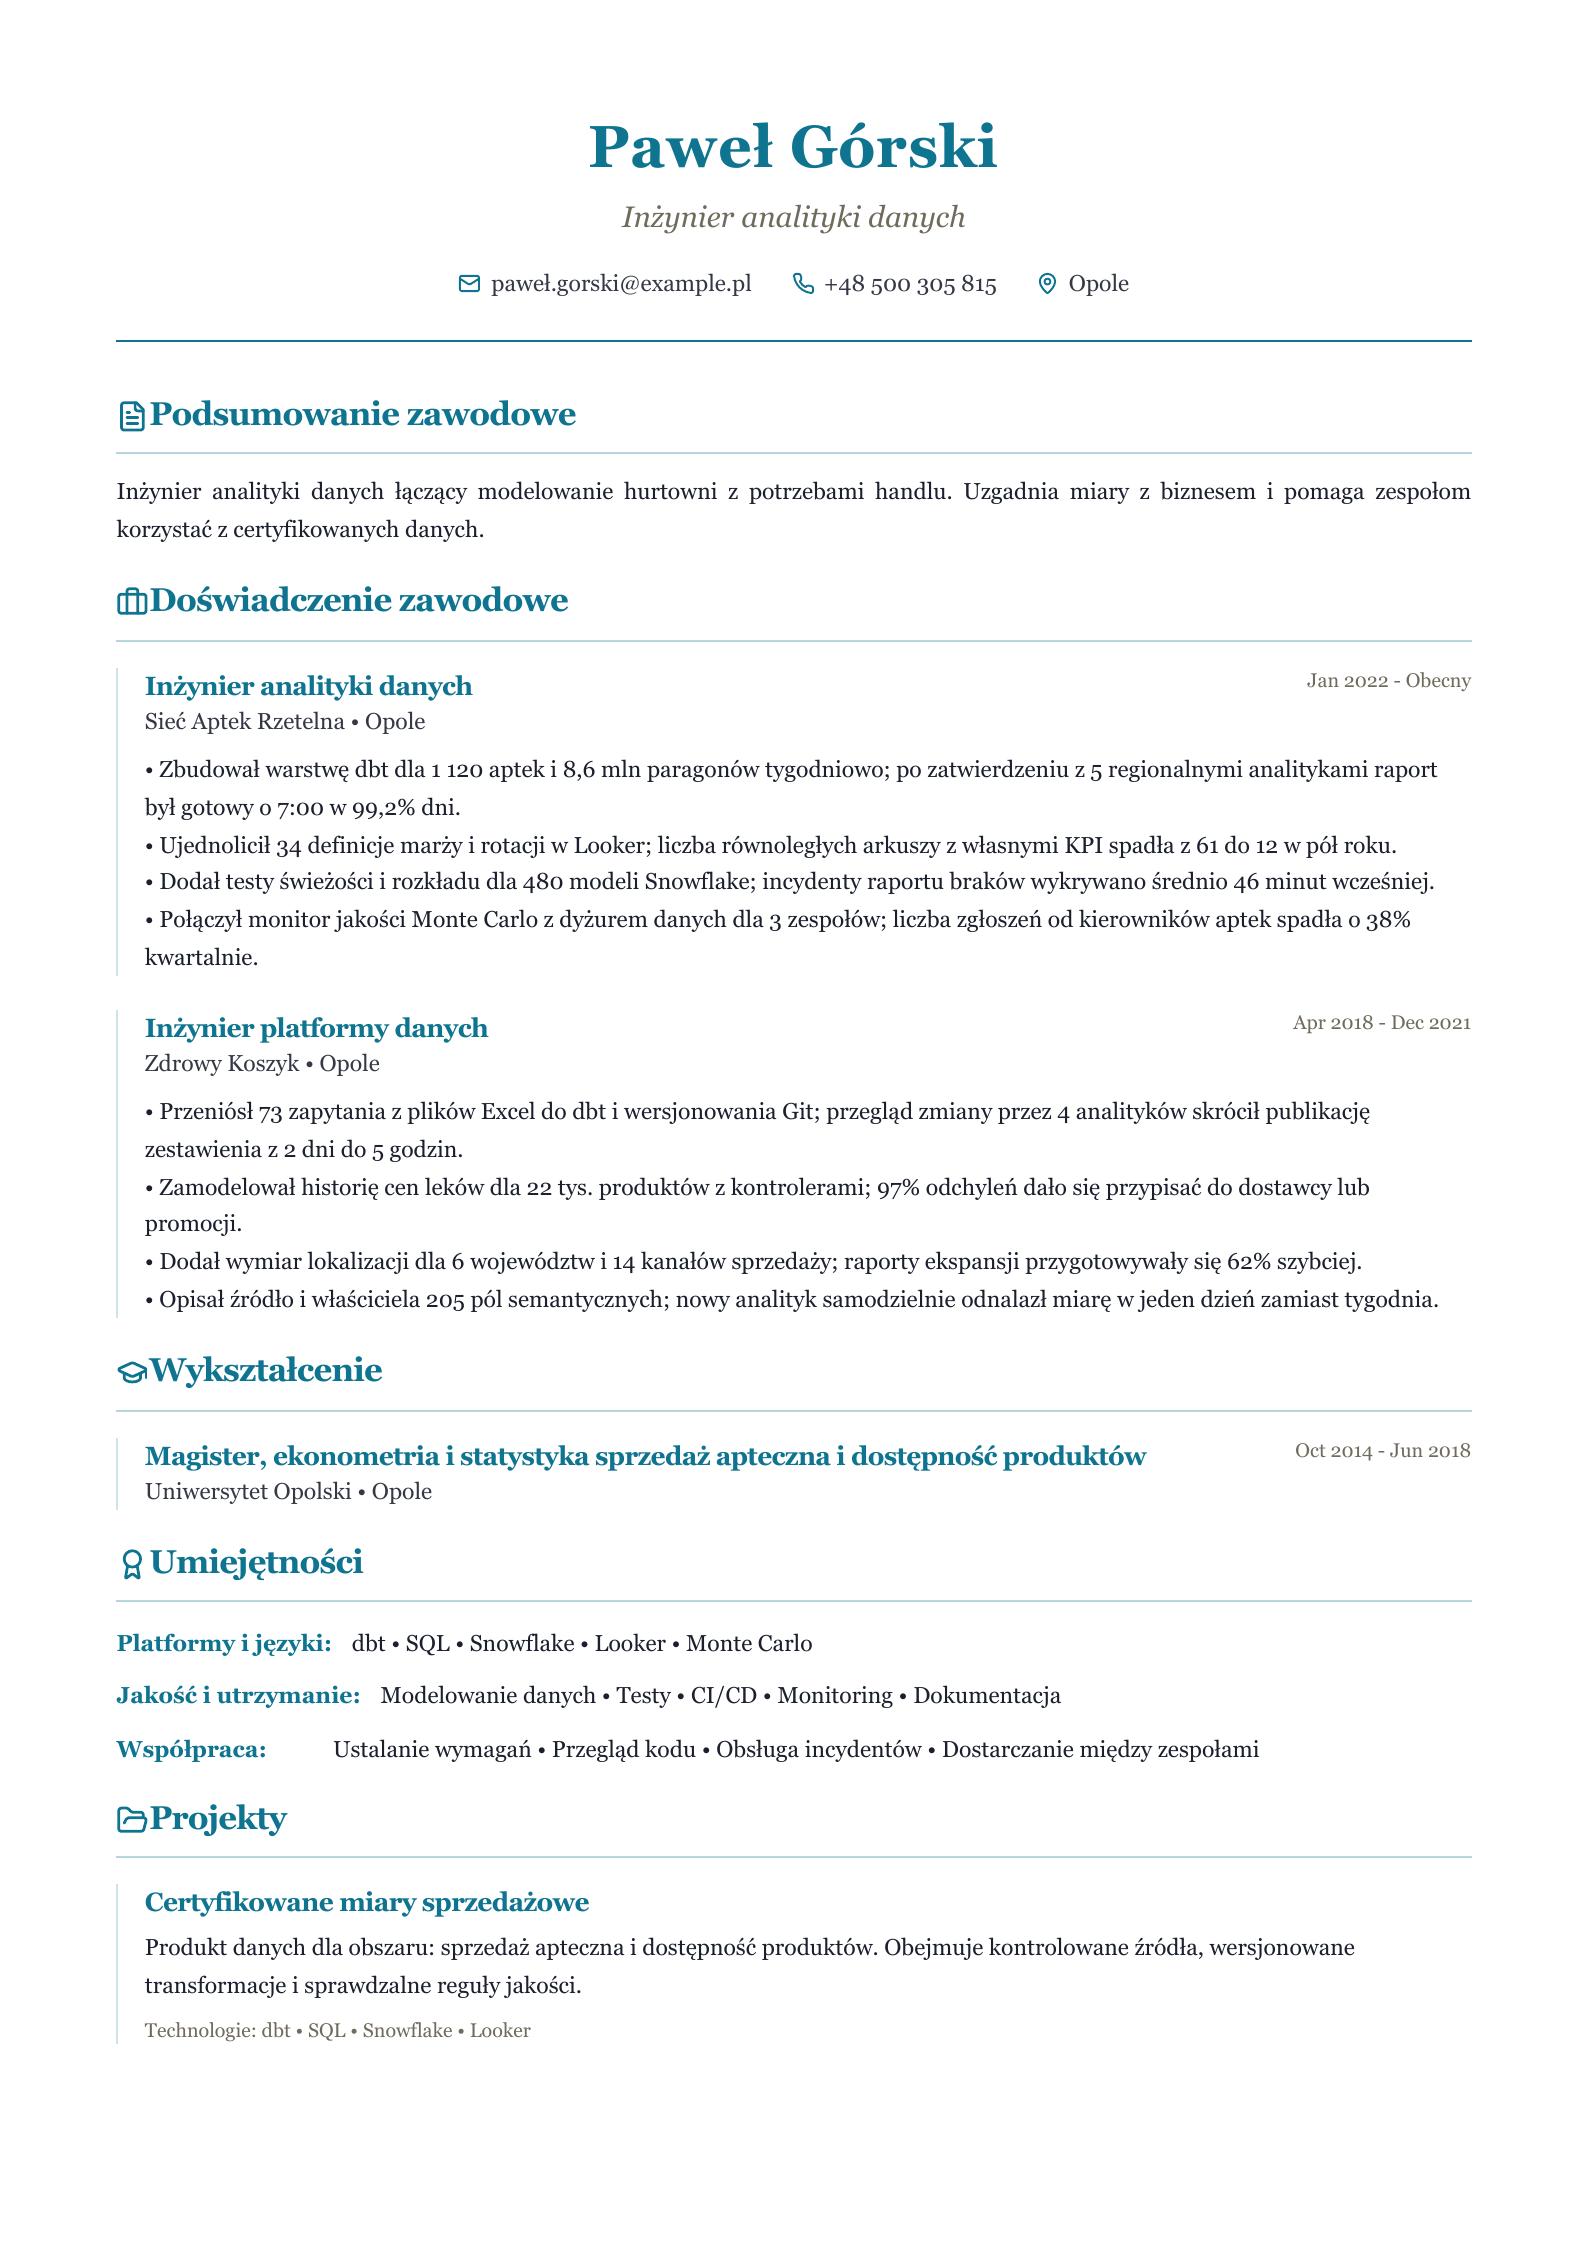
CV dla osoby budującej modele analityczne, warstwę semantyczną i kontrolę jakości raportów.
Przyda się przy: integracje, migracje i zadania wsadowe
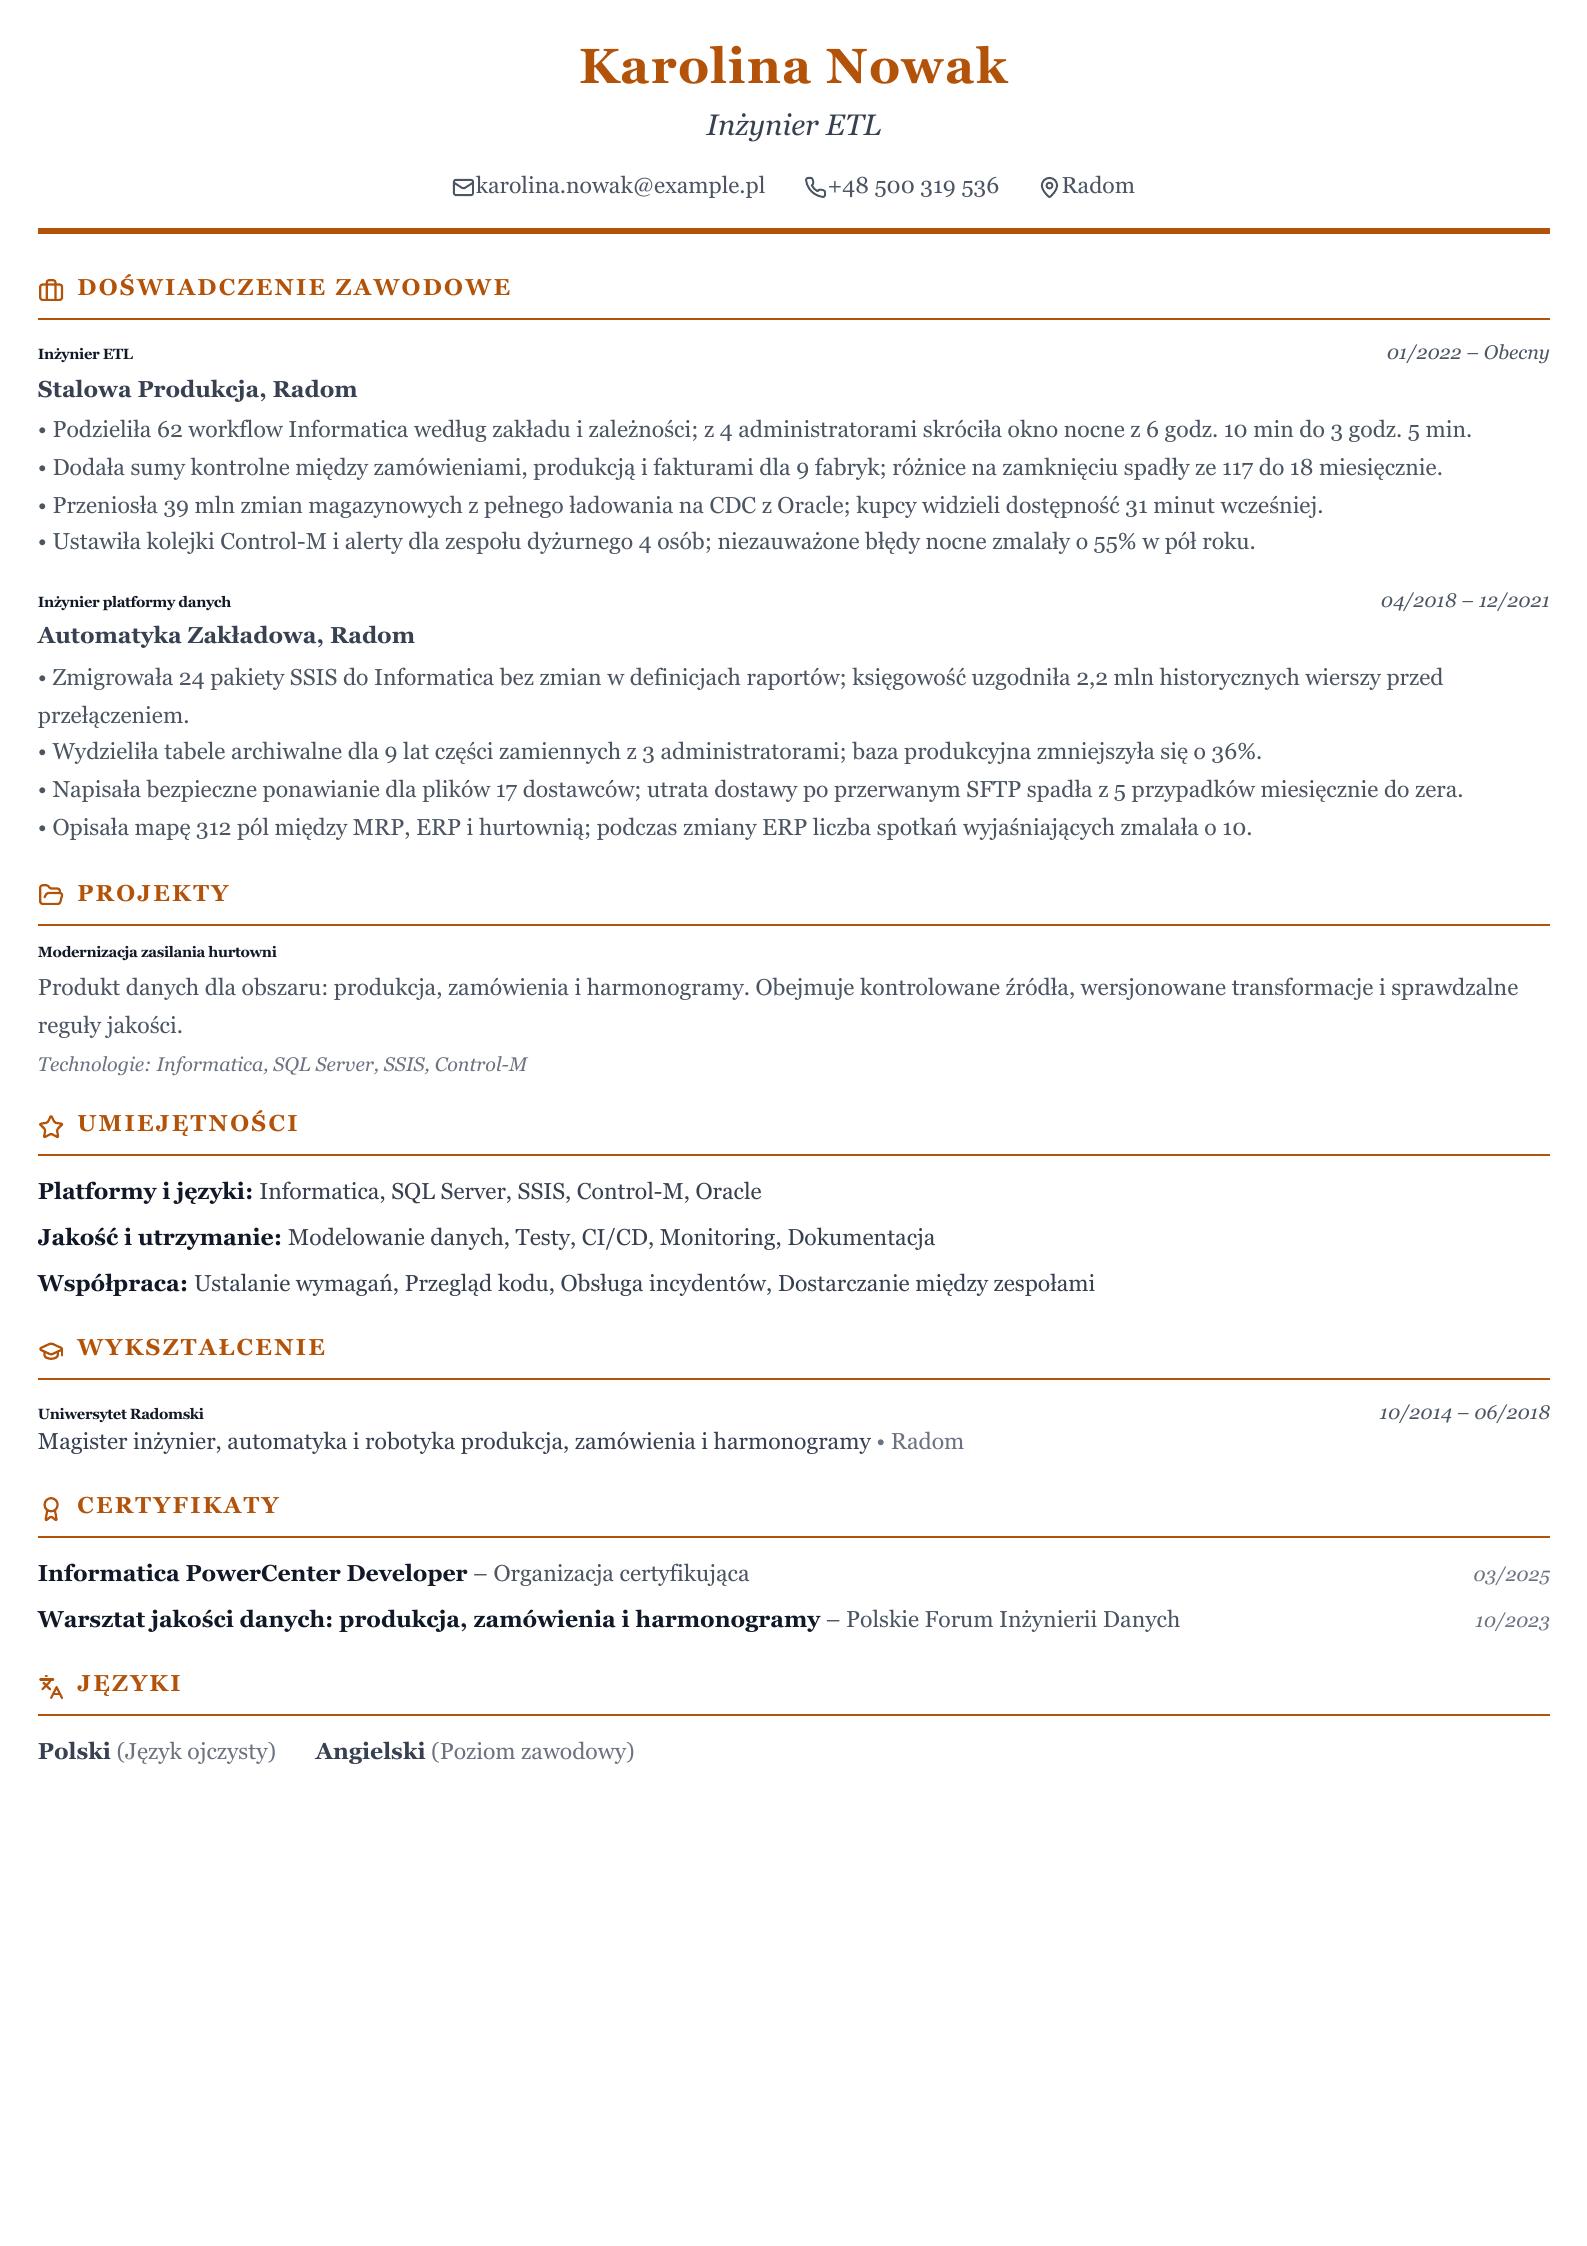
Przykład migracji i stabilizacji ETL w środowisku ERP, produkcji i rozliczeń.
Przyda się przy: zbiory obrazu, anotacje i wersjonowanie
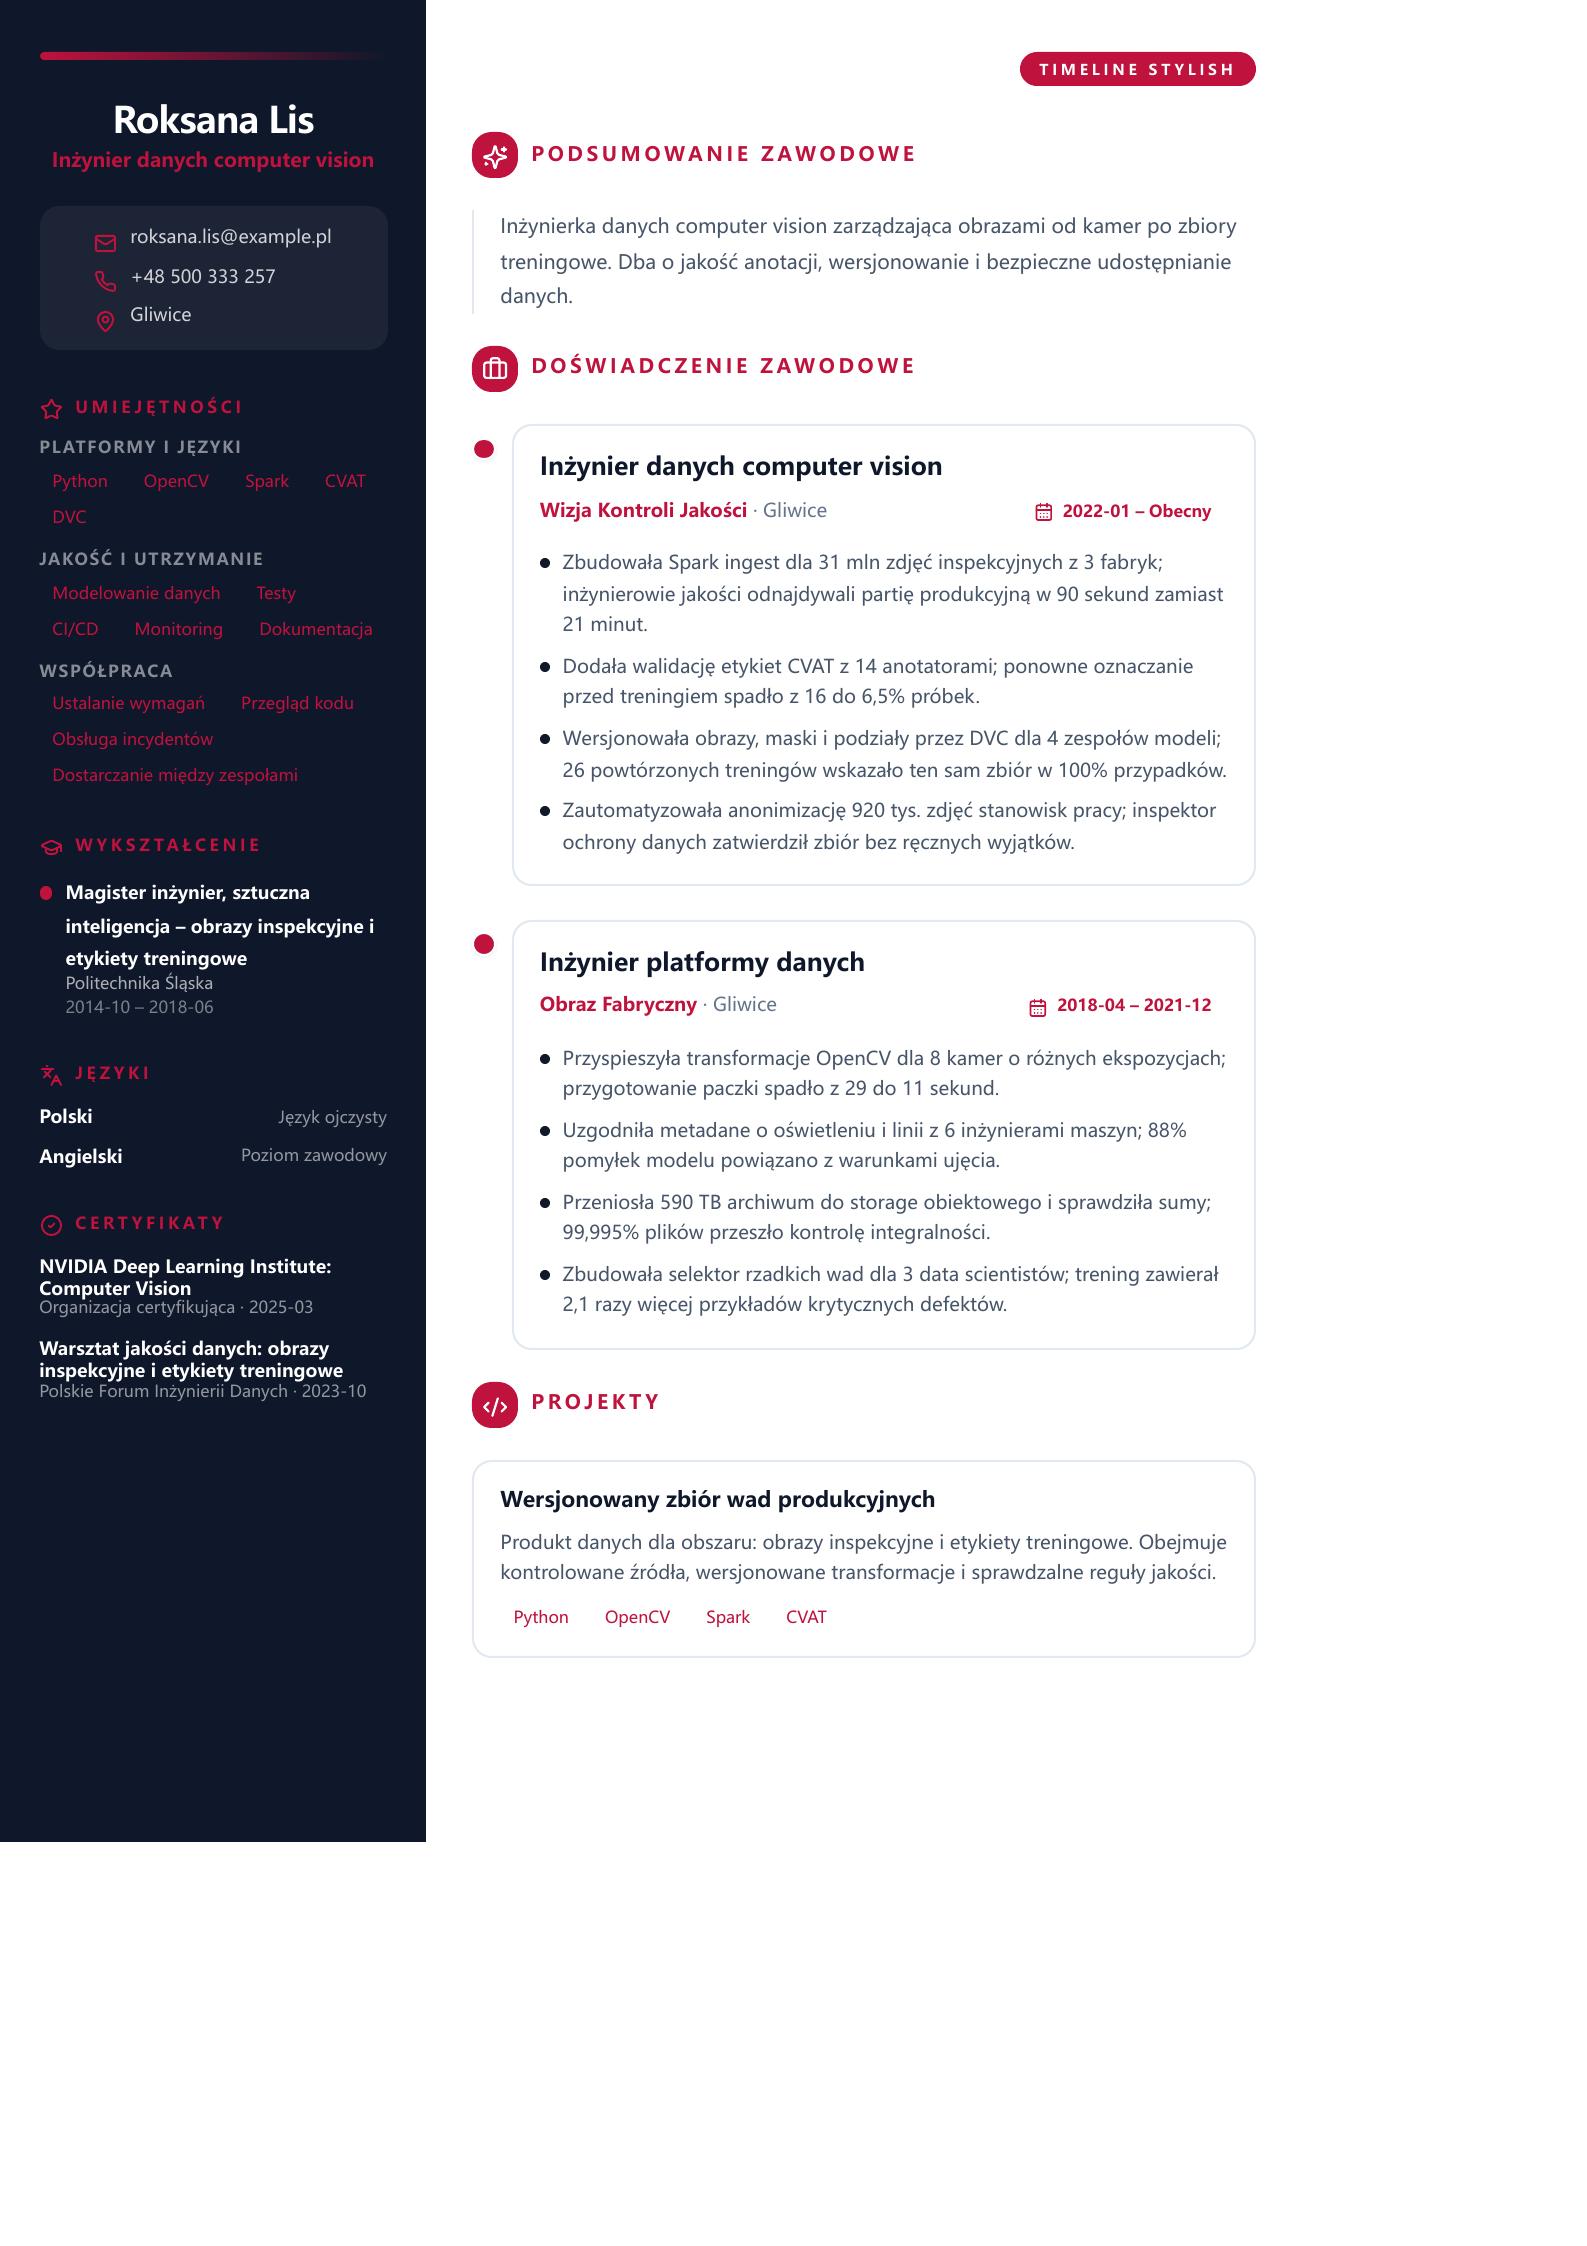
CV pokazuje przygotowanie danych obrazowych dla modeli kontroli jakości w kilku zakładach.
Napisz, co poprawiła Twoja praca: krótsze ładowanie, mniej błędów, niższy koszt albo świeższe dane. Potem wyjaśnij, którą część rozwiązania zaprojektowałaś lub wdrożyłeś.
Podaj źródła, sposób obsługi zmian schematu i to, czy zadanie działało wsadowo, czy w strumieniu. Spark, Airflow lub dbt nabierają znaczenia, kiedy dodasz kontekst wdrożenia.
Liczba rekordów, systemów, rynków albo użytkowników wyjaśnia złożoność zadania. Wspomnij też o osobach, z którymi ustalałeś wymagania: programistach, analitykach, finansach, utrzymaniu lub bezpieczeństwie.
Podaj punkt wyjścia, wynik i okres pomiaru. Korzystaj z logów, raportów kosztowych, kontroli jakości albo SLA. Jeśli nie umiesz wyjaśnić źródła liczby, lepiej opisz ją inaczej.
Przykład konkretnego punktu doświadczenia
• Przebudowałam w Spark przyrostowy przepływ dla 175 tys. dziennych plików z czujników; z 5 inżynierami platformy skróciłam medianę aktualizacji z 49 do 16 minut, mierzoną przez 8 tygodni.
Na początku kariery zwykle wystarczy jedna strona. Przy kilku wdrożeniach produkcyjnych, platformach i odpowiedzialności operacyjnej użyj dwóch. Zostaw tylko doświadczenie związane z rolą, o którą się ubiegasz.
Wybierz języki, usługi chmurowe, silniki baz danych, narzędzia orkiestracji i przetwarzania, których rzeczywiście używałeś. W punktach doświadczenia pokaż, do czego ich użyłeś i jaki przyniosło to efekt.
Uwzględnij staż, projekt ze studiów lub własny przepływ danych. Opisz źródła, transformacje, testy, odbiorców wyniku oraz ograniczenia, które musiałeś rozwiązać.
Sprawdź czas przetwarzania, świeżość danych, koszt, odsetek błędów lub dostępność. Podaj okres i źródło pomiaru, a swój wkład oddziel od efektów pracy całego zespołu.