CV-exempel för Data Engineer
Passar dig som: pipelines, datamodellering och drift
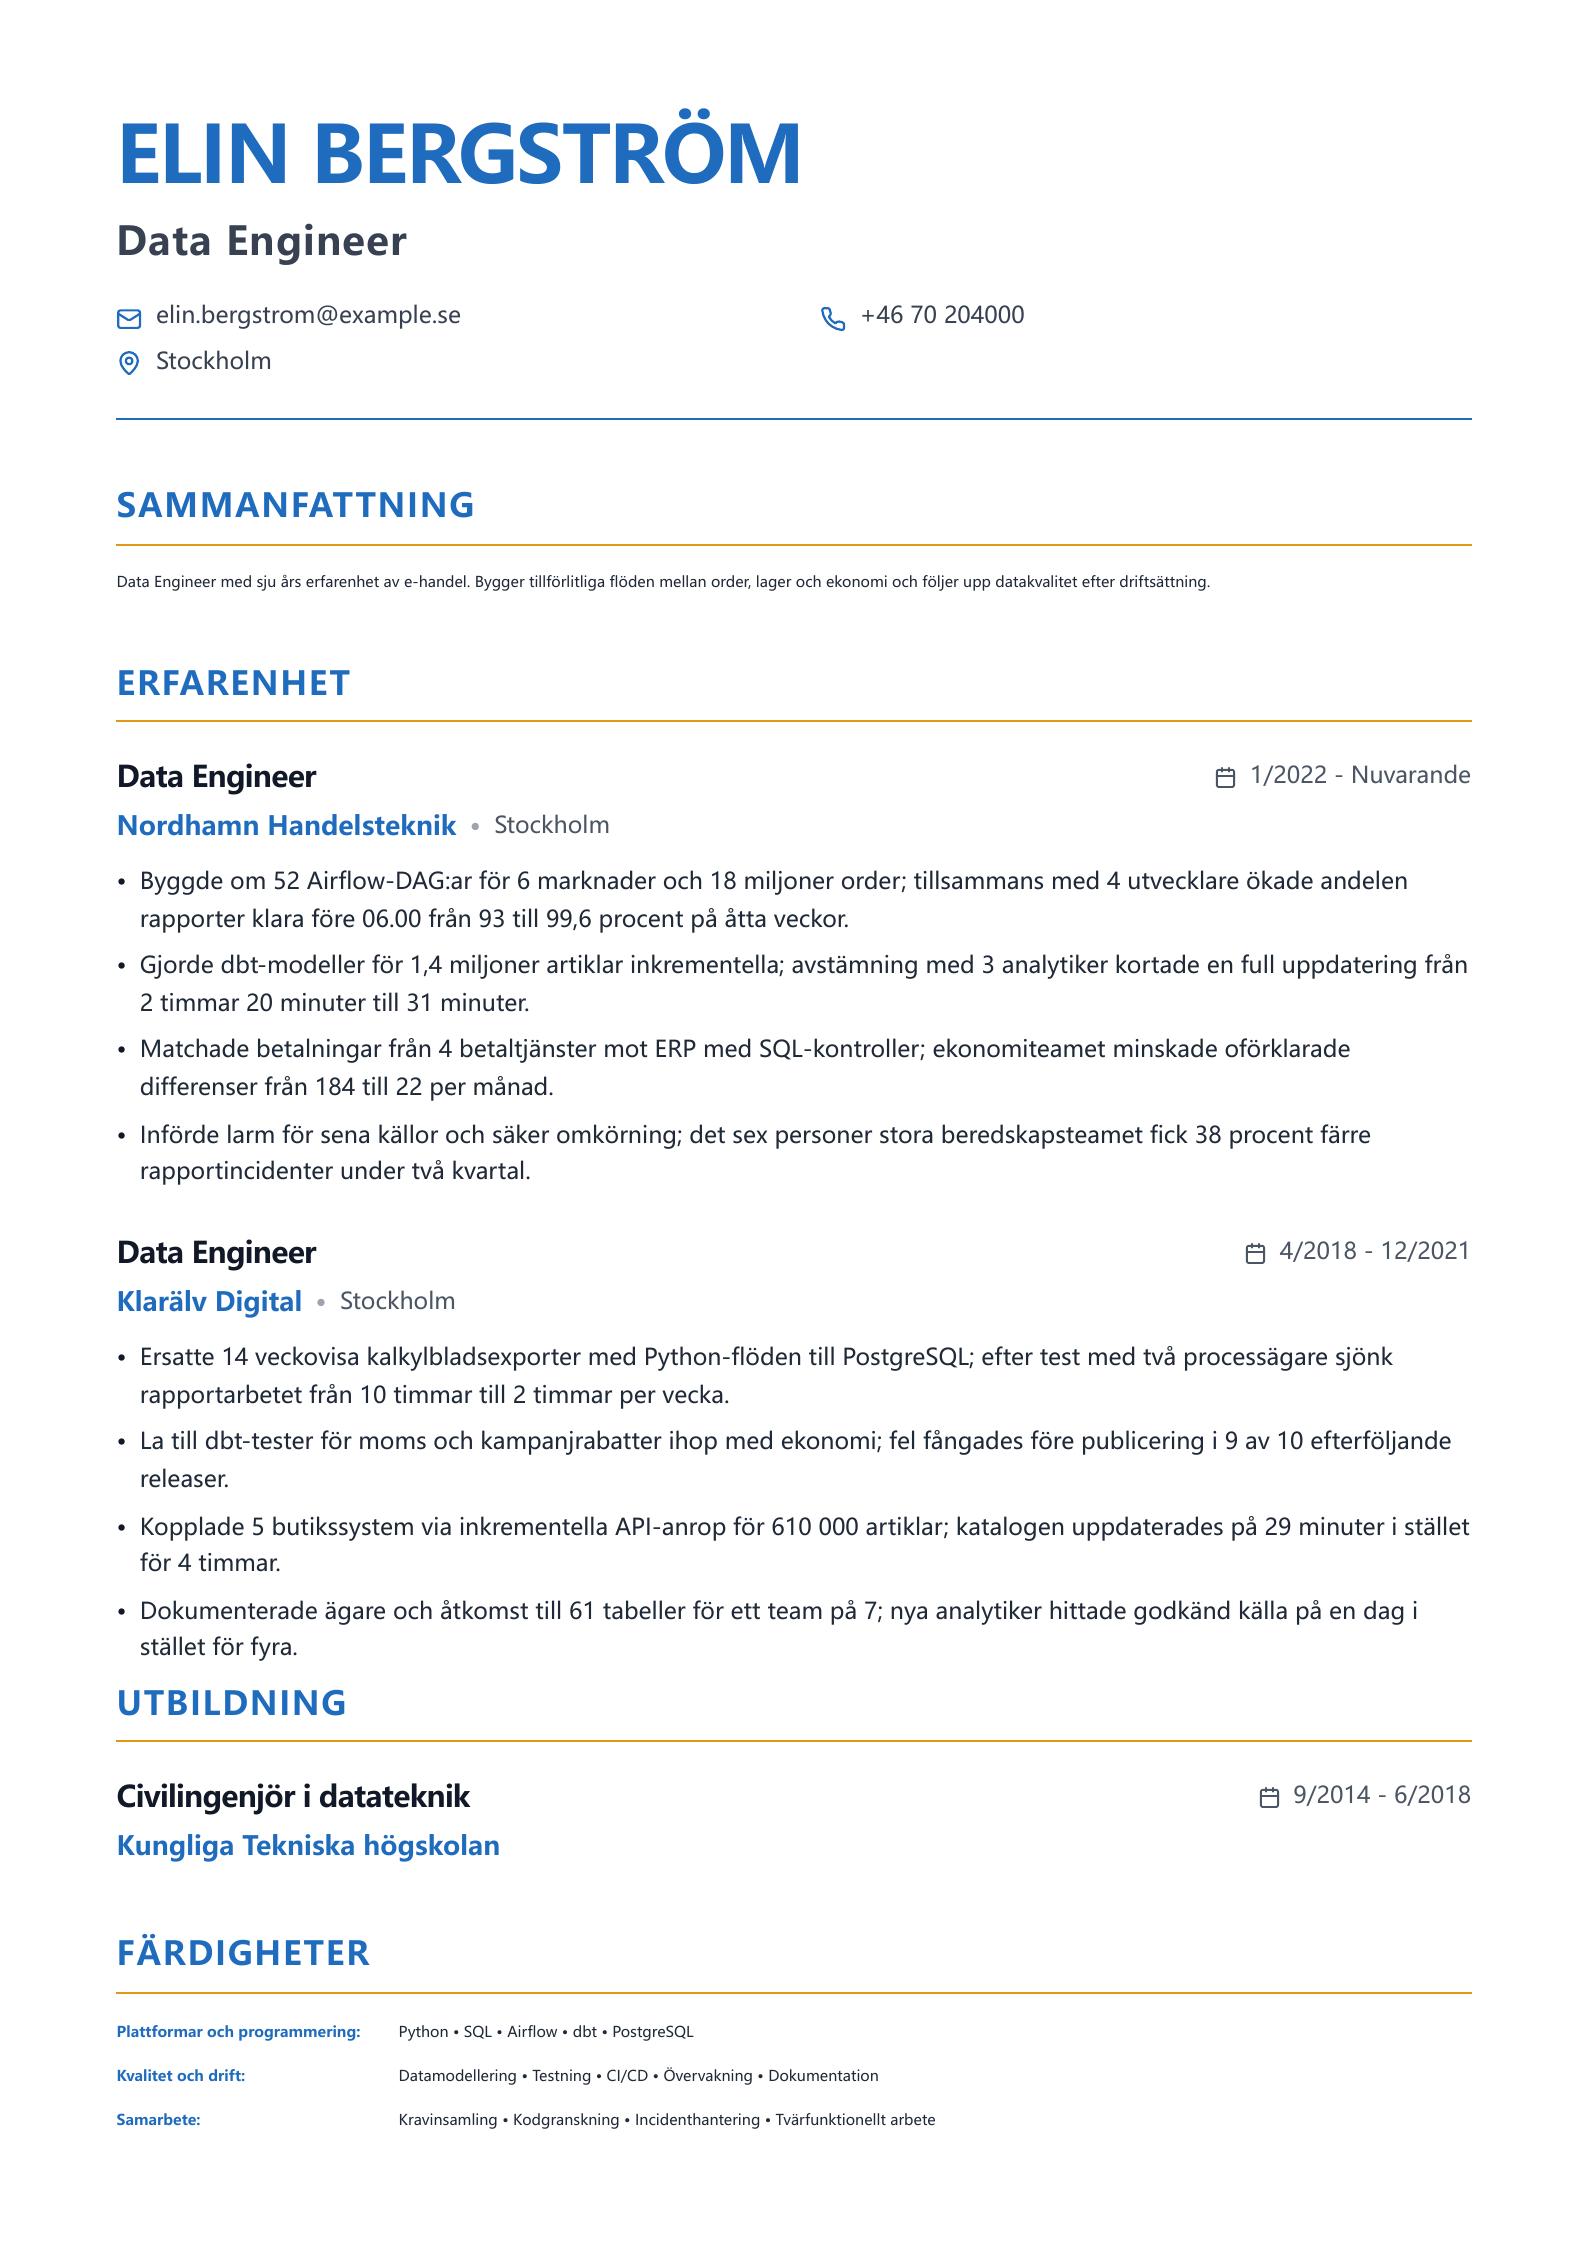
Ett brett exempel på datapipelines, modellering och rapportering för handel.
Jämför CV:n för molnplattformar, ETL, streaming, datalager och datorseende. Varje exempel visar teknikval, projektets omfattning, samarbete och resultat.
Bläddra bland exempel efter plattform, erfarenhetsnivå eller inriktning och välj ett som passar din bakgrund.
Passar dig som: pipelines, datamodellering och drift
Ett brett exempel på datapipelines, modellering och rapportering för handel.
Passar dig som: Azure, IoT och logistik
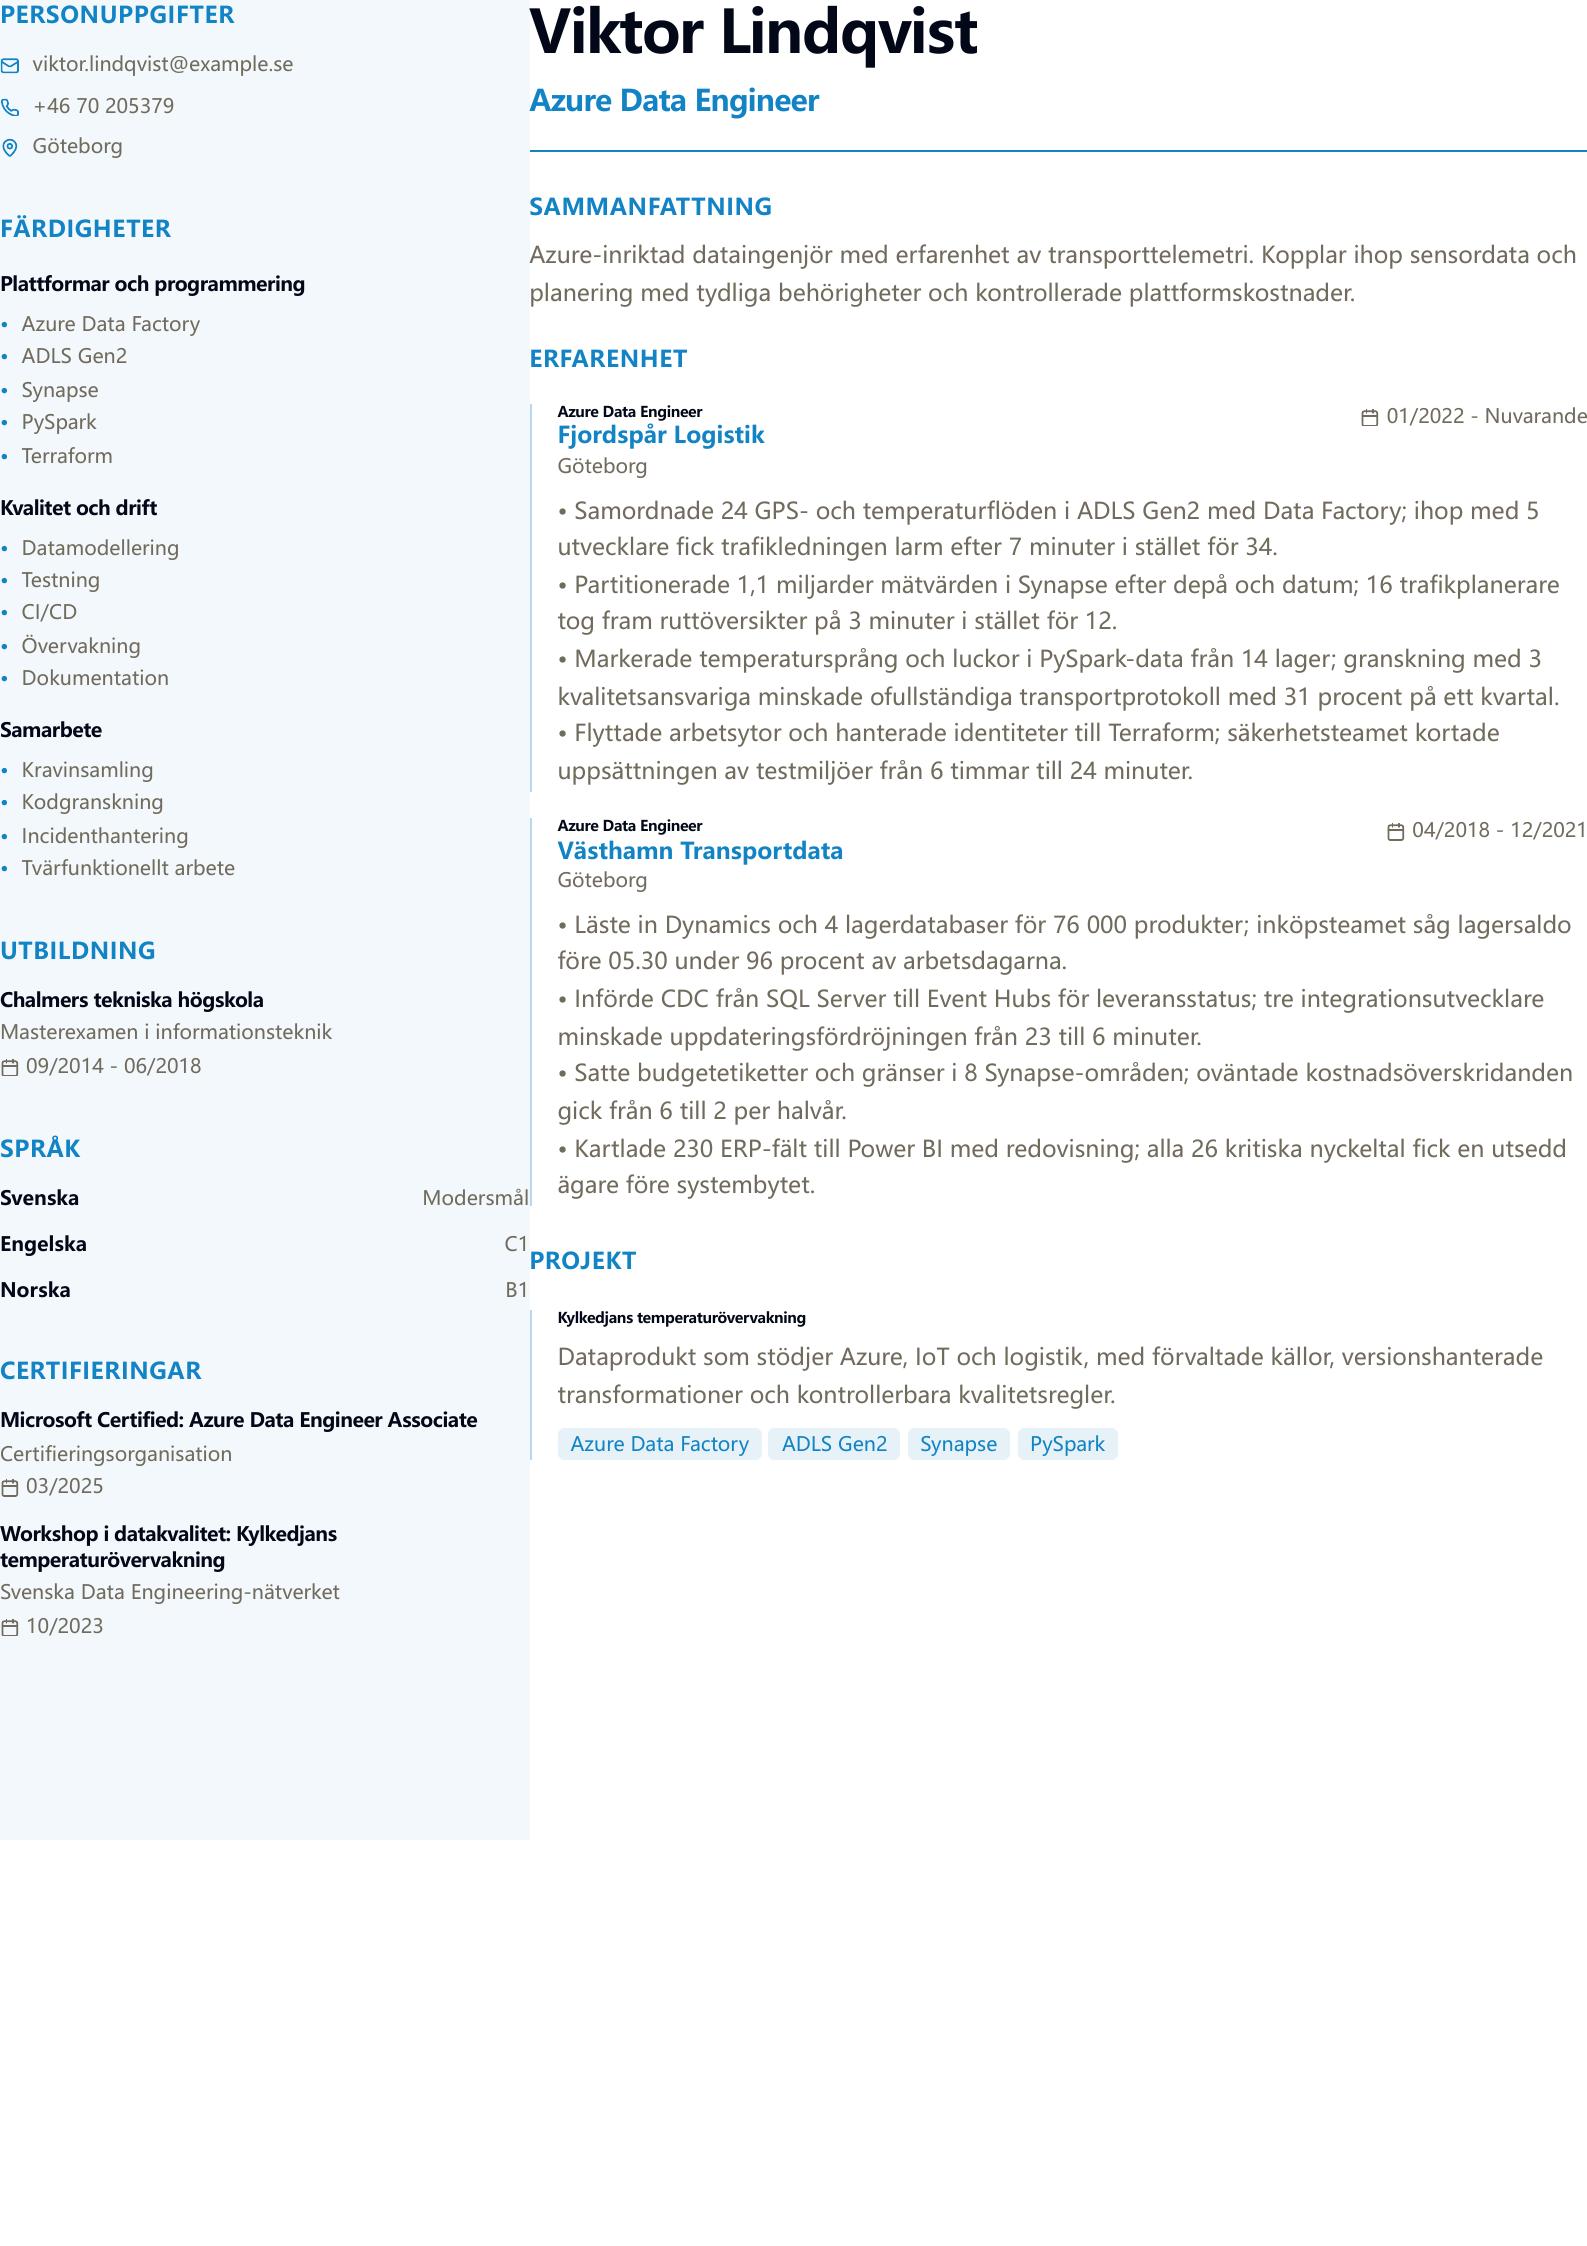
Visar arbete med Data Factory, Synapse och temperaturdata från transporter.
Passar dig som: Kinesis, S3, Glue och mediedata
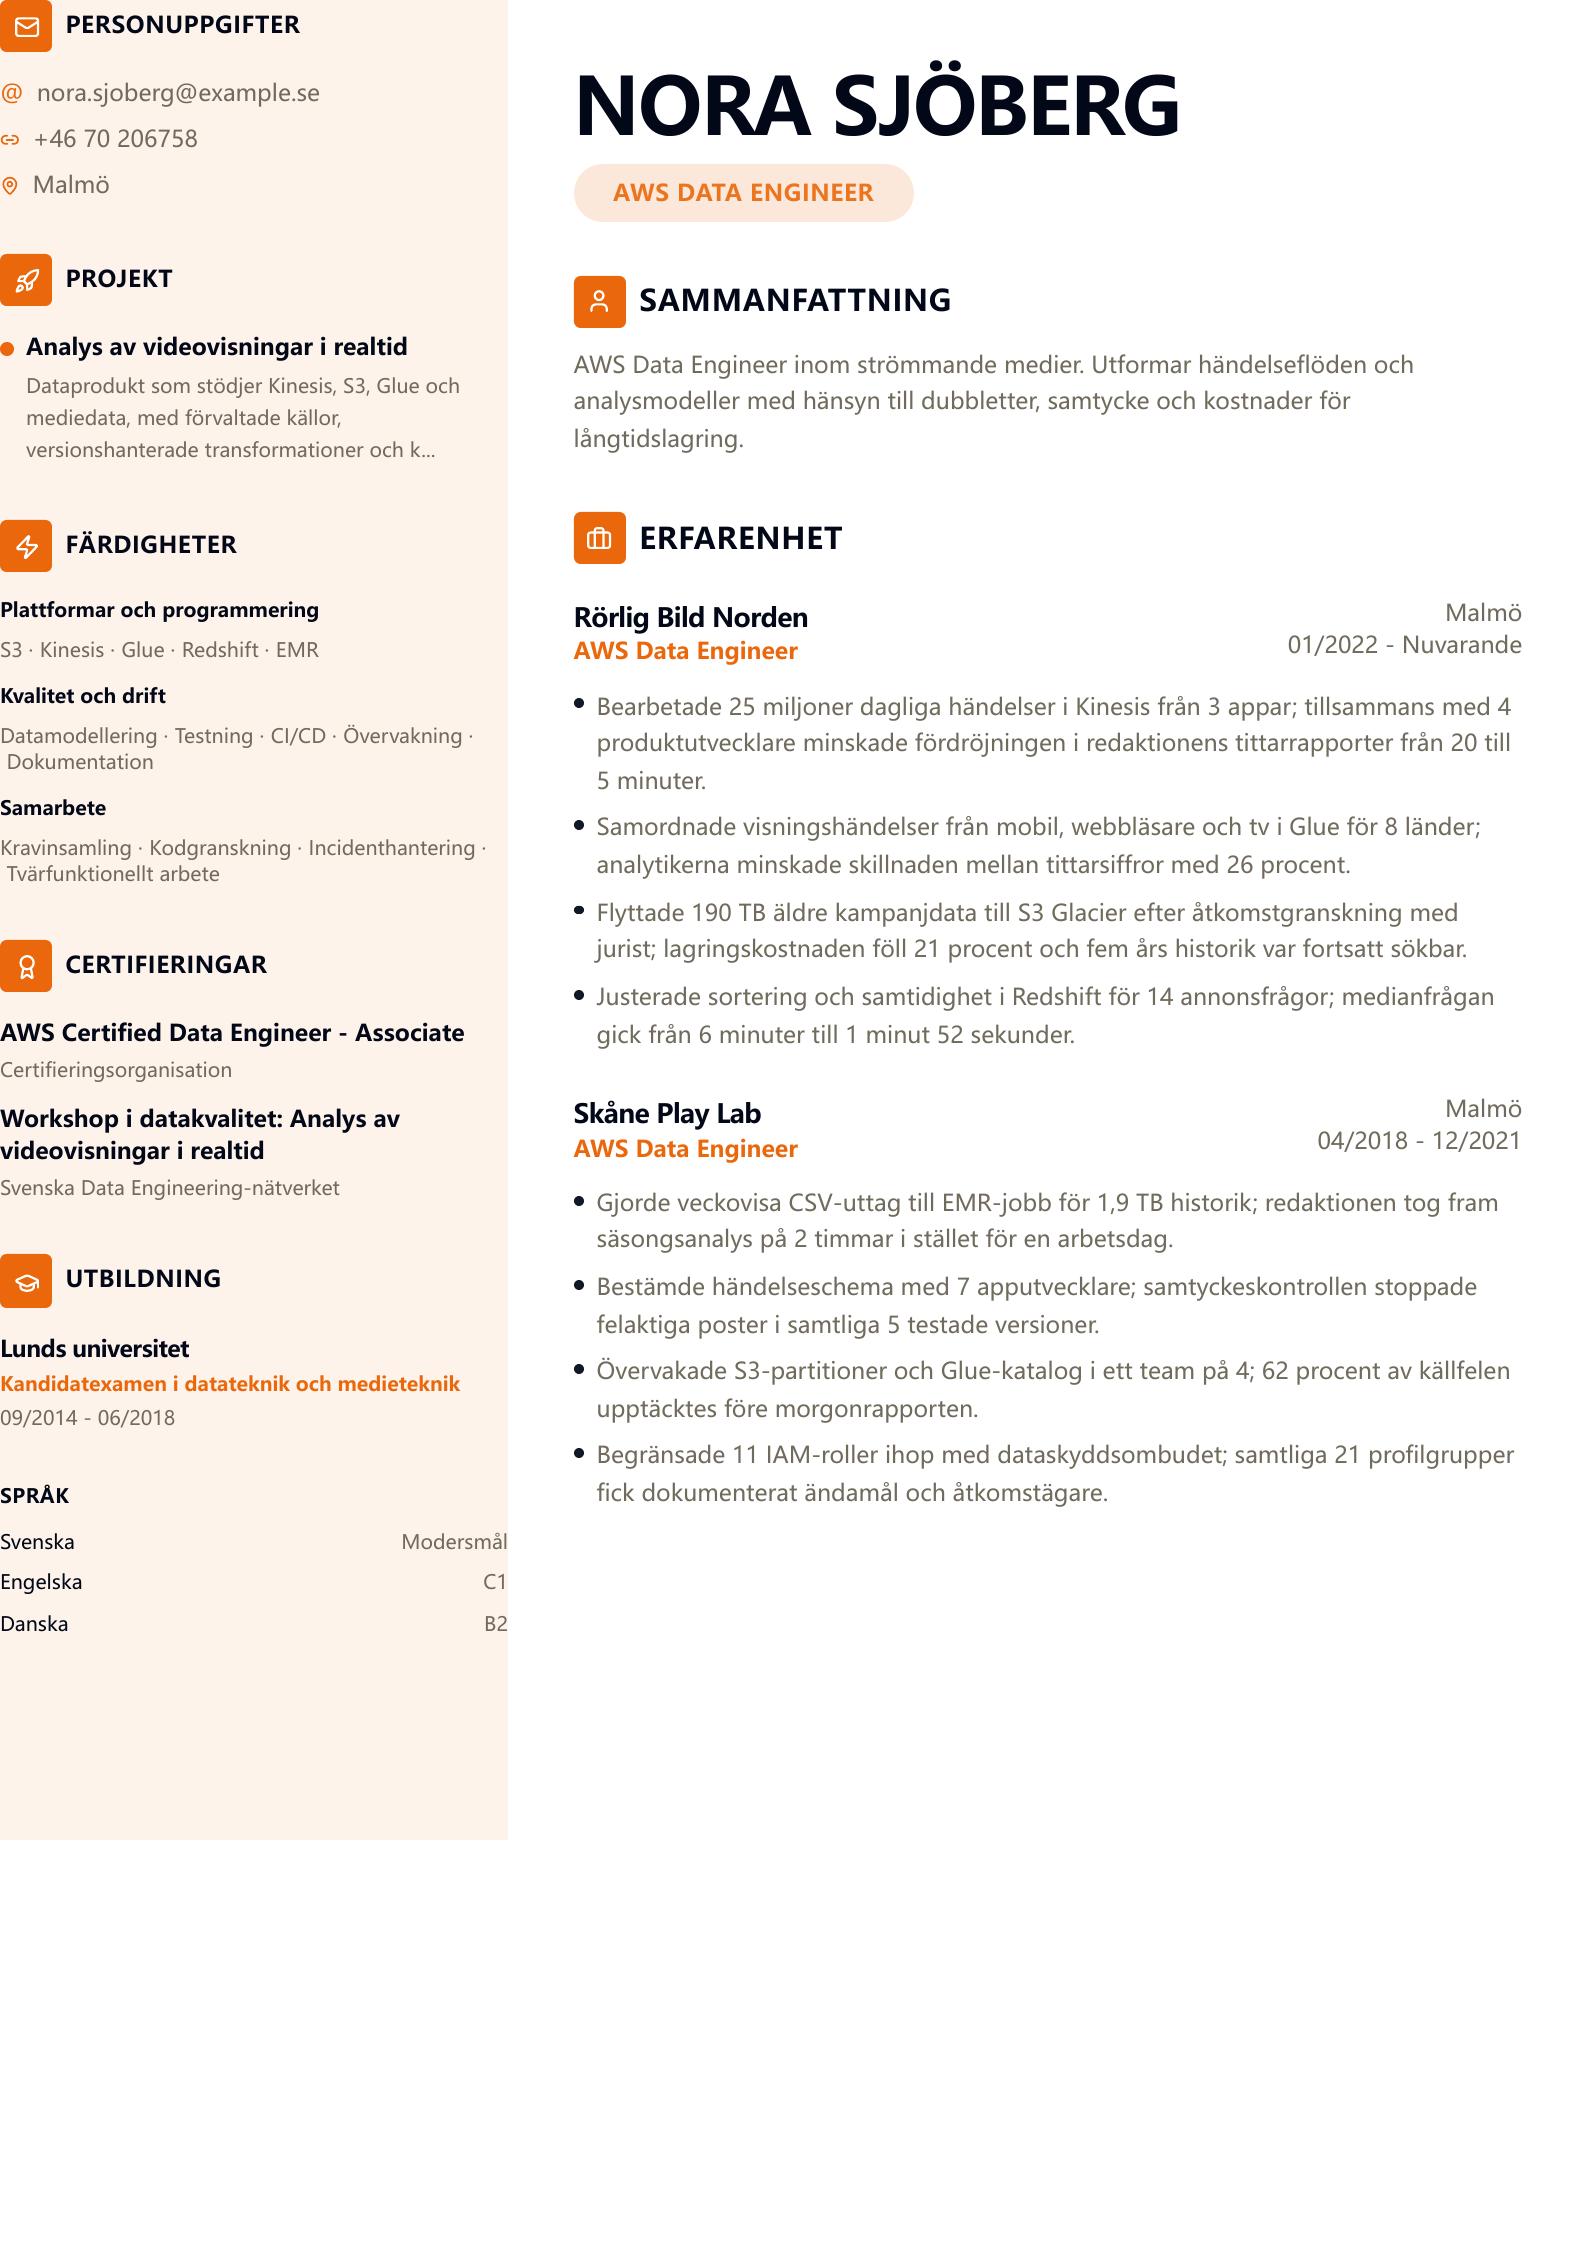
Ett exempel för medietjänster som samlar händelser från webb, tv och appar.
Passar dig som: BigQuery, Pub/Sub och kampanjanalys
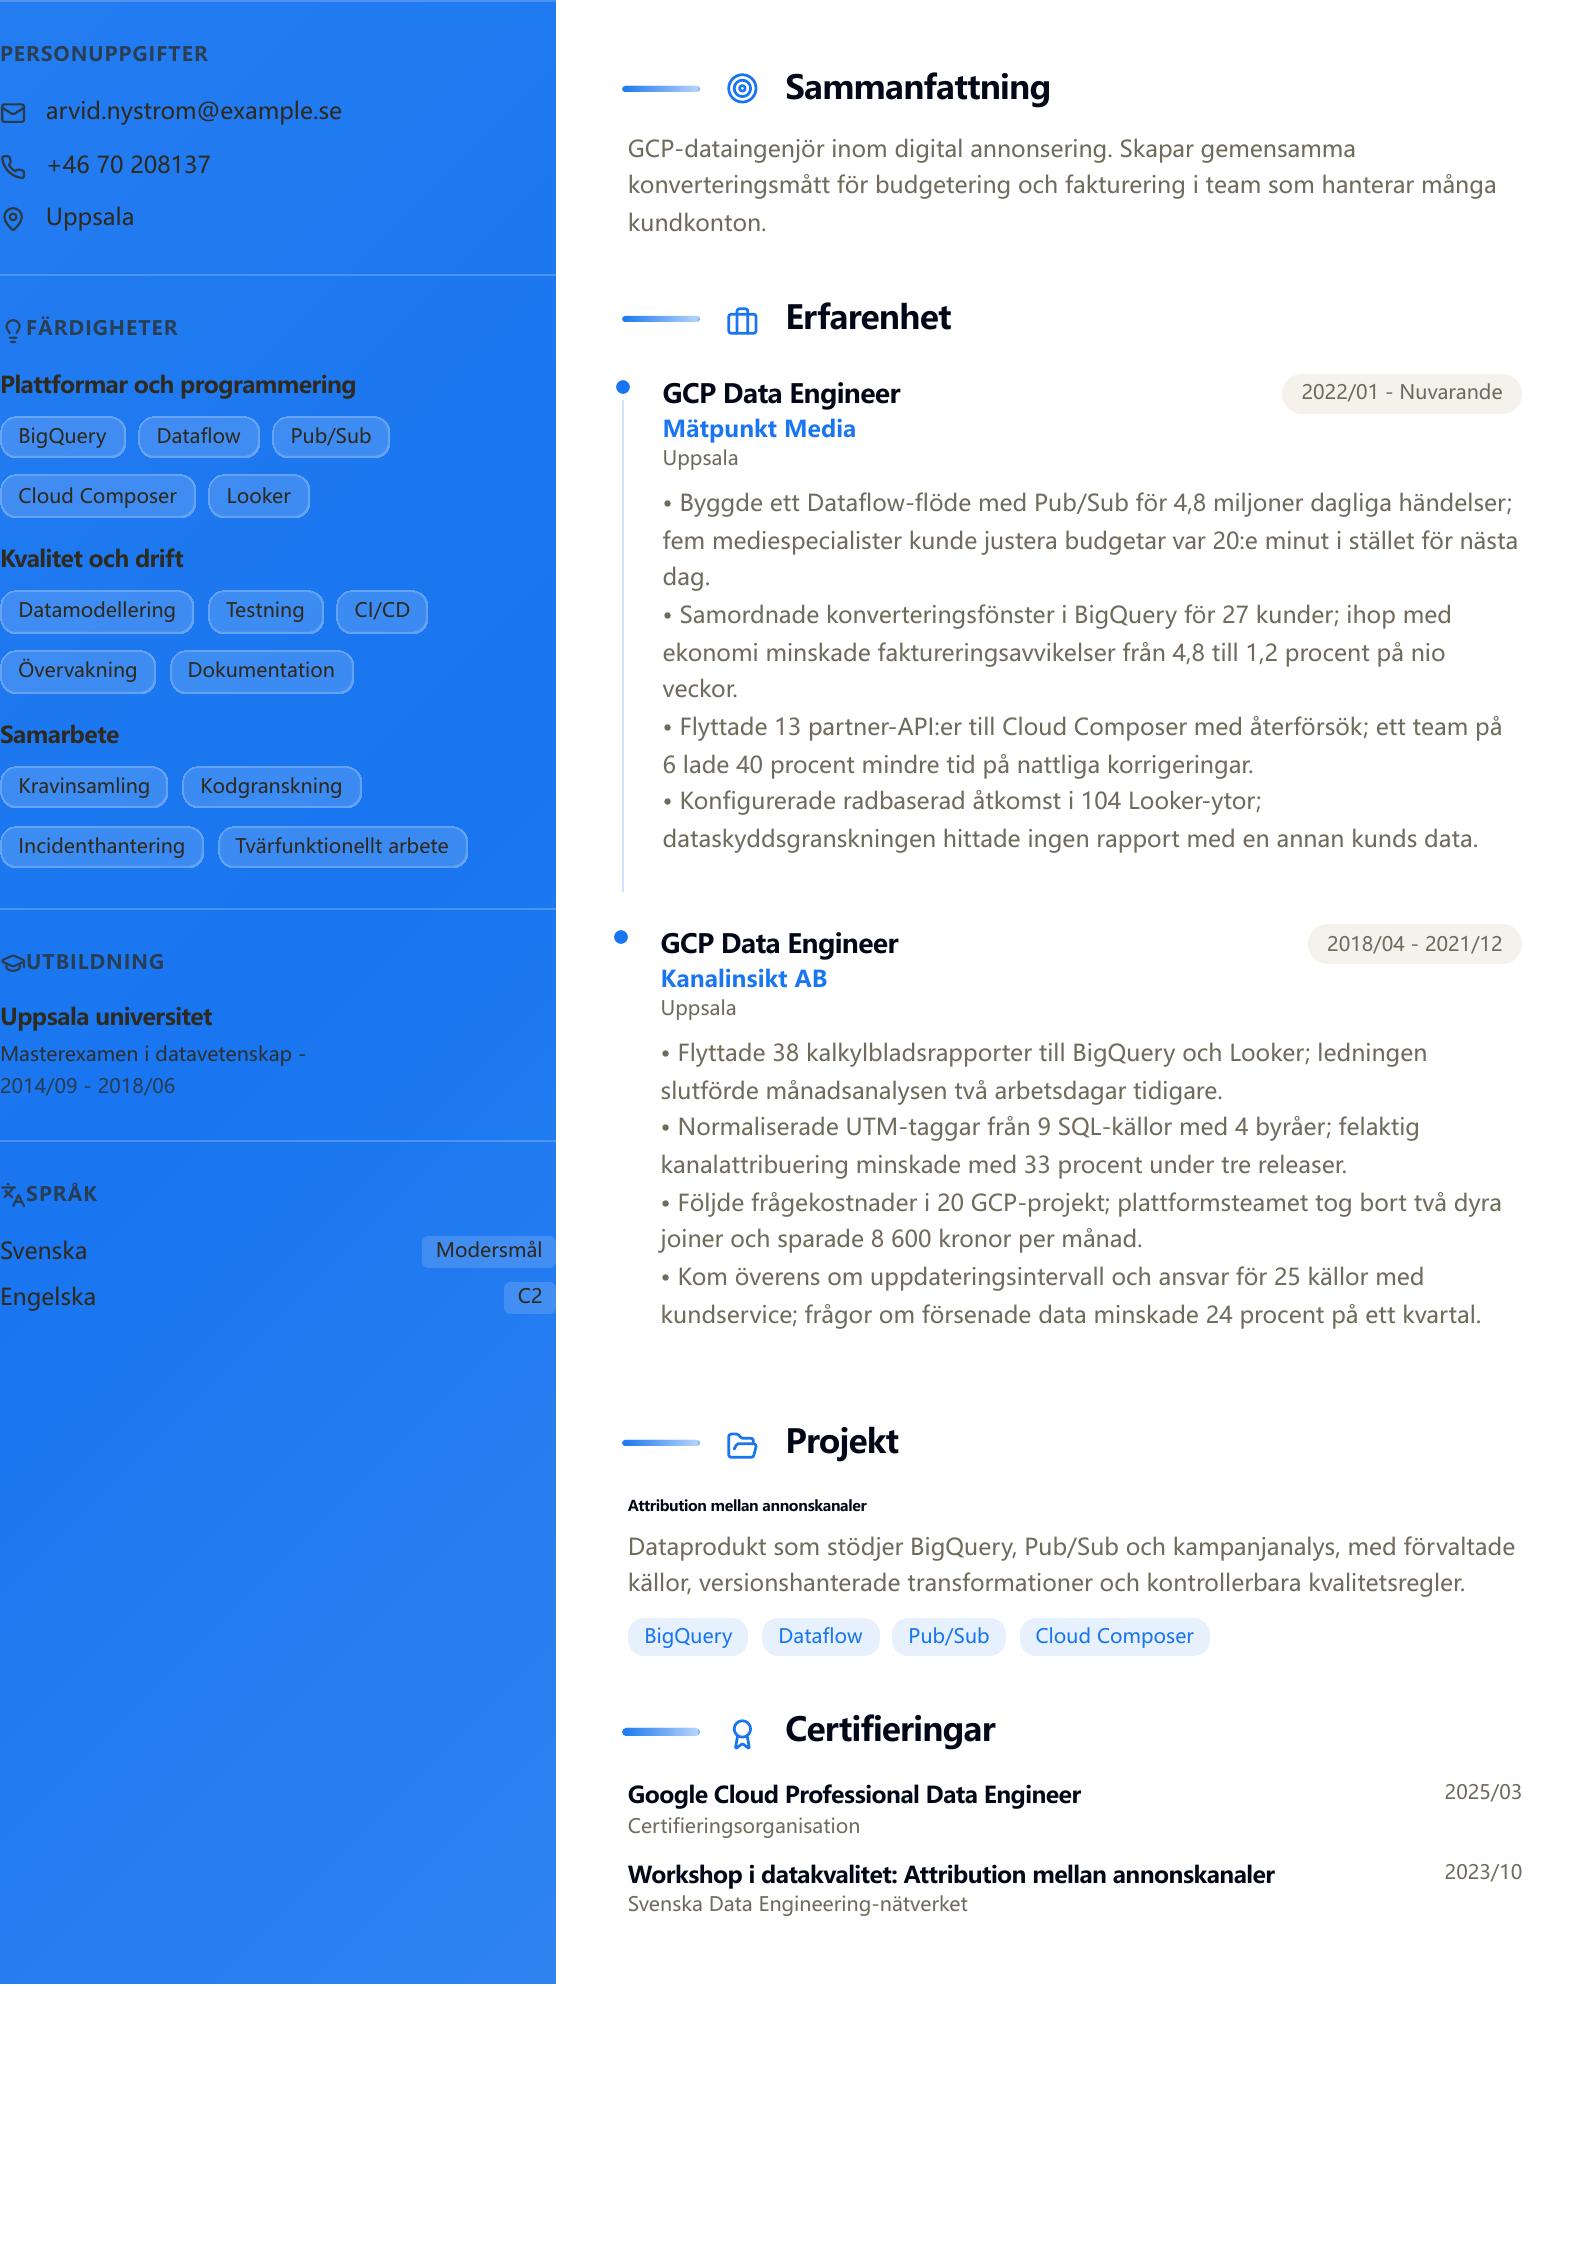
Arbete med BigQuery, Dataflow och konverteringsdata för marknadsföring.
Passar dig som: Snowflake, dbt och finansiella data
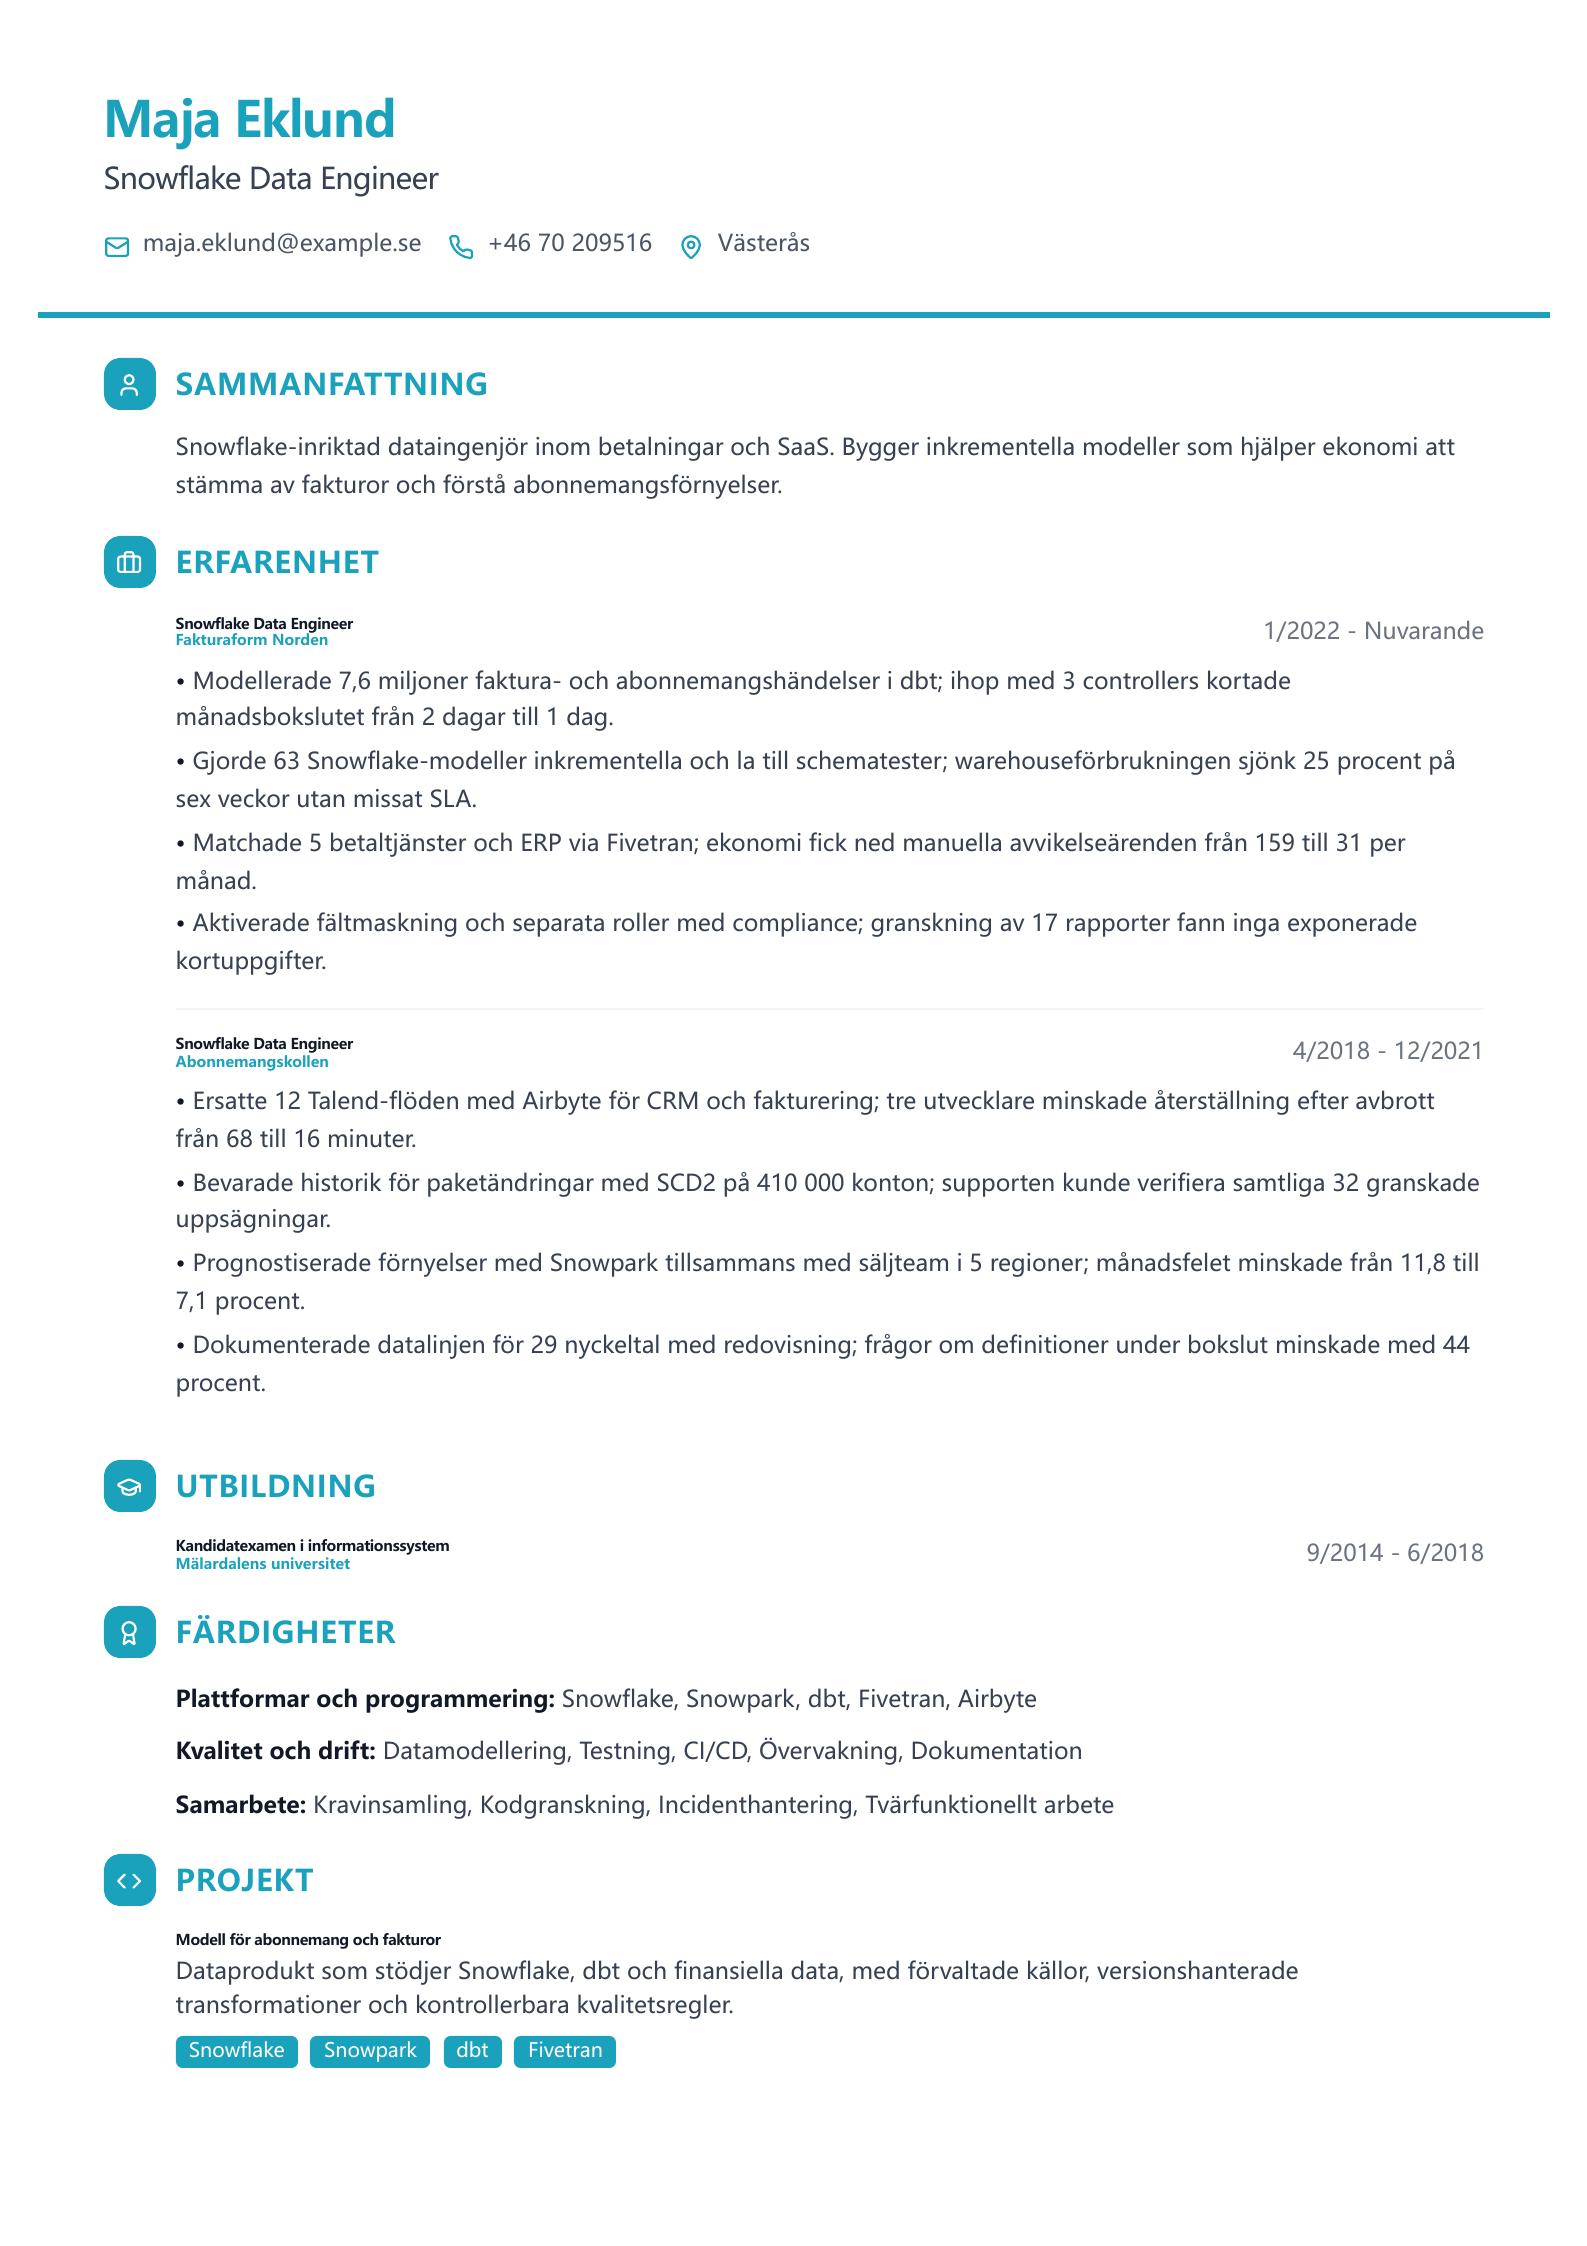
Erfarenhet av Snowflake, dbt och betalningsdata för prenumerationstjänster.
Passar dig som: Kafka, Spark, Flink och stora datamängder
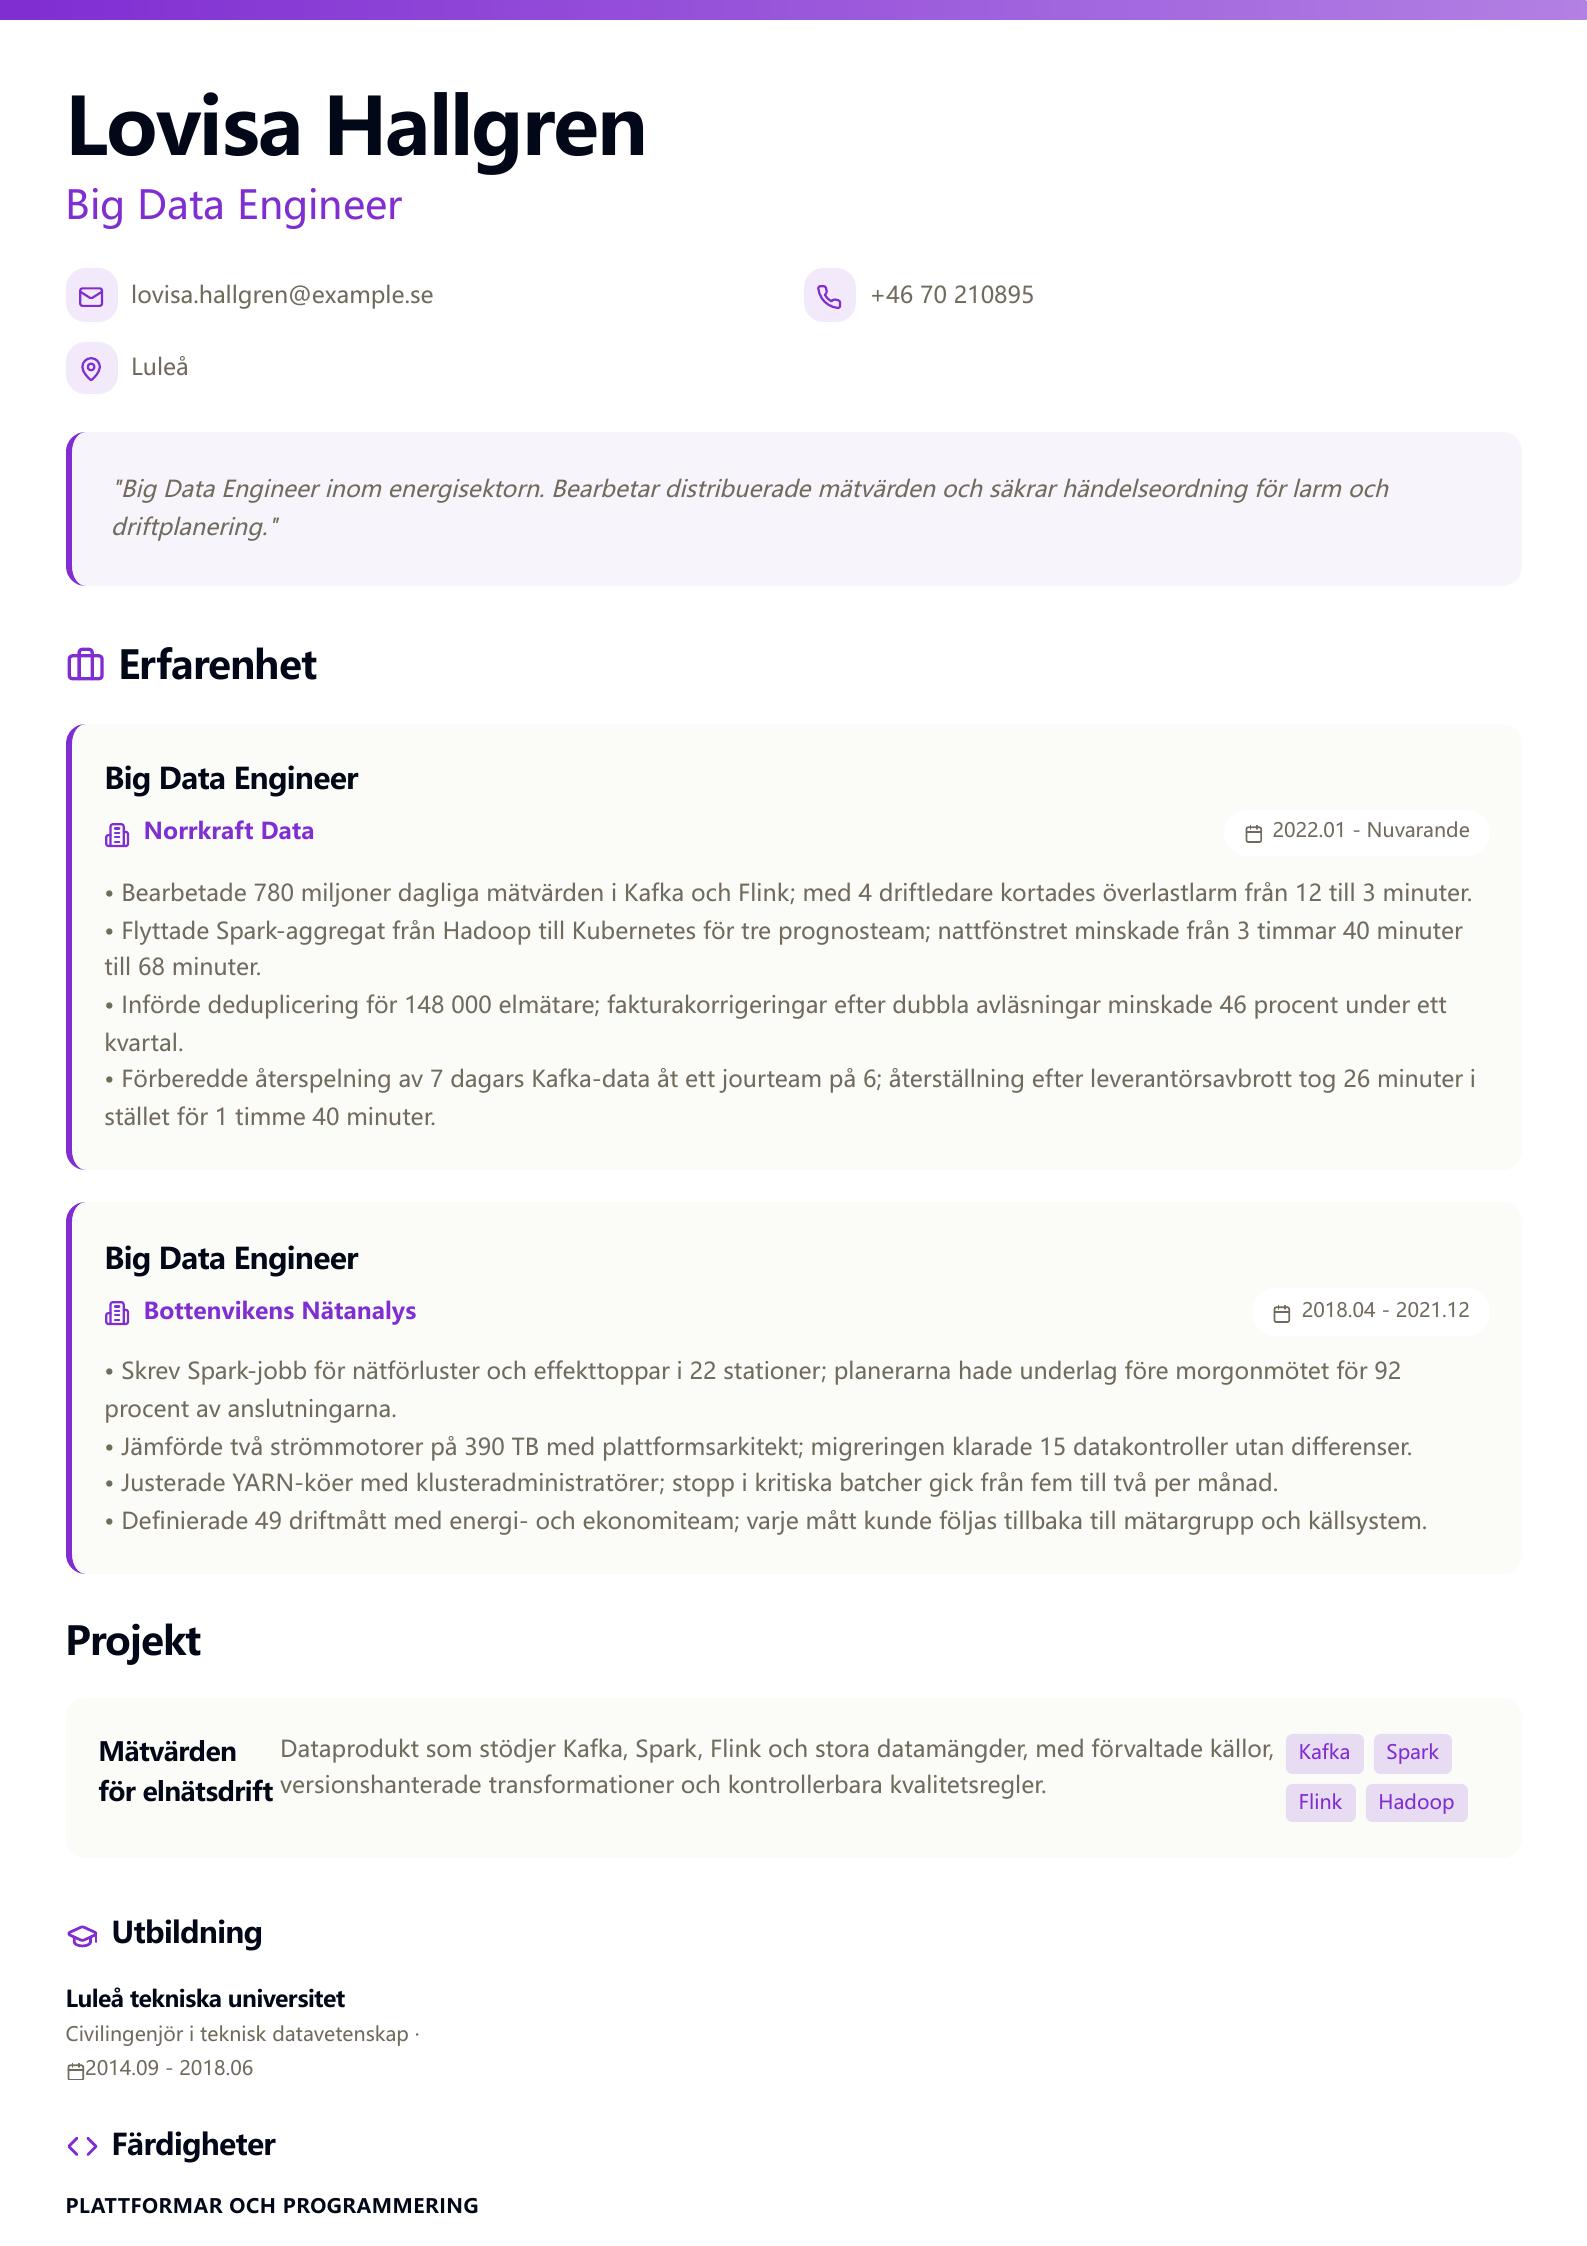
Exempel på distribuerad behandling av stora volymer från elnät och mätare.
Passar dig som: datacenter, telemetri och infrastruktur
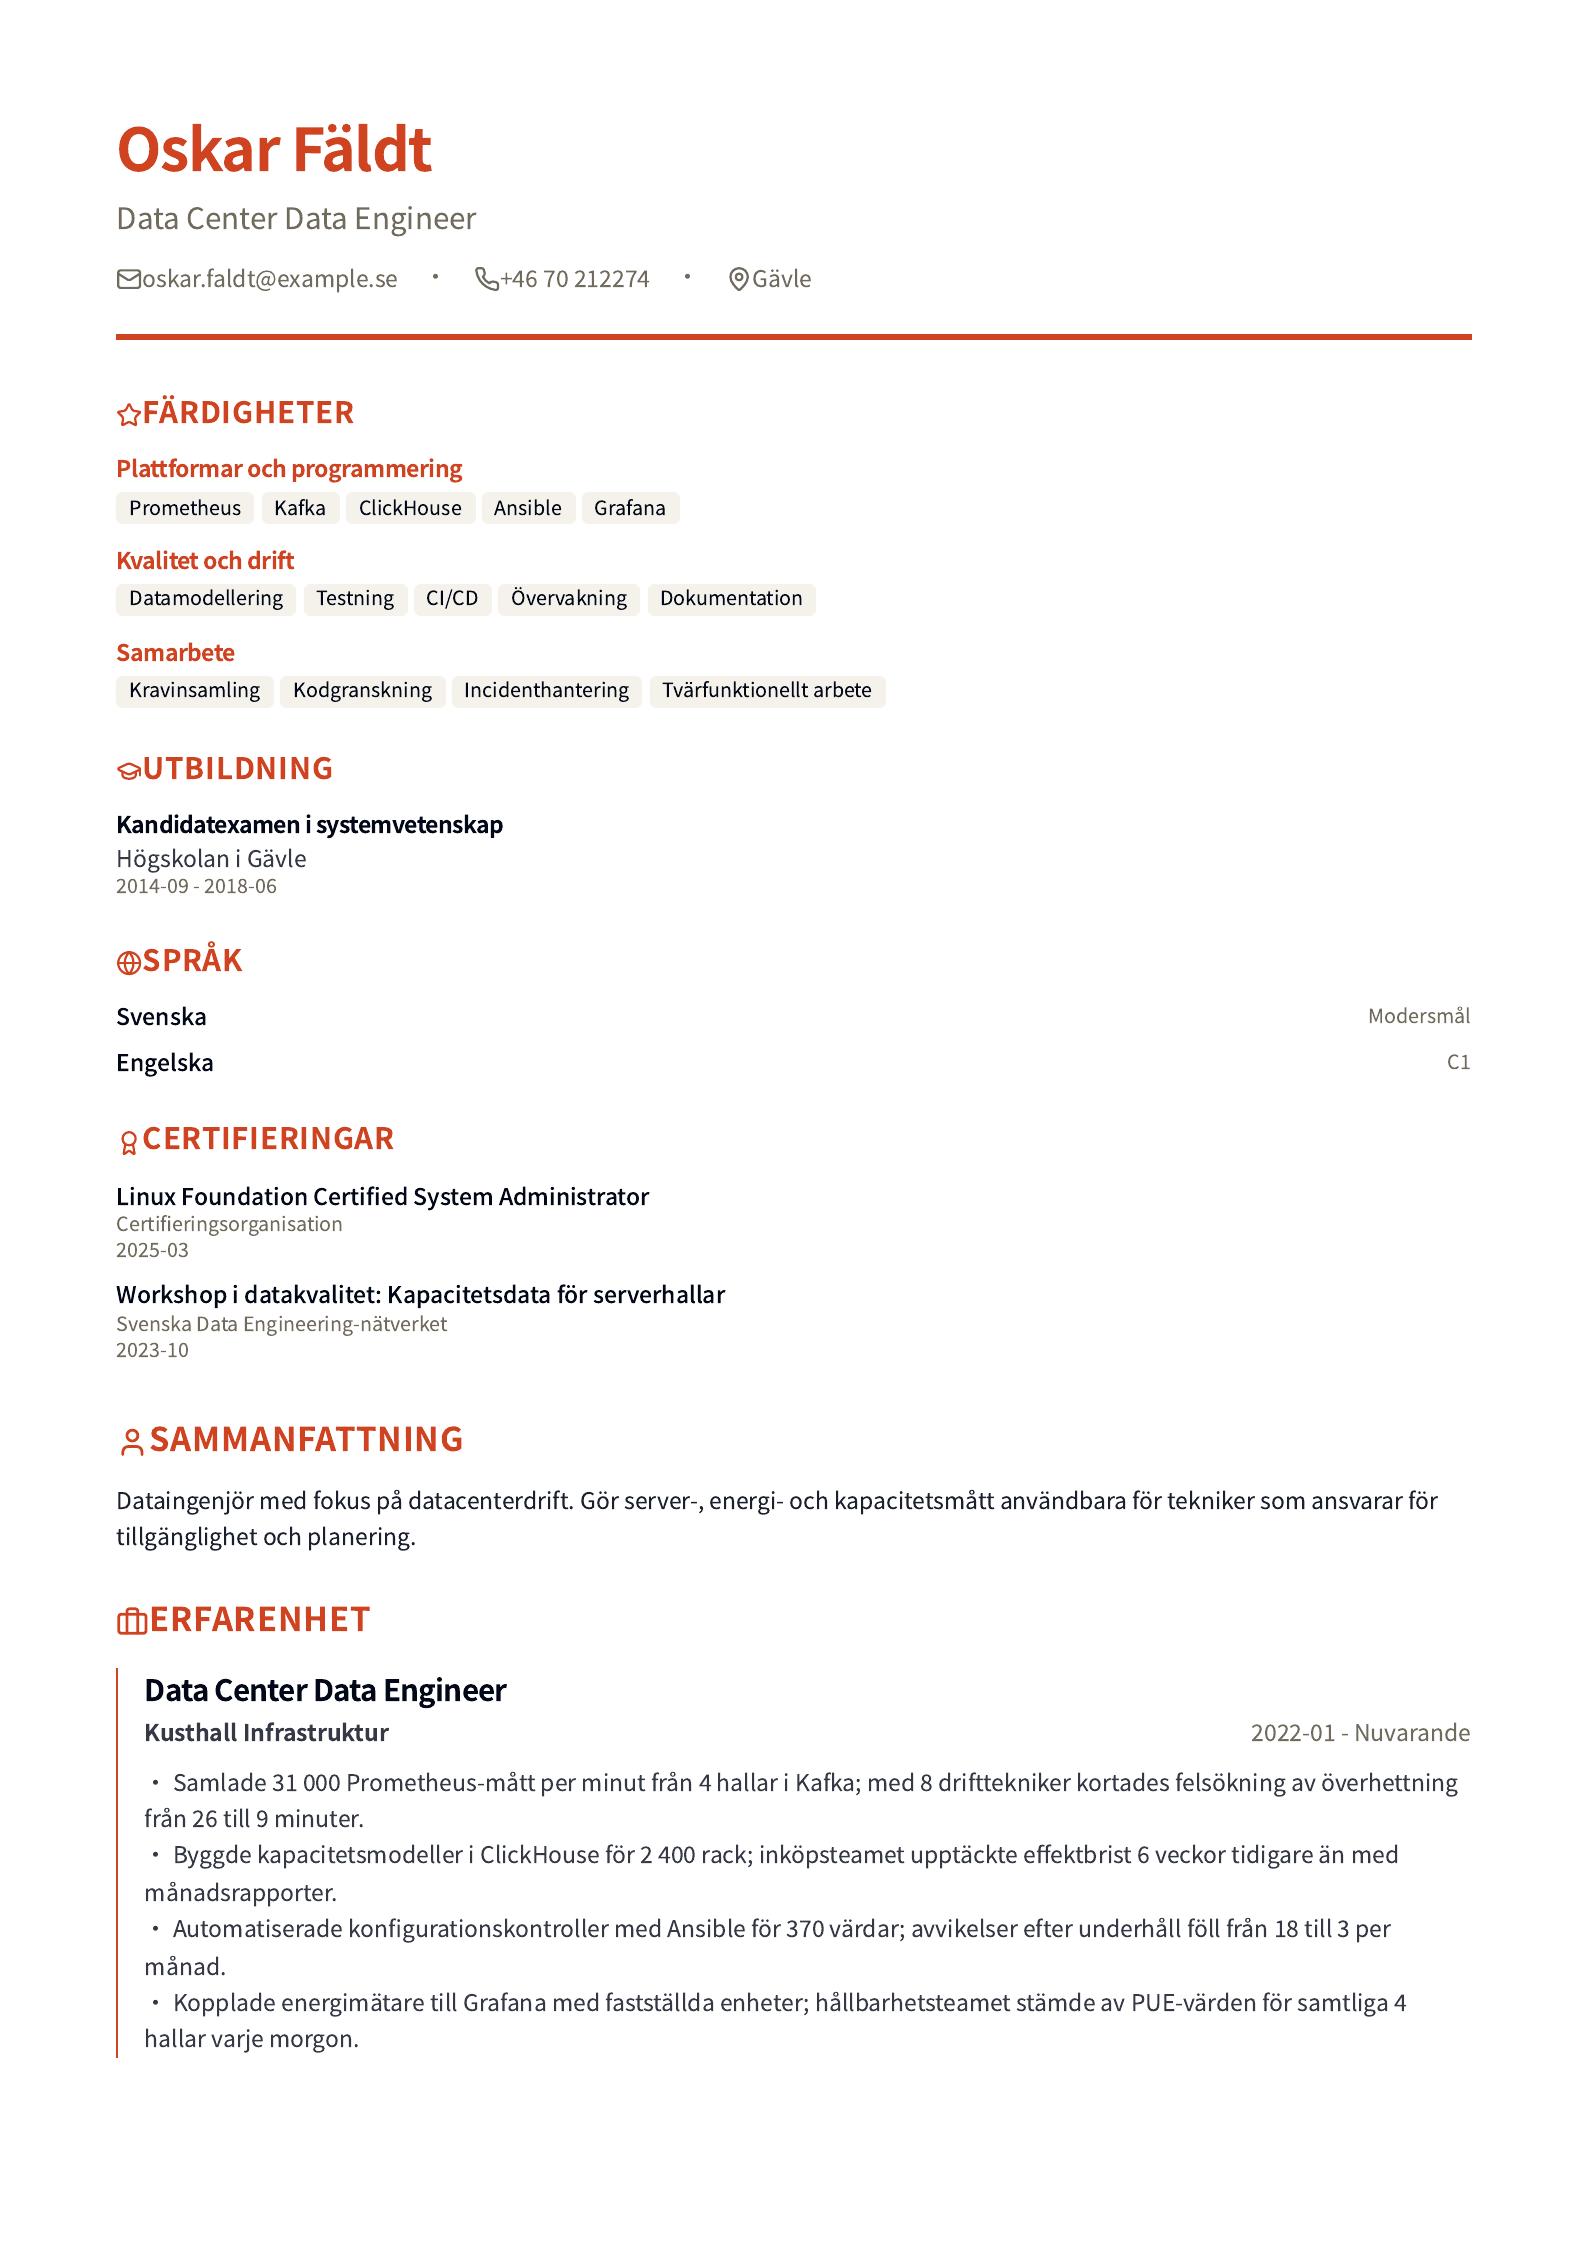
Kopplar samman datainsamling, kapacitetsplanering och driftsäkerhet.
Passar dig som: Databricks, lakehouse och industri
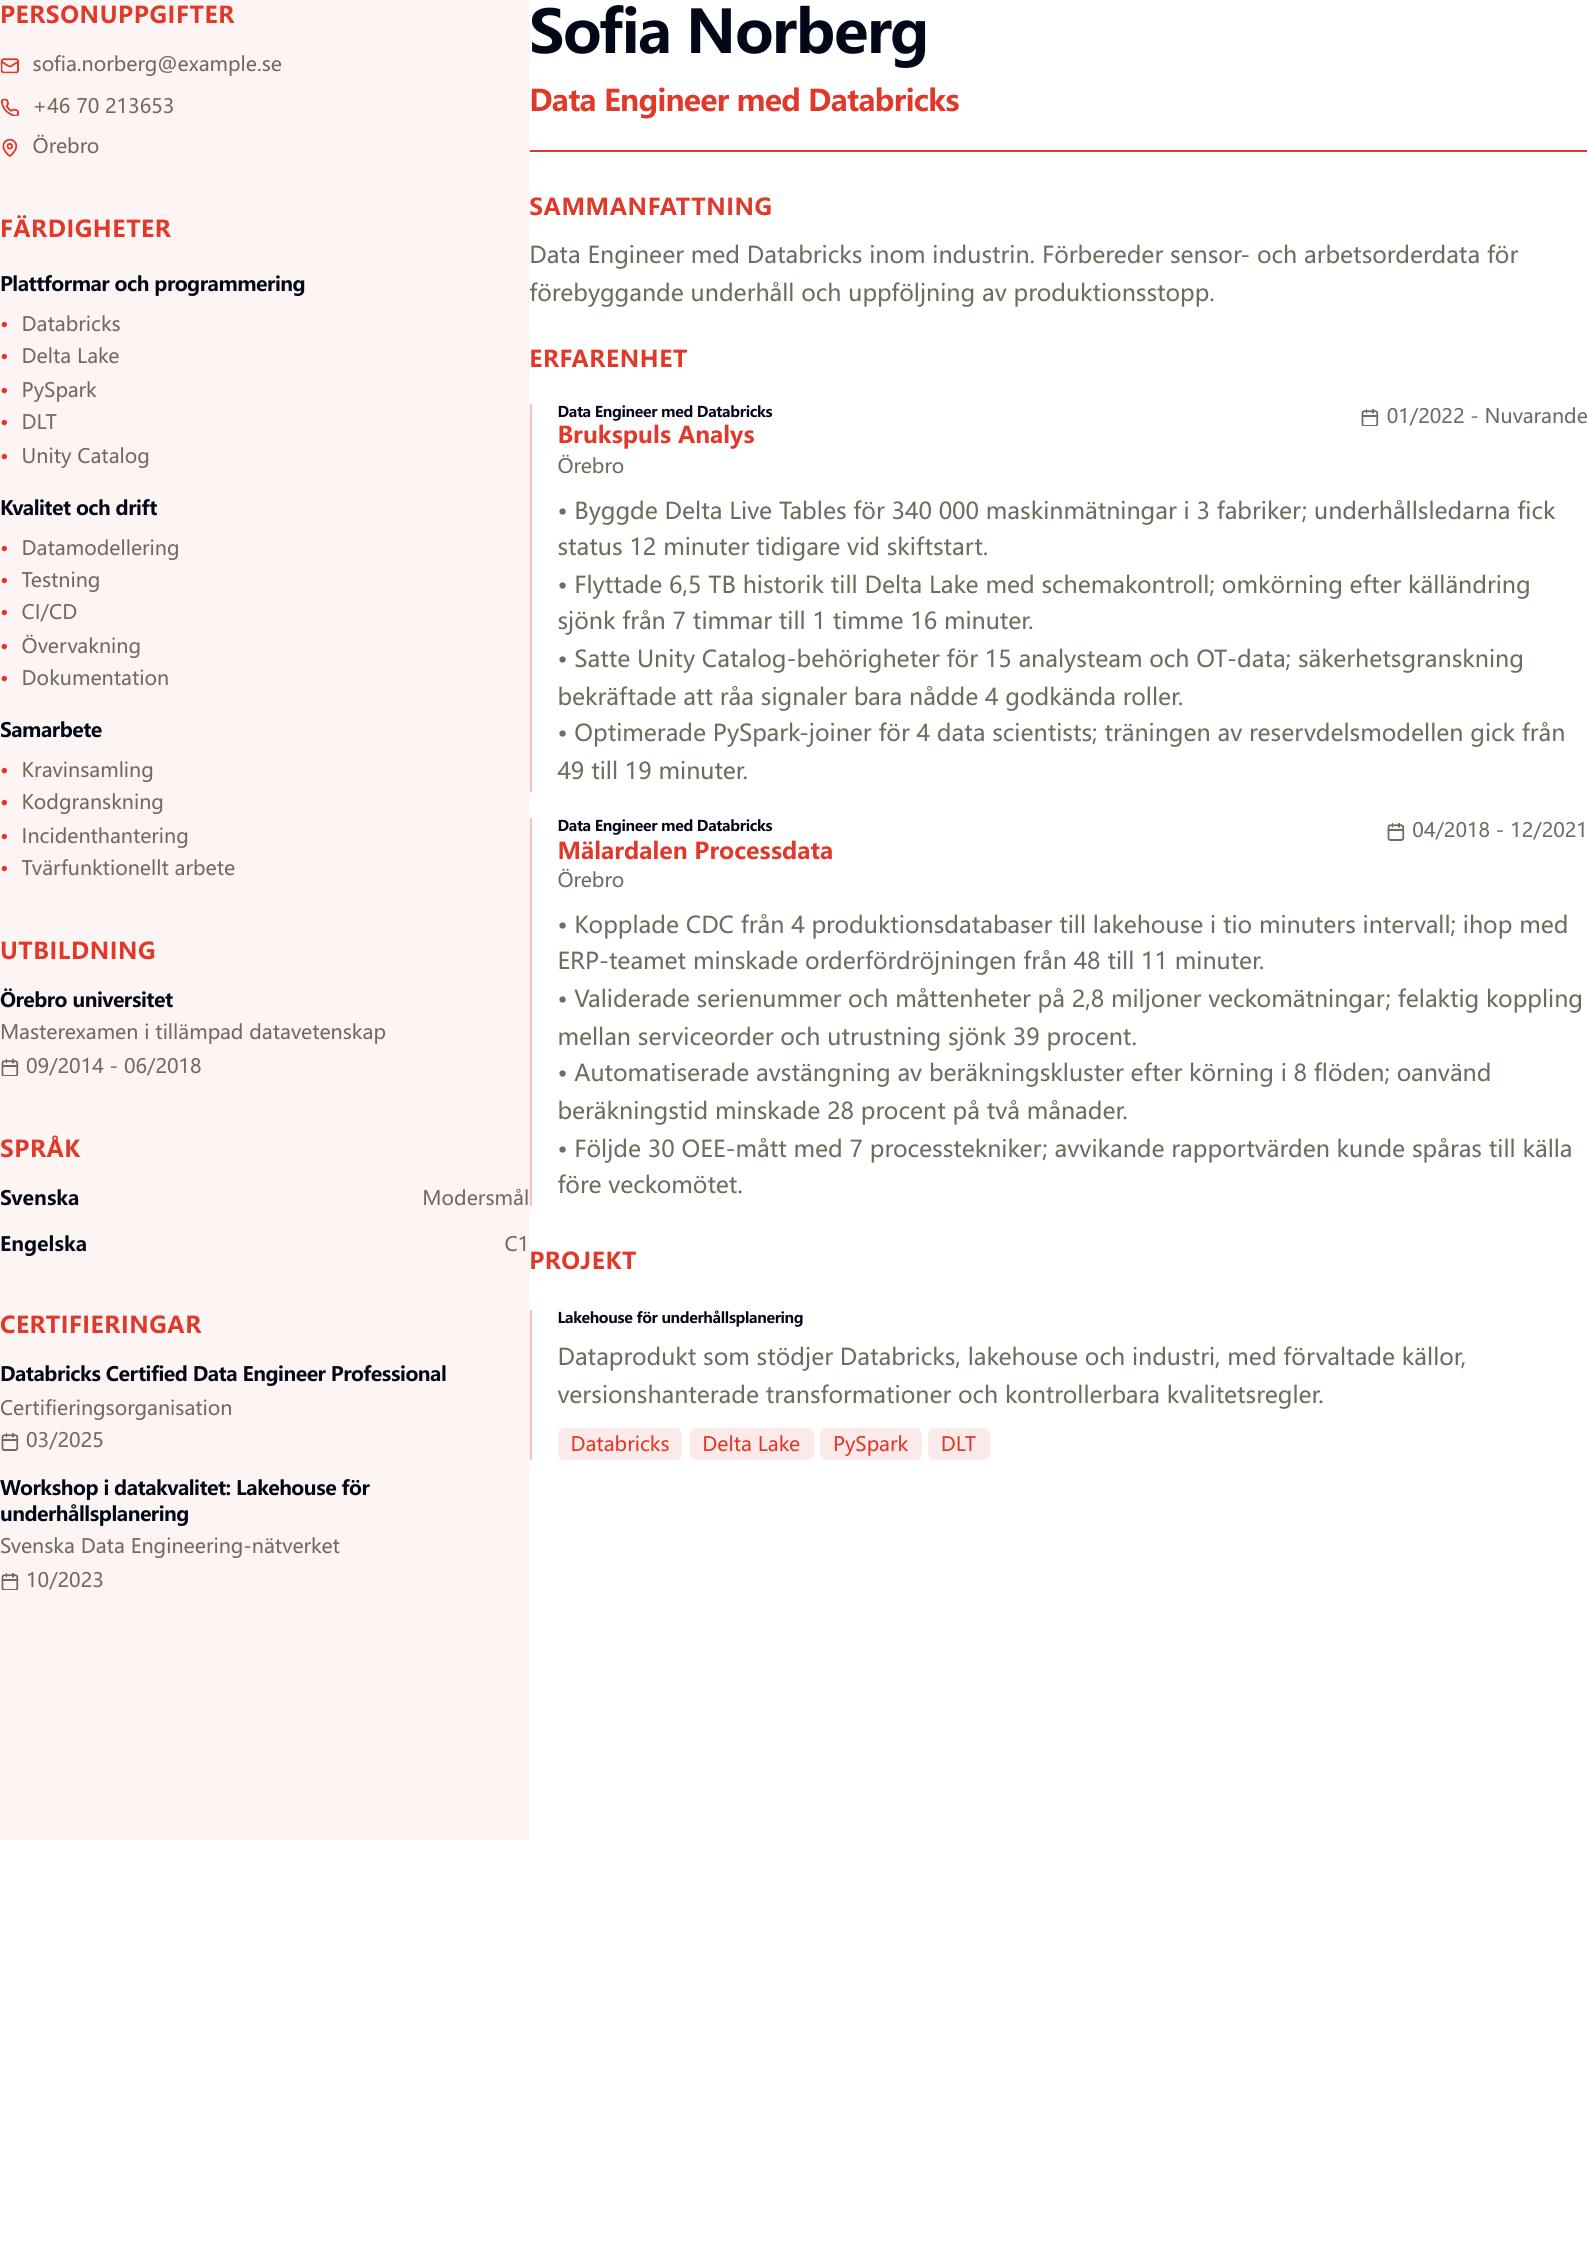
Ett Databricks-exempel med Delta Lake, PySpark och produktionsdata.
Passar dig som: praktik, utbildningsprojekt och juniorroller
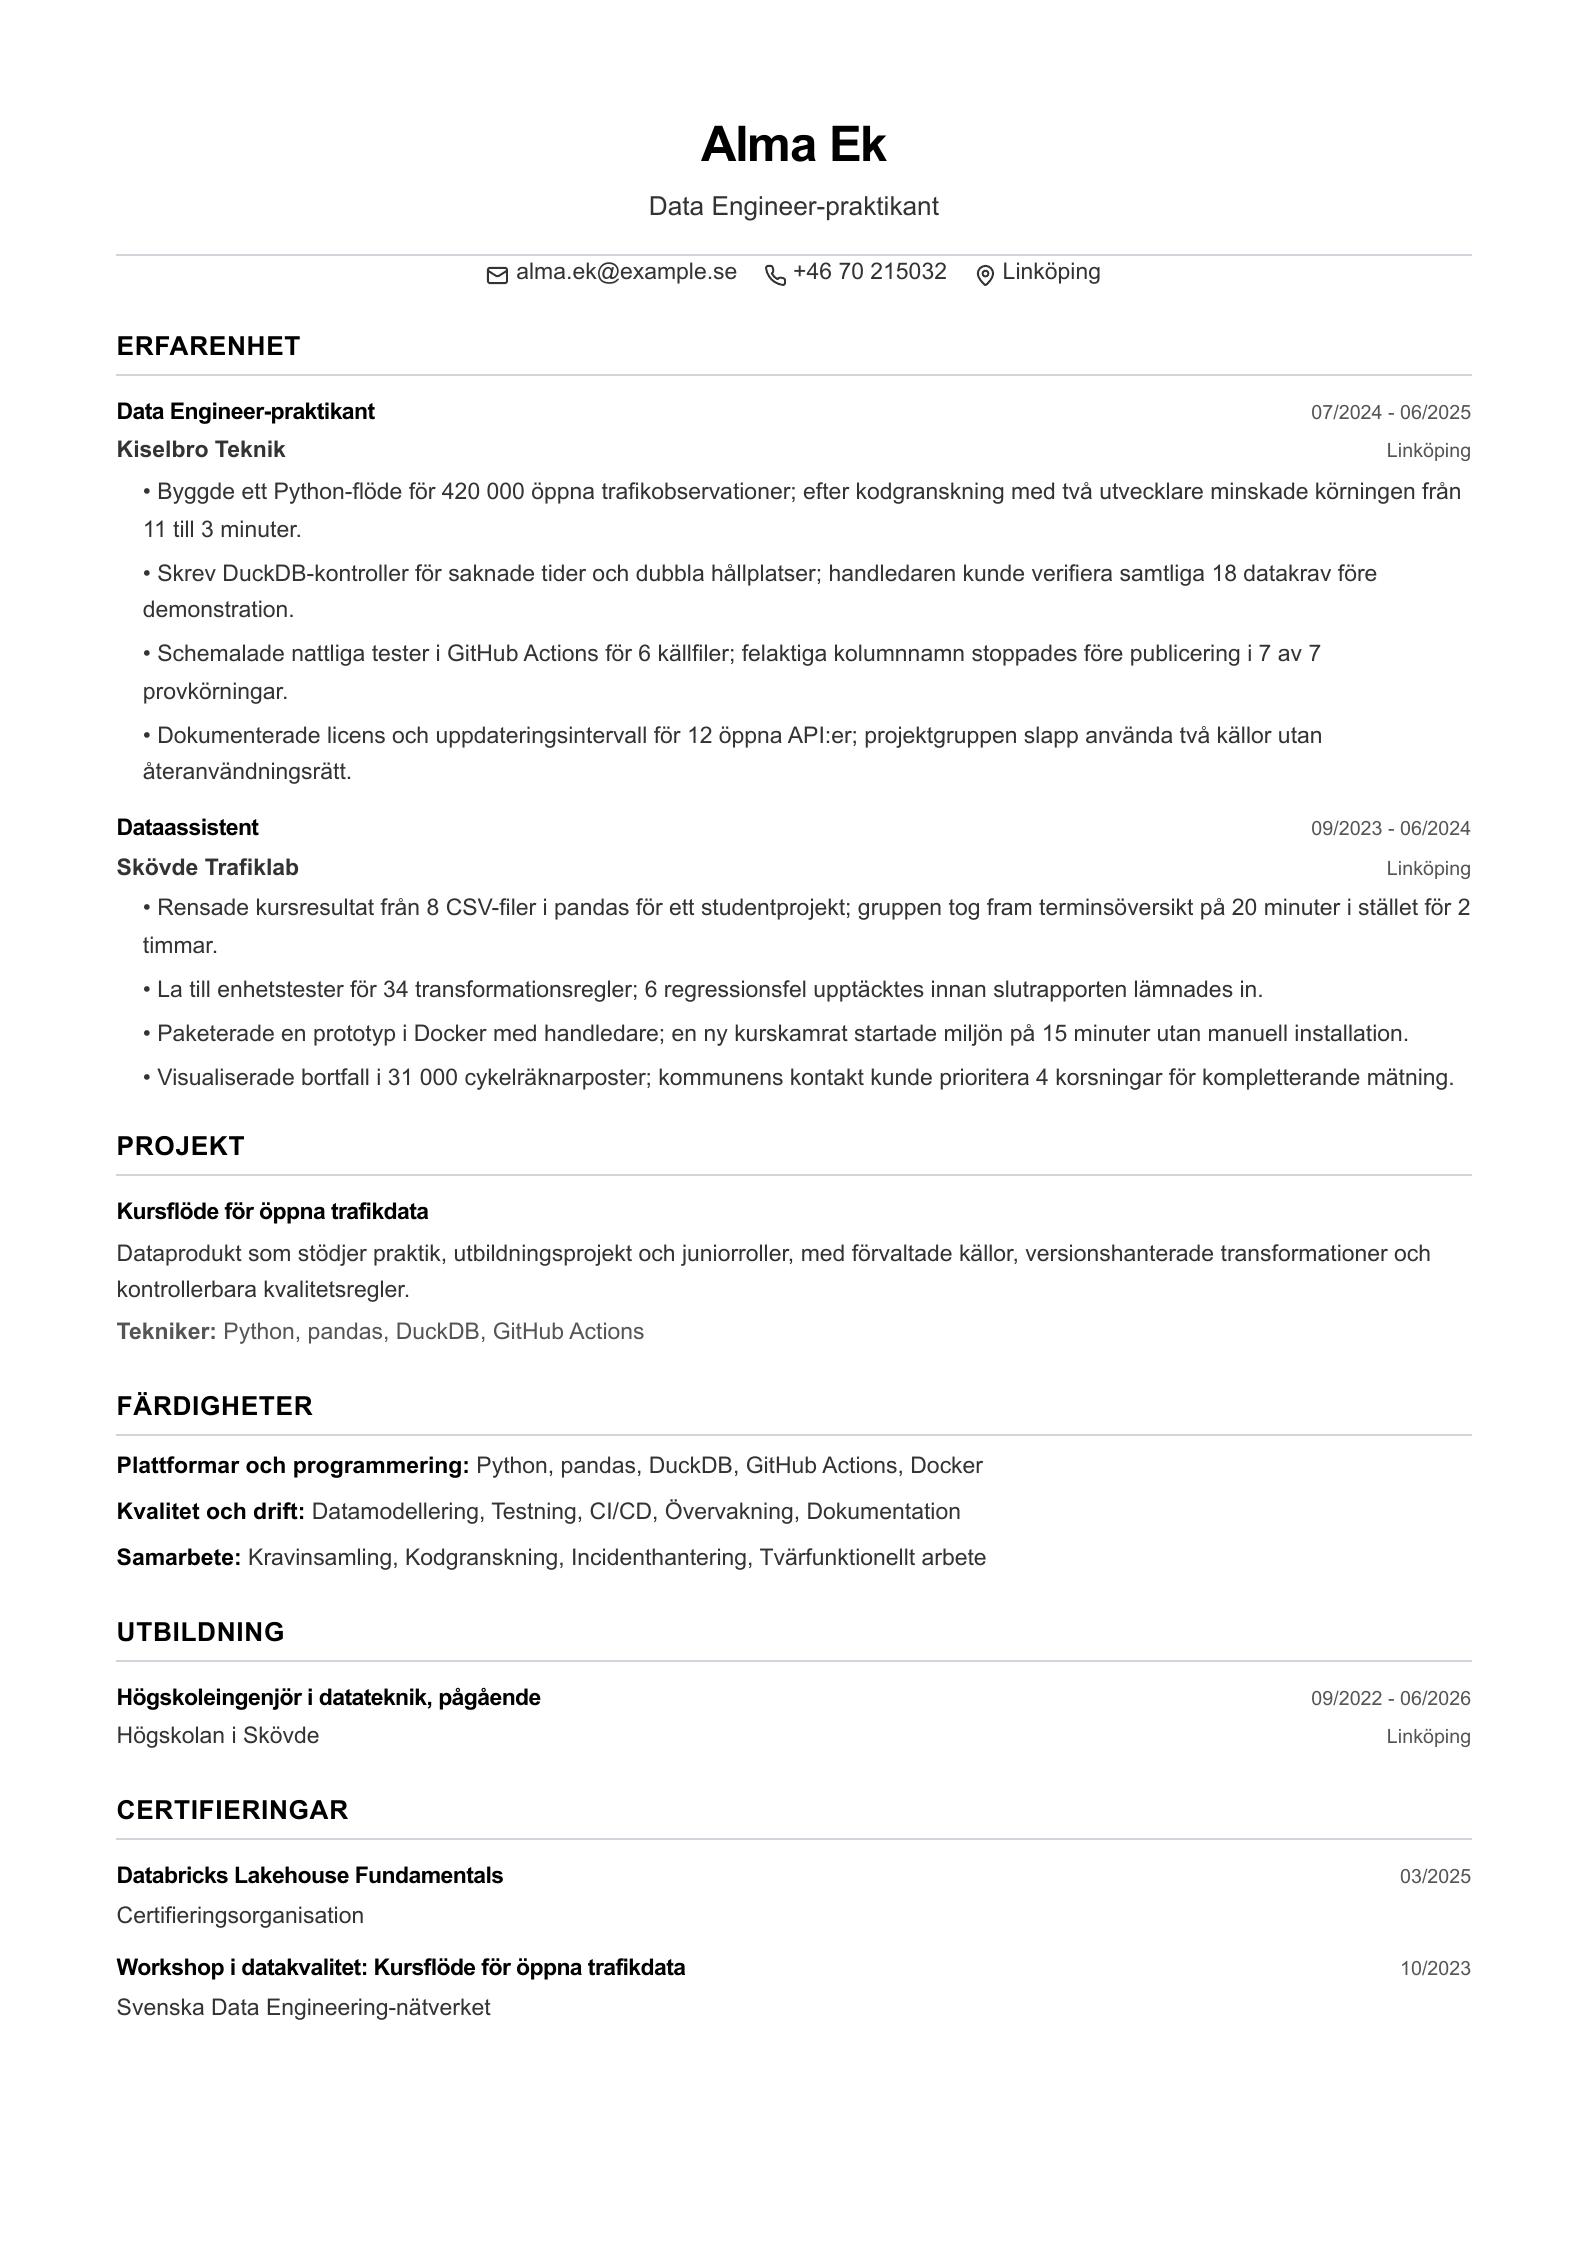
Praktik- och studieprojekt med tydligt avgränsade dataflöden.
Passar dig som: första data engineering-rollen
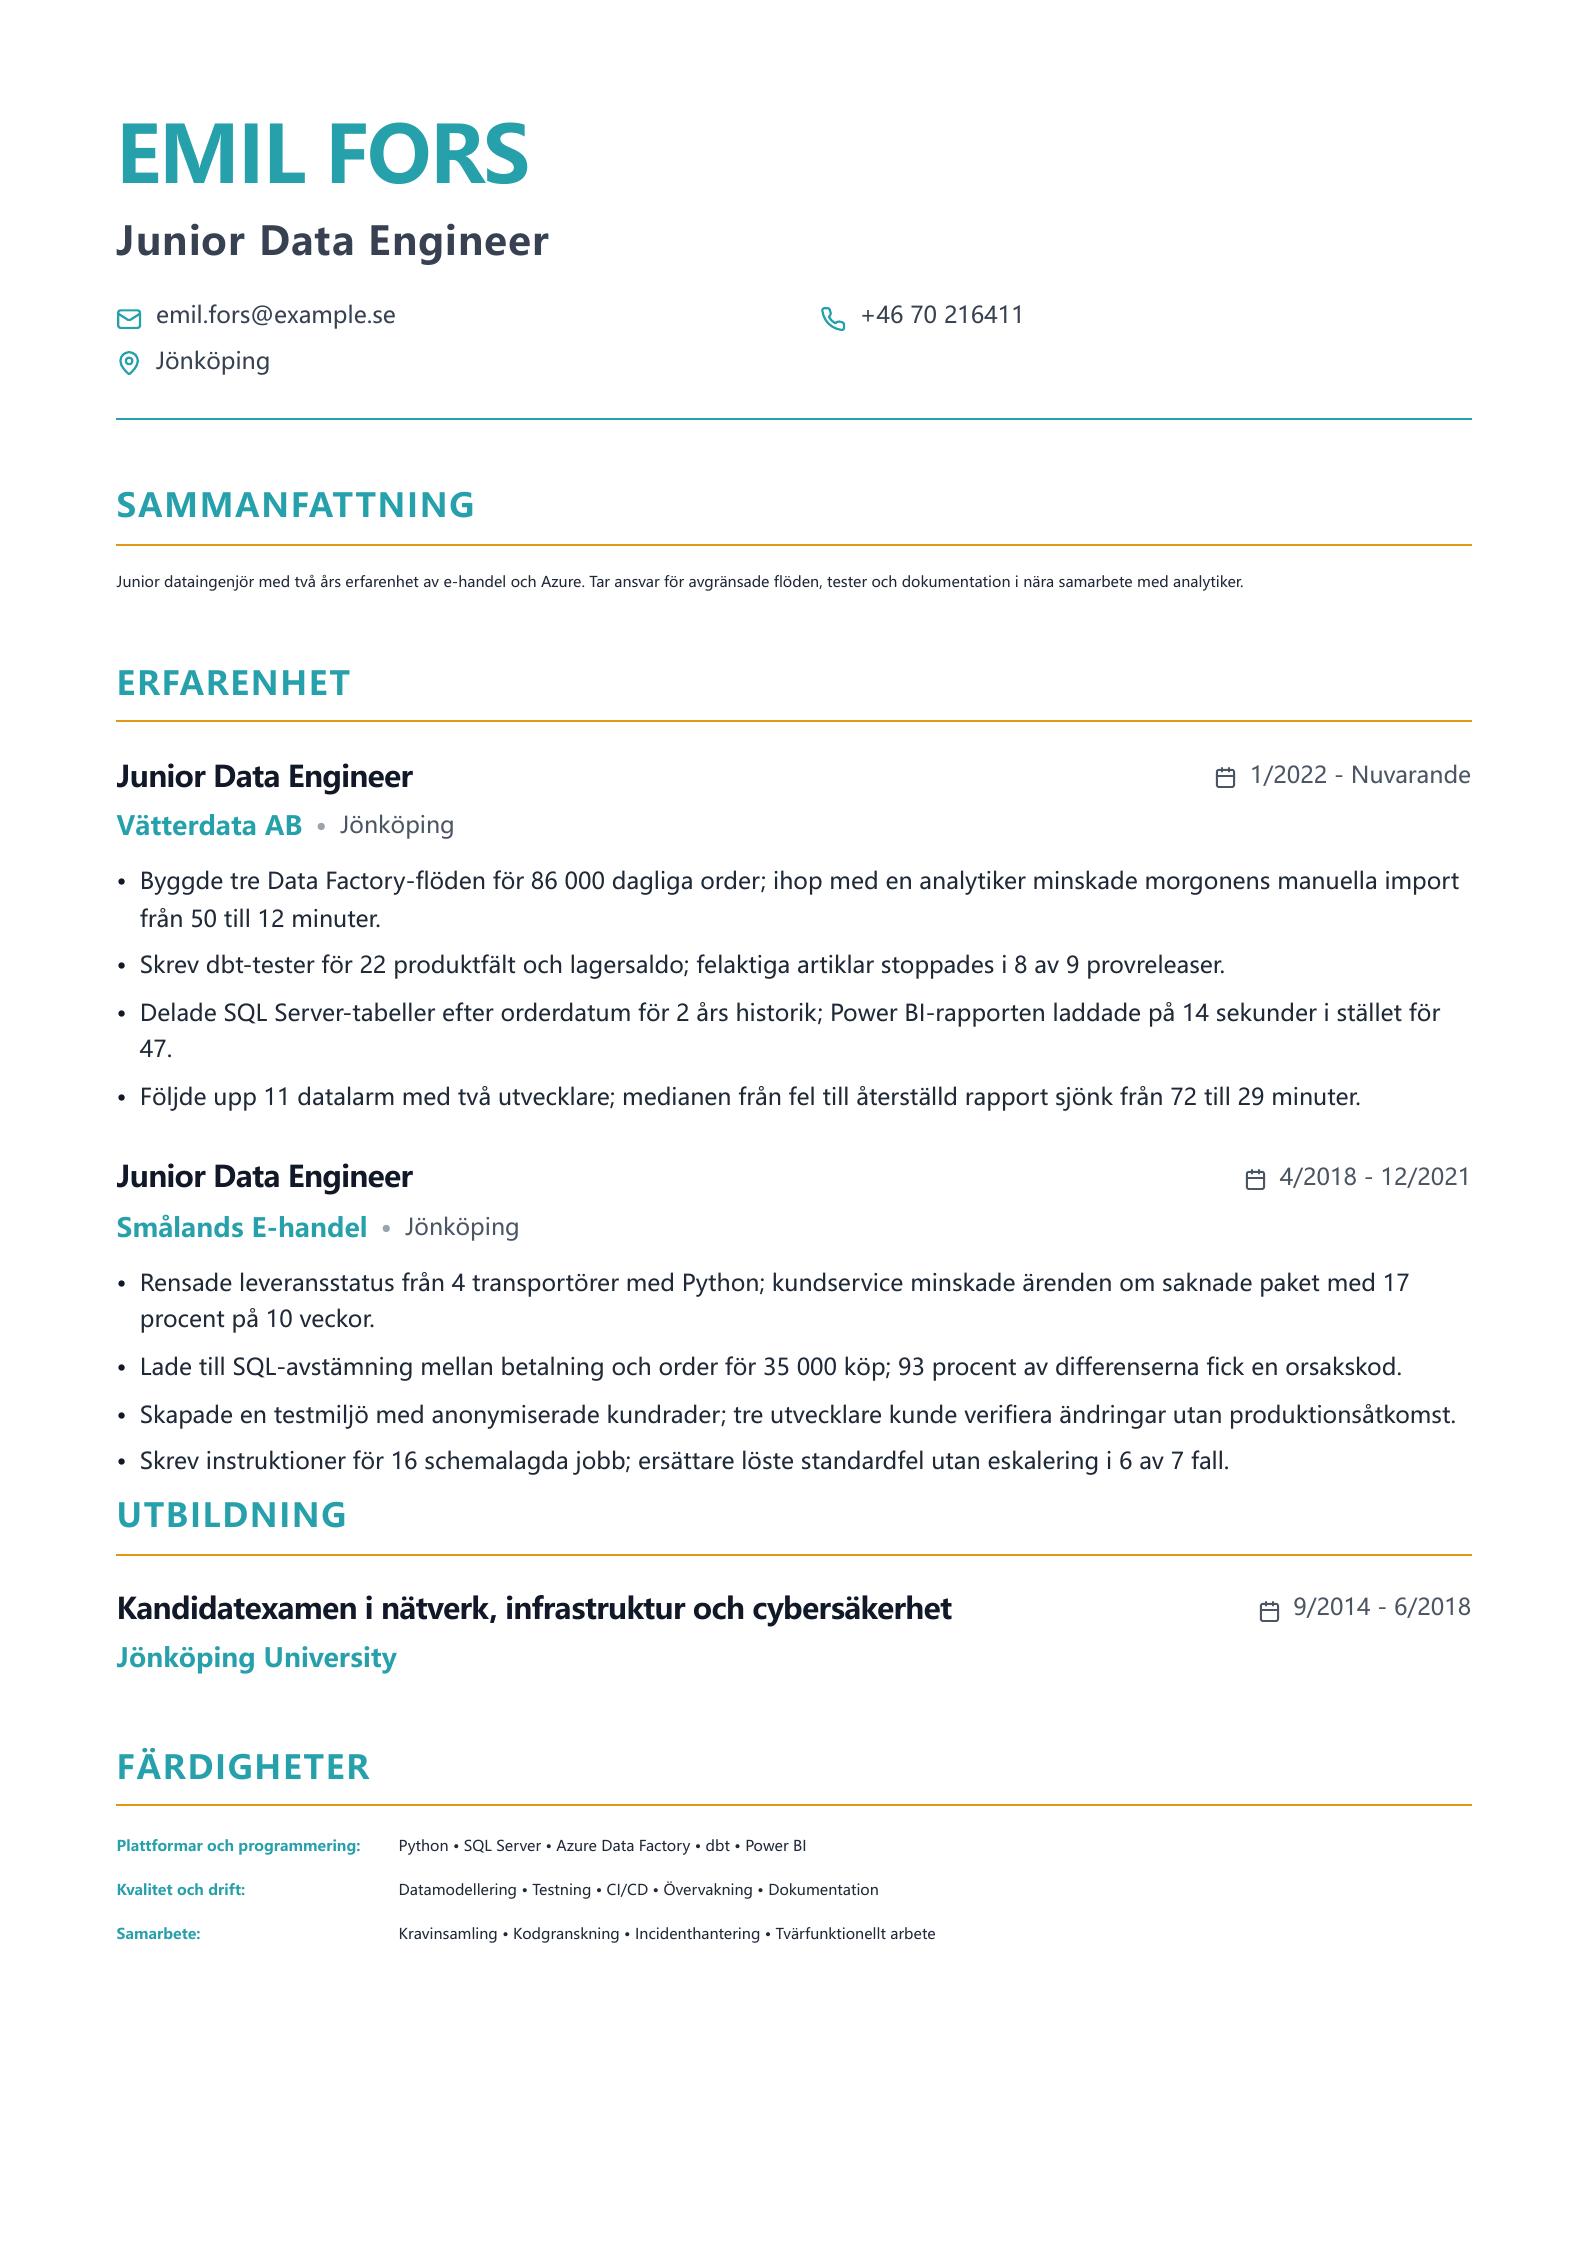
Ett junior-exempel som visar ansvar för avgränsade flöden och kvalitet.
Passar dig som: storskalig drift och tekniskt ledarskap
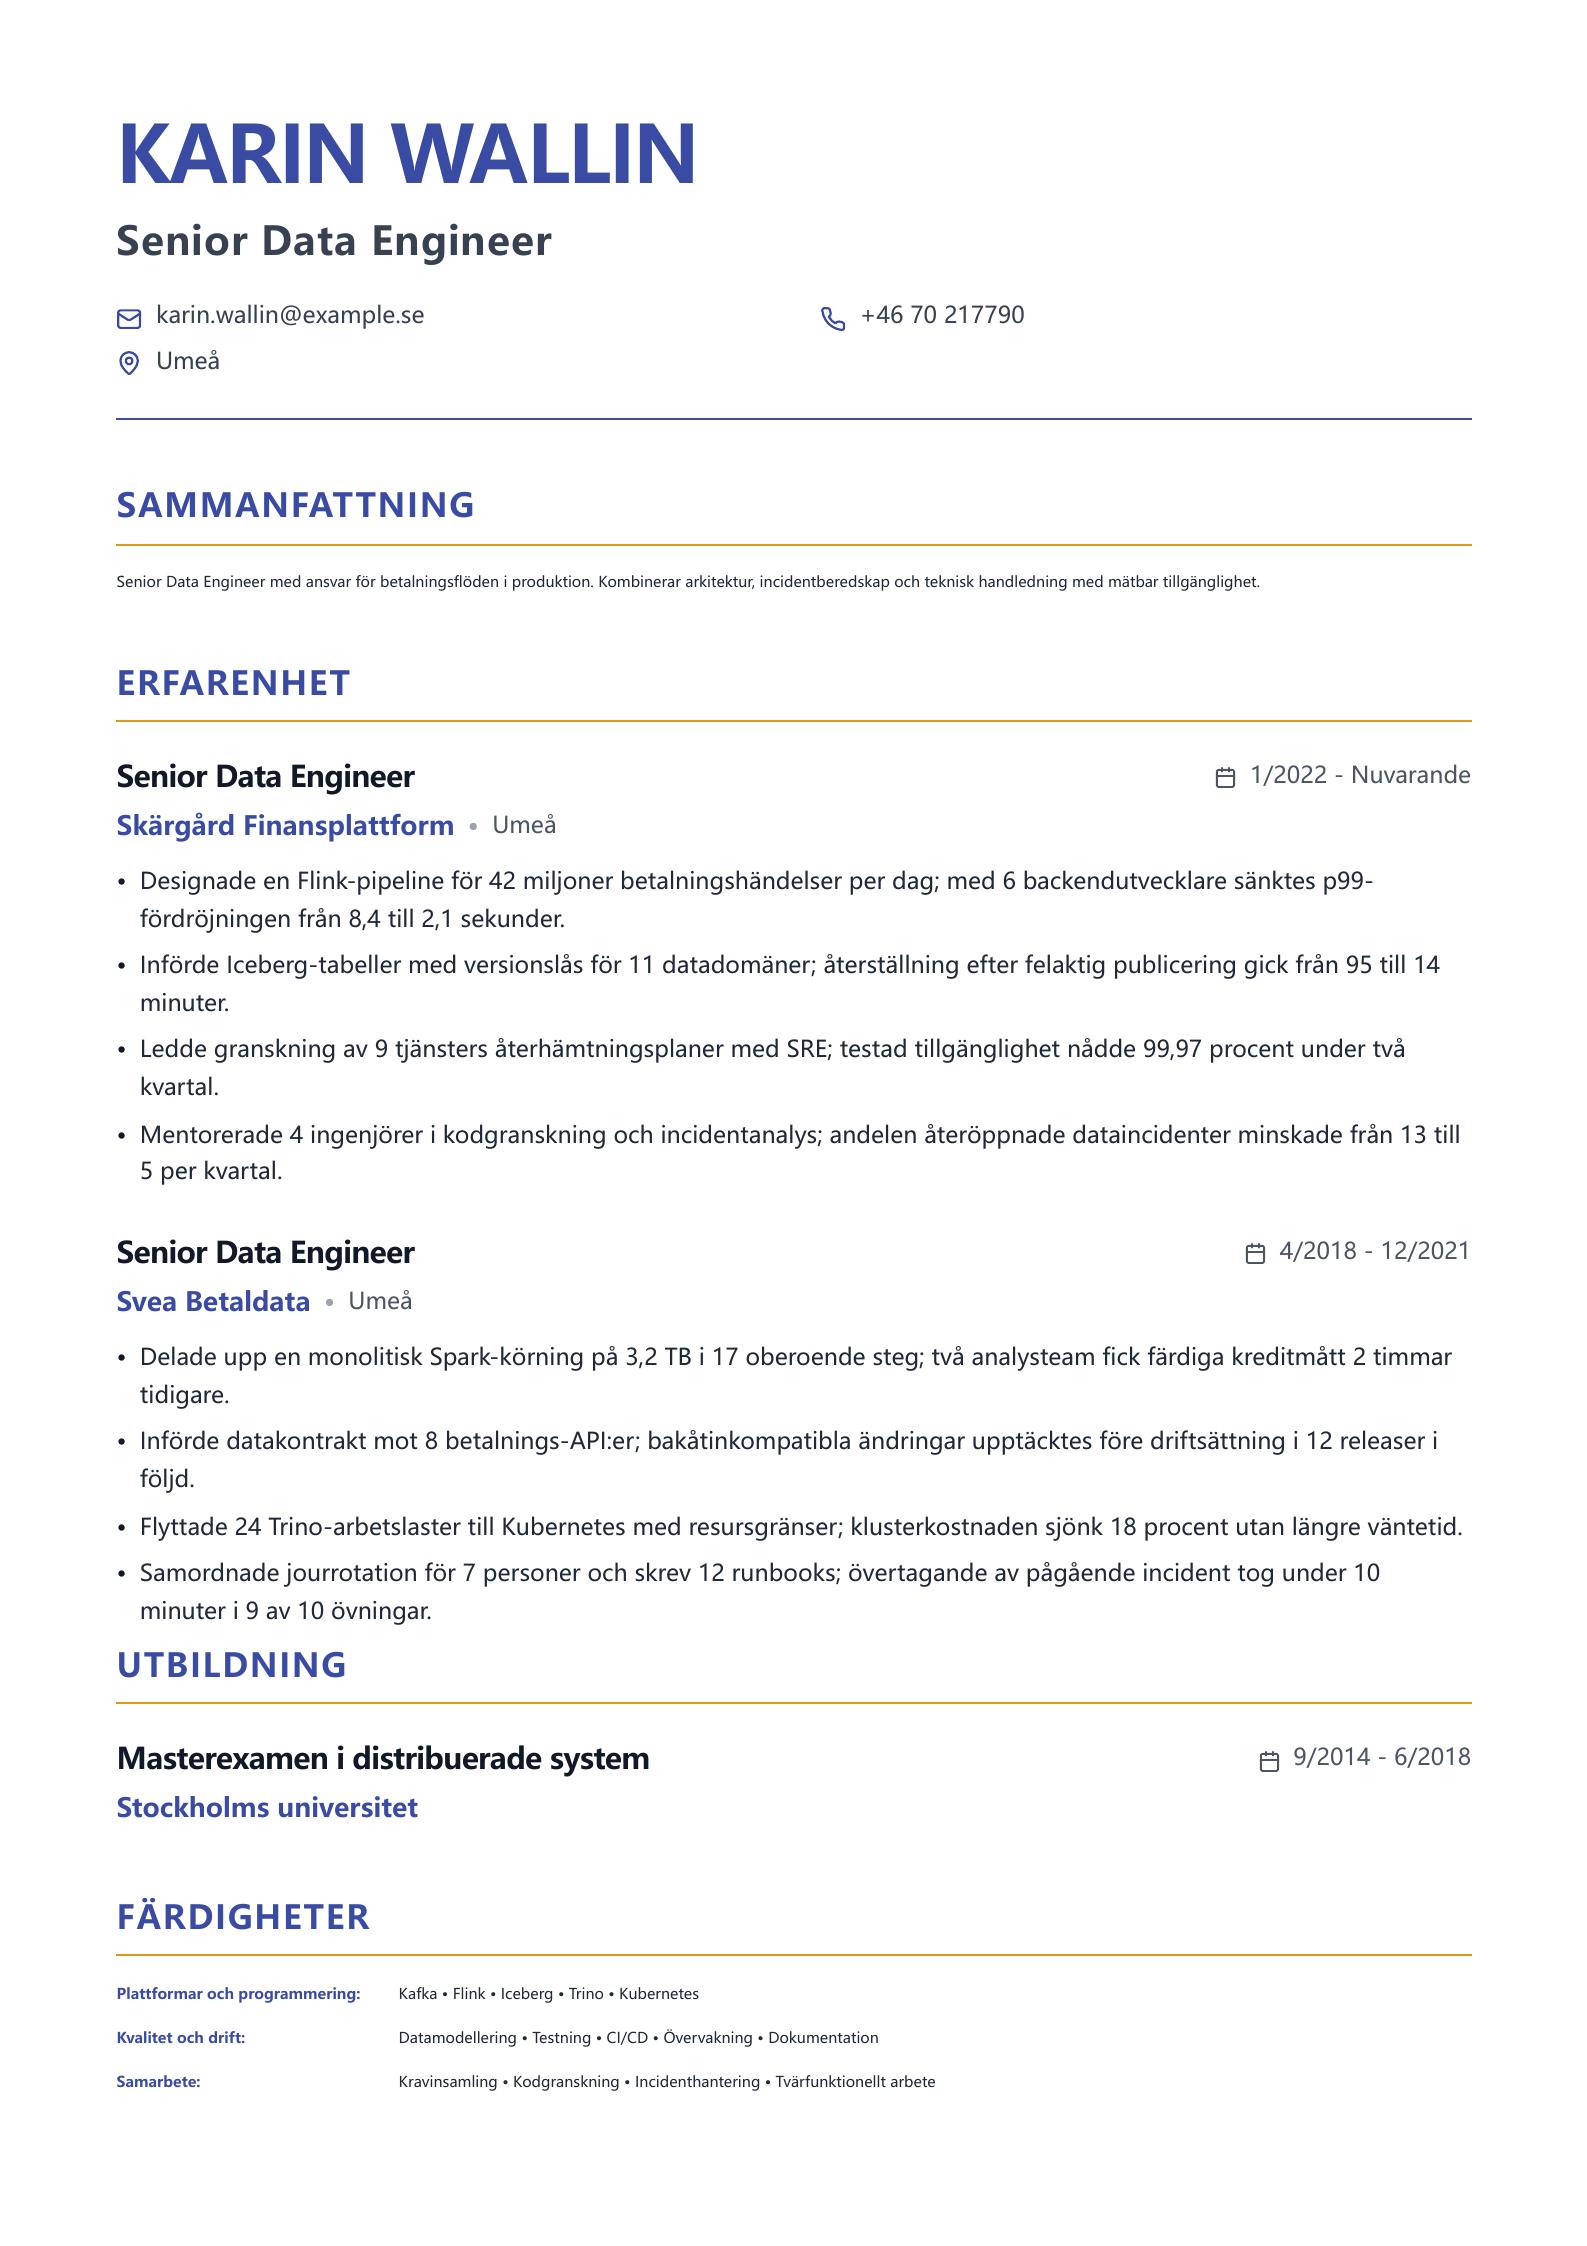
Seniorprofil med produktionsansvar, arkitekturbeslut och mentorskap.
Passar dig som: plattformarkitektur och data mesh
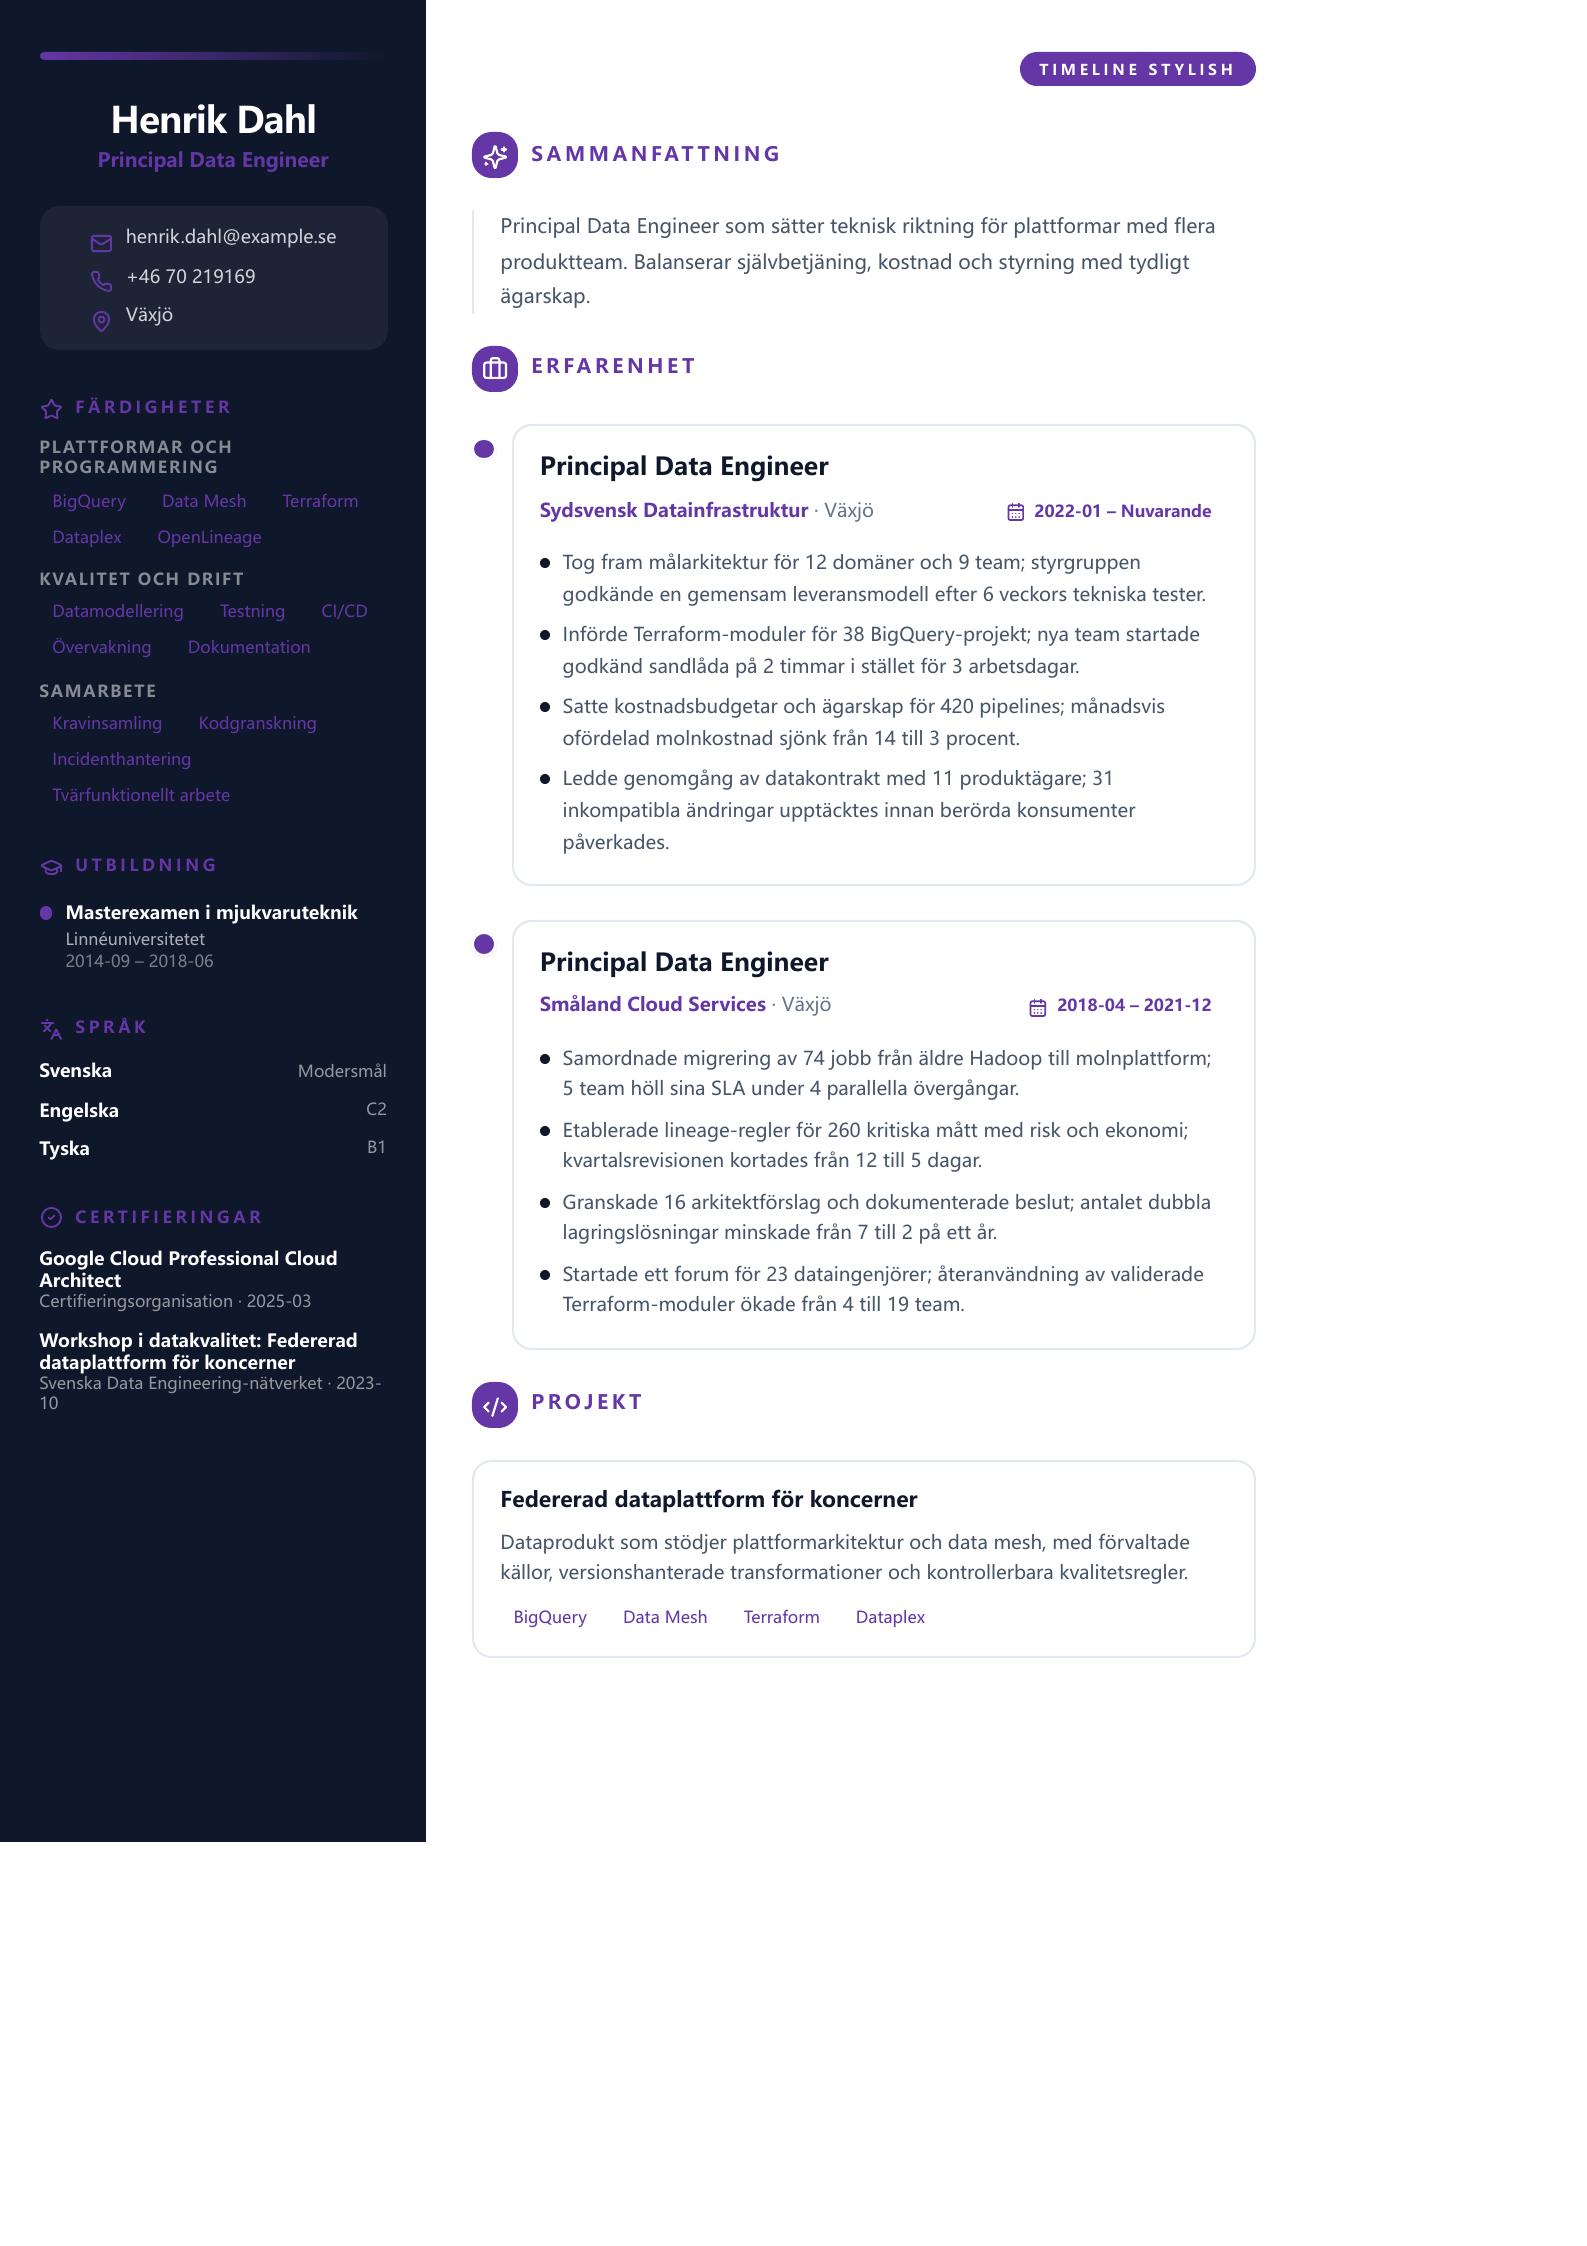
Visar plattformsstrategi, standarder och samarbete mellan flera domäner.
Passar dig som: PySpark, batchjobb och ML-underlag
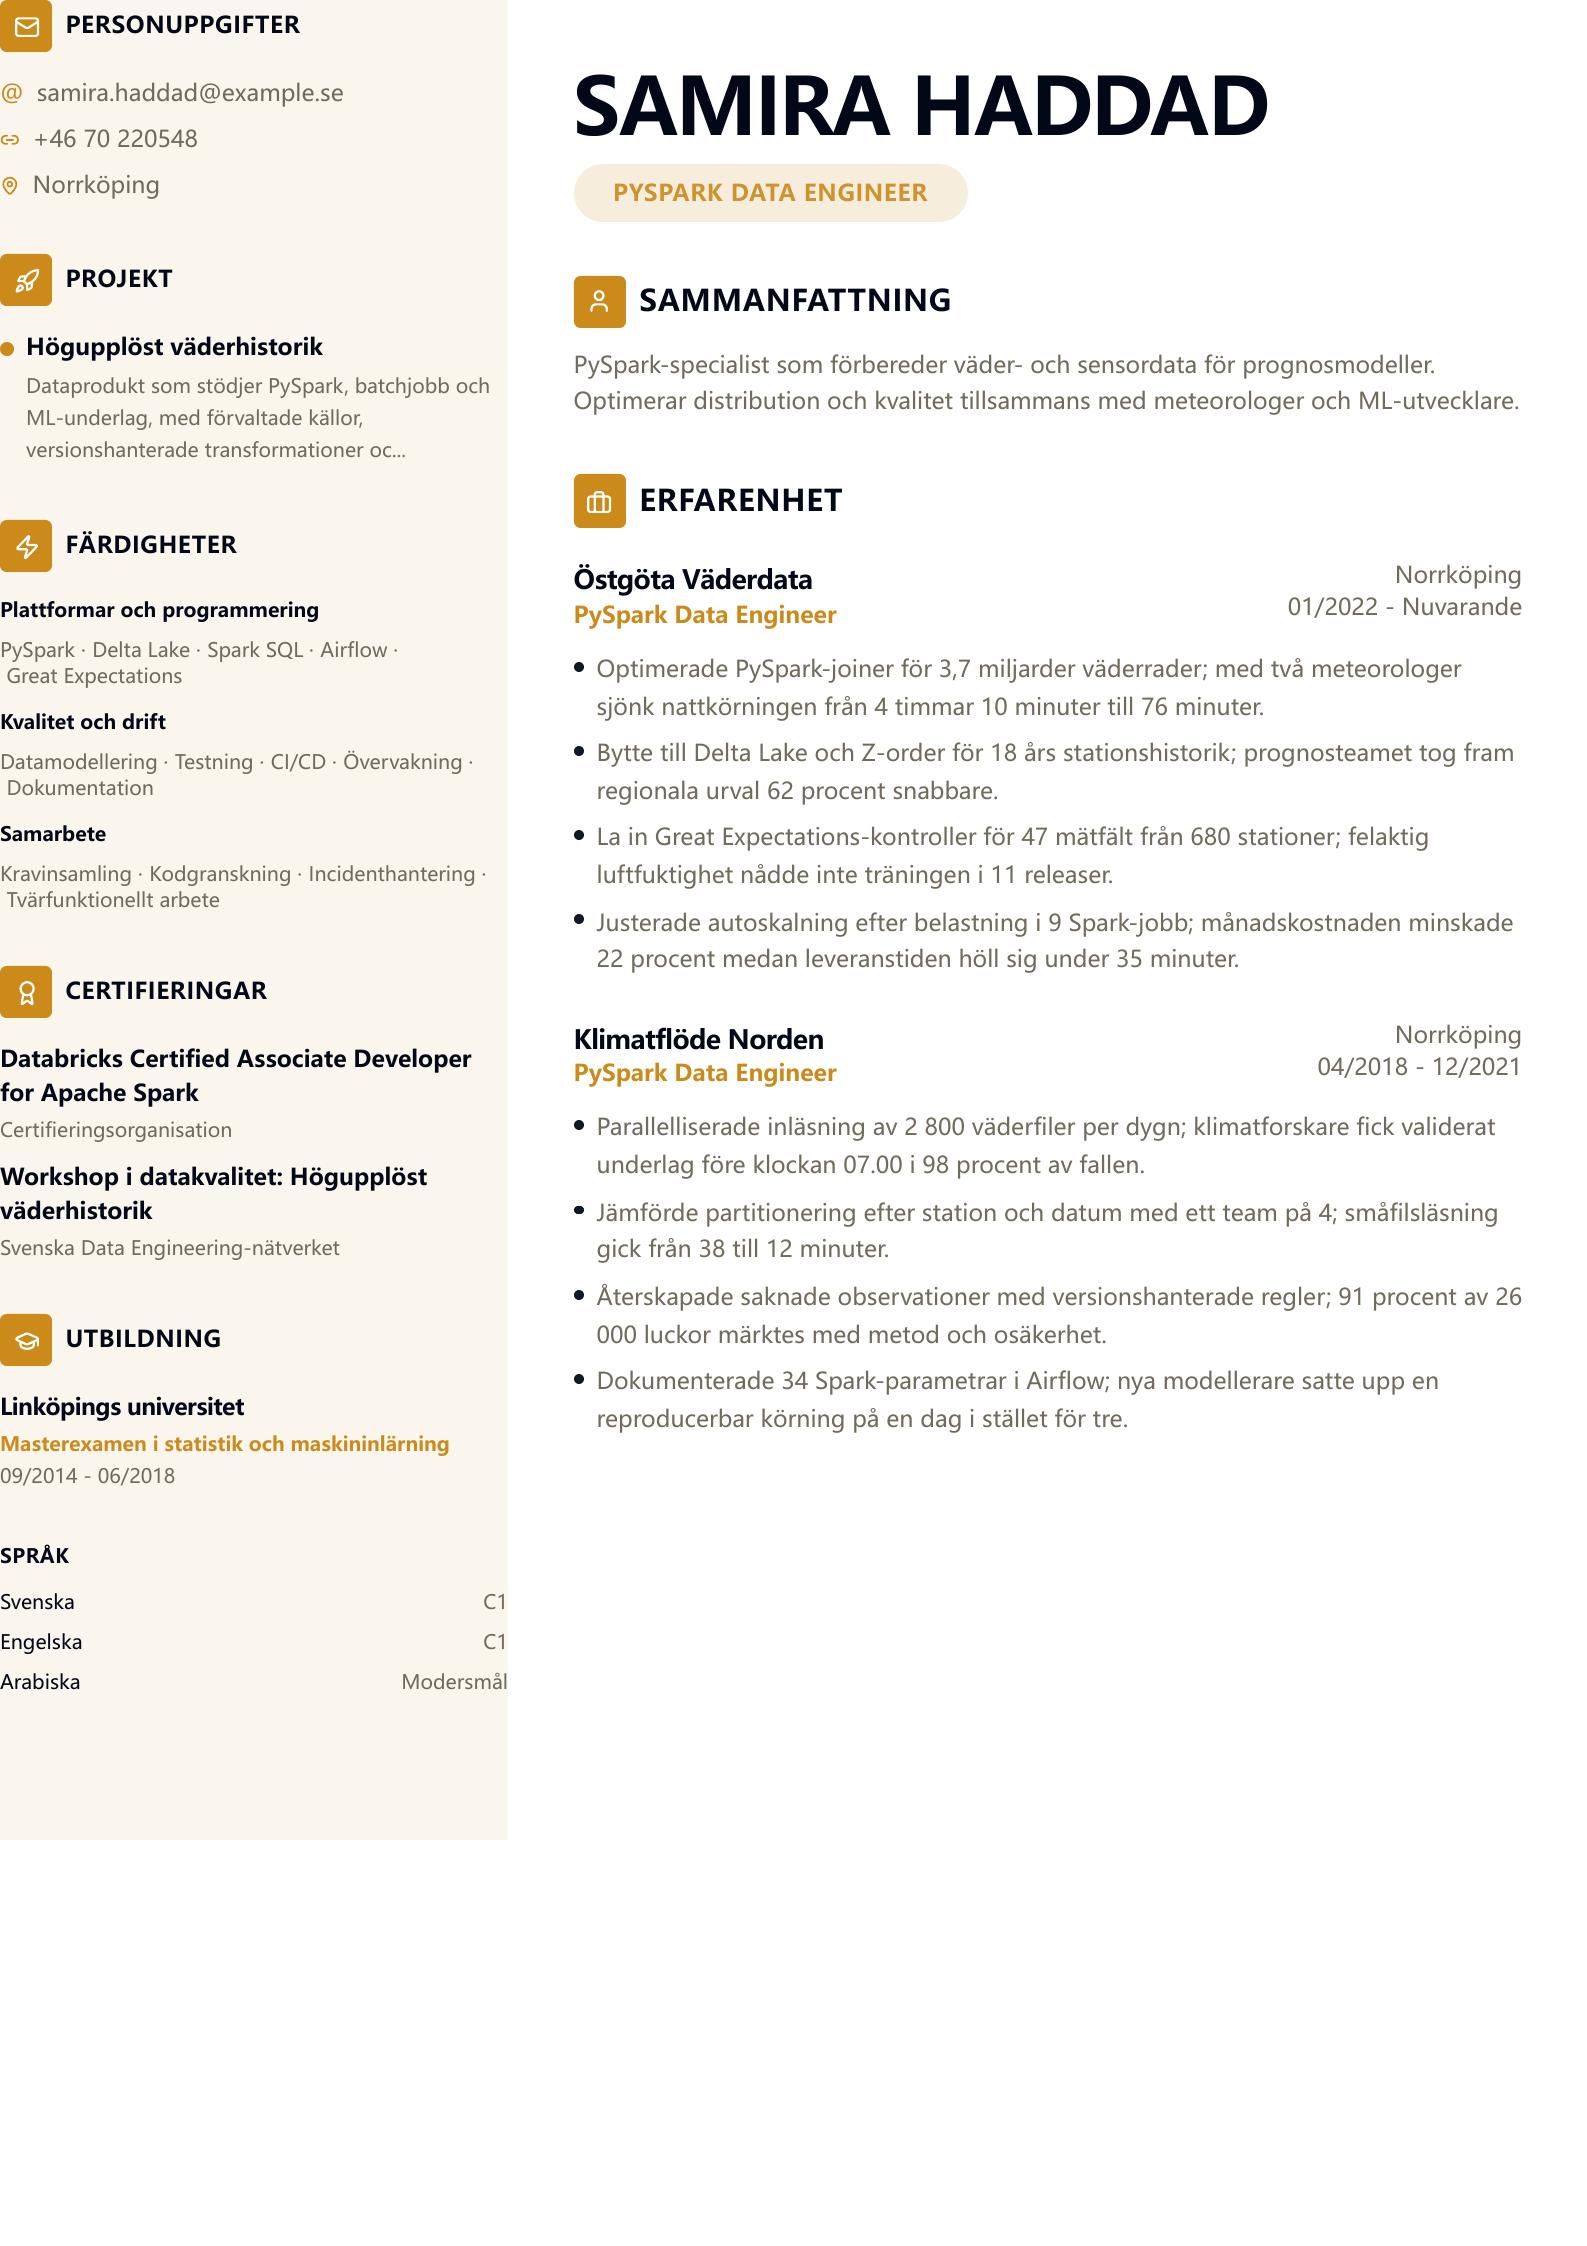
Fokus på Spark, stora sensordataflöden och beräkningskostnad.
Passar dig som: Python, API:er och integrationer
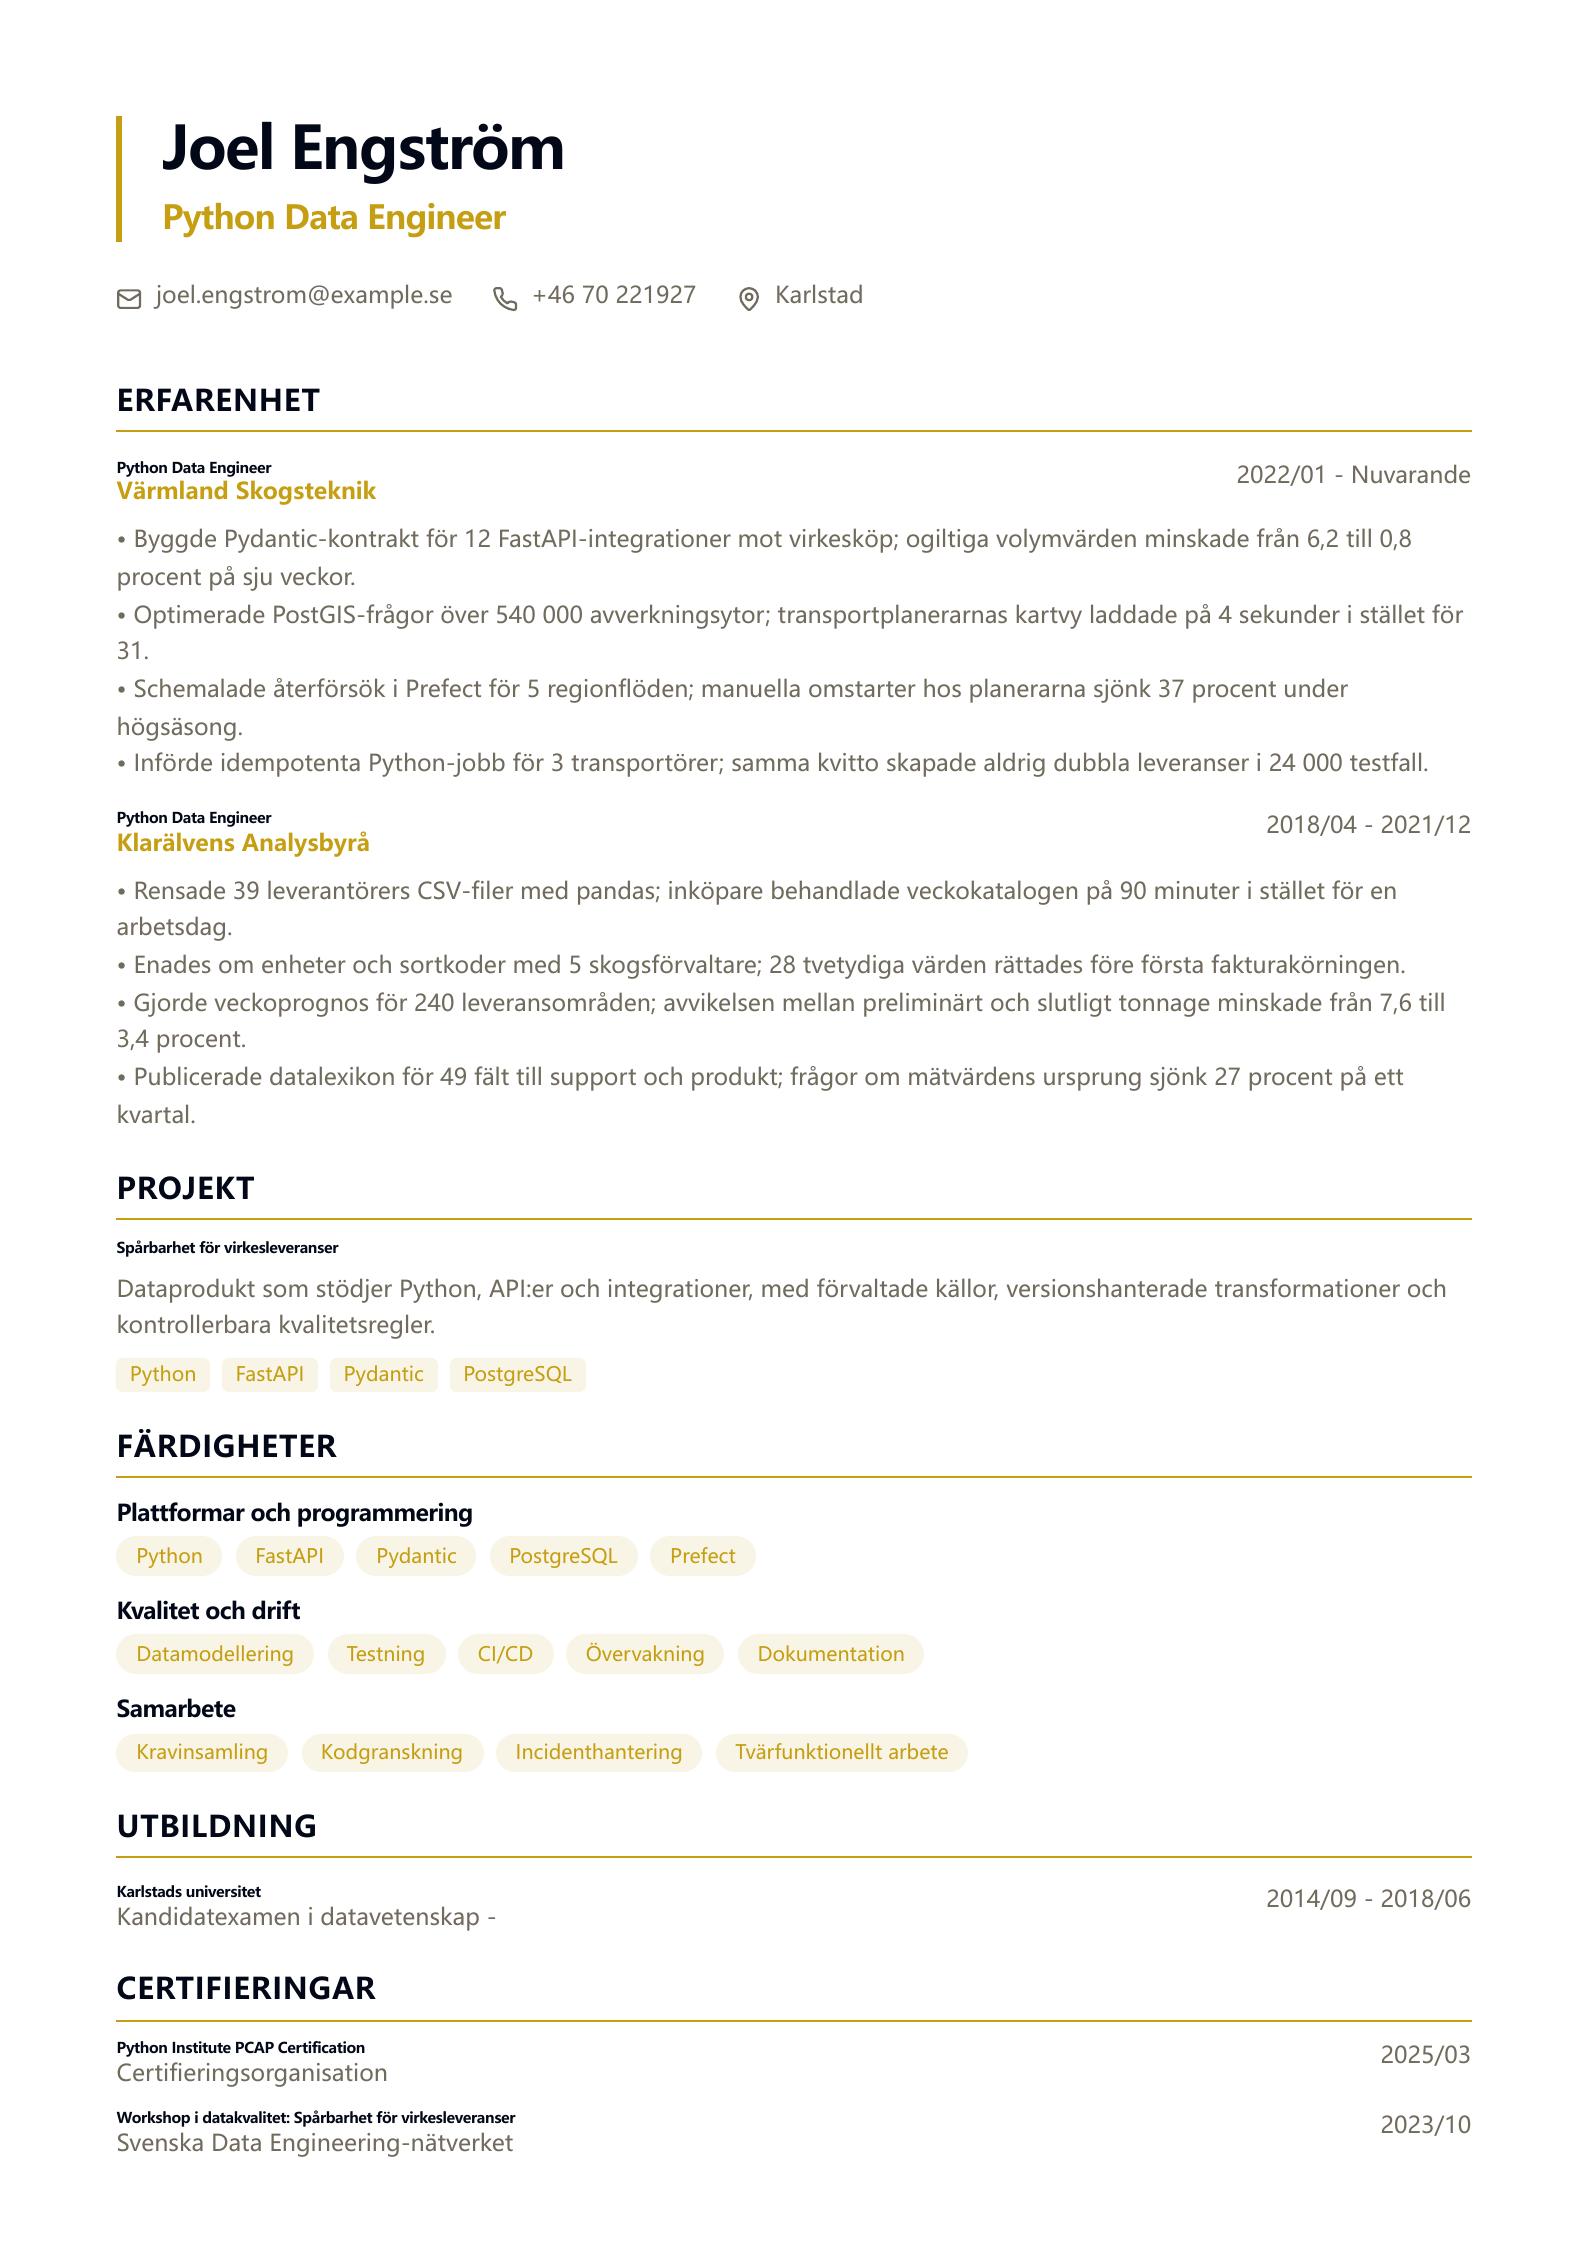
Praktiskt exempel på Python-API:er, schemavalidering och dataintegration.
Passar dig som: Kafka, realtidsdata och produktanalys
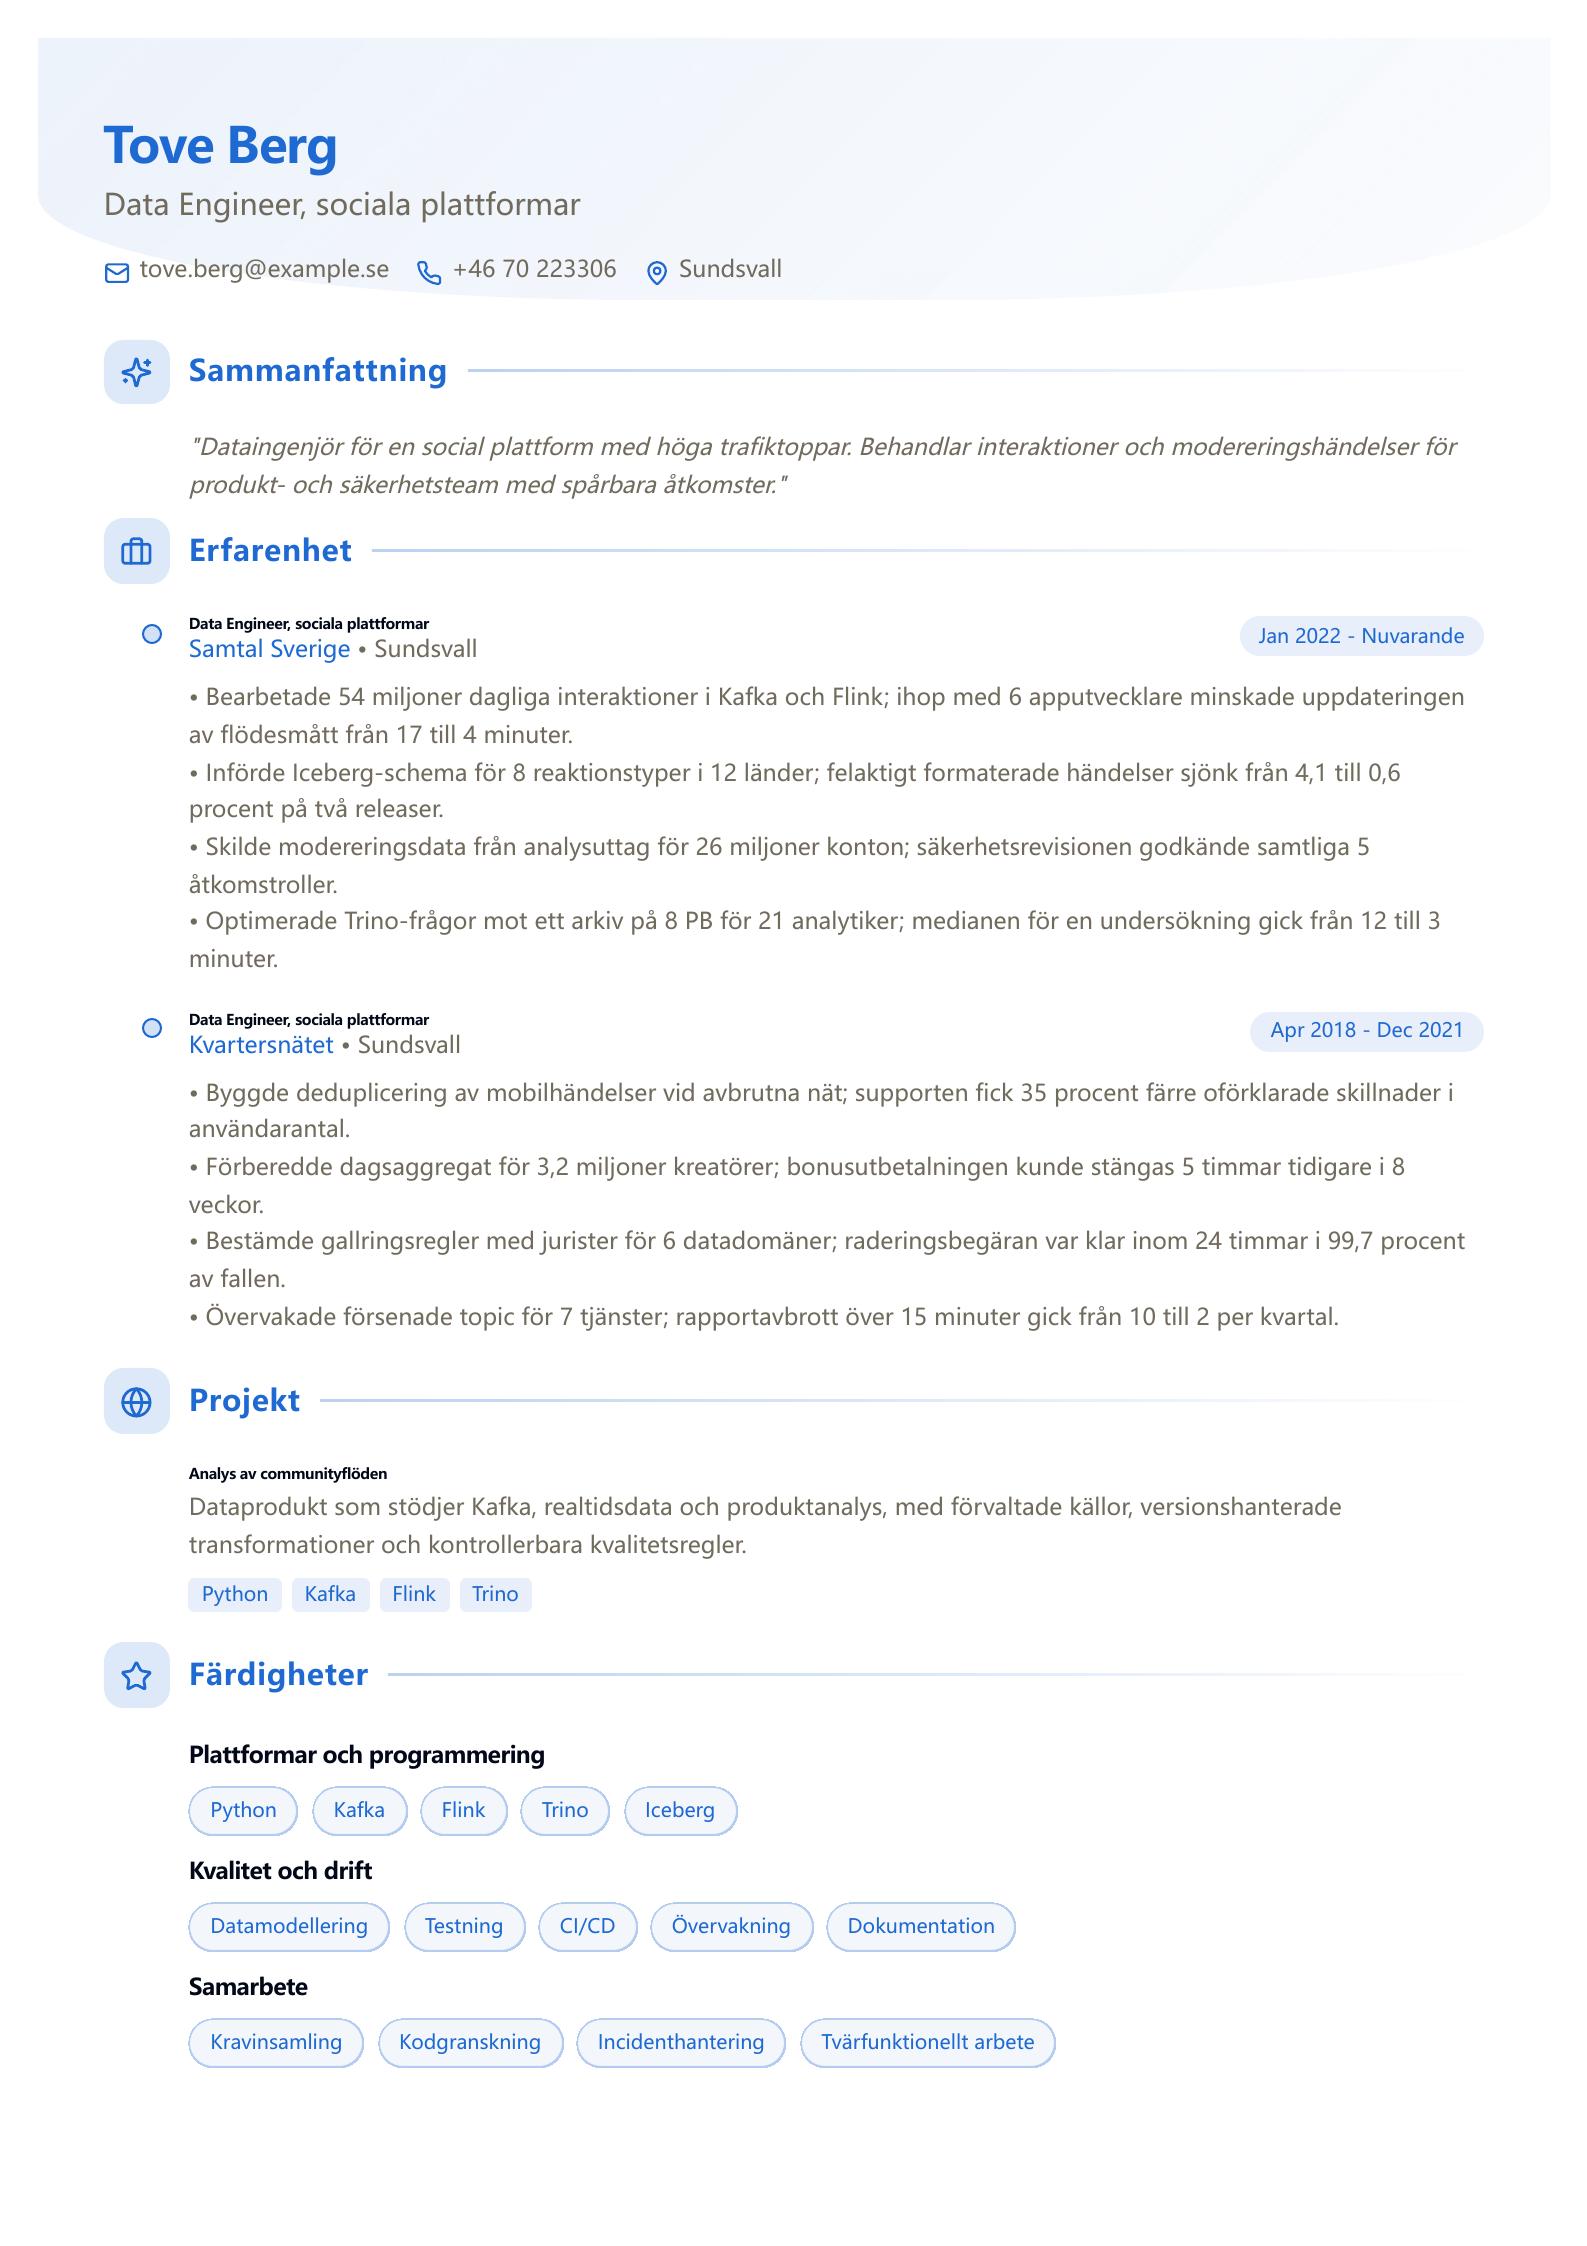
Eventströmmar och produktmått för en communitytjänst.
Passar dig som: dbt, SQL och BI-samarbete
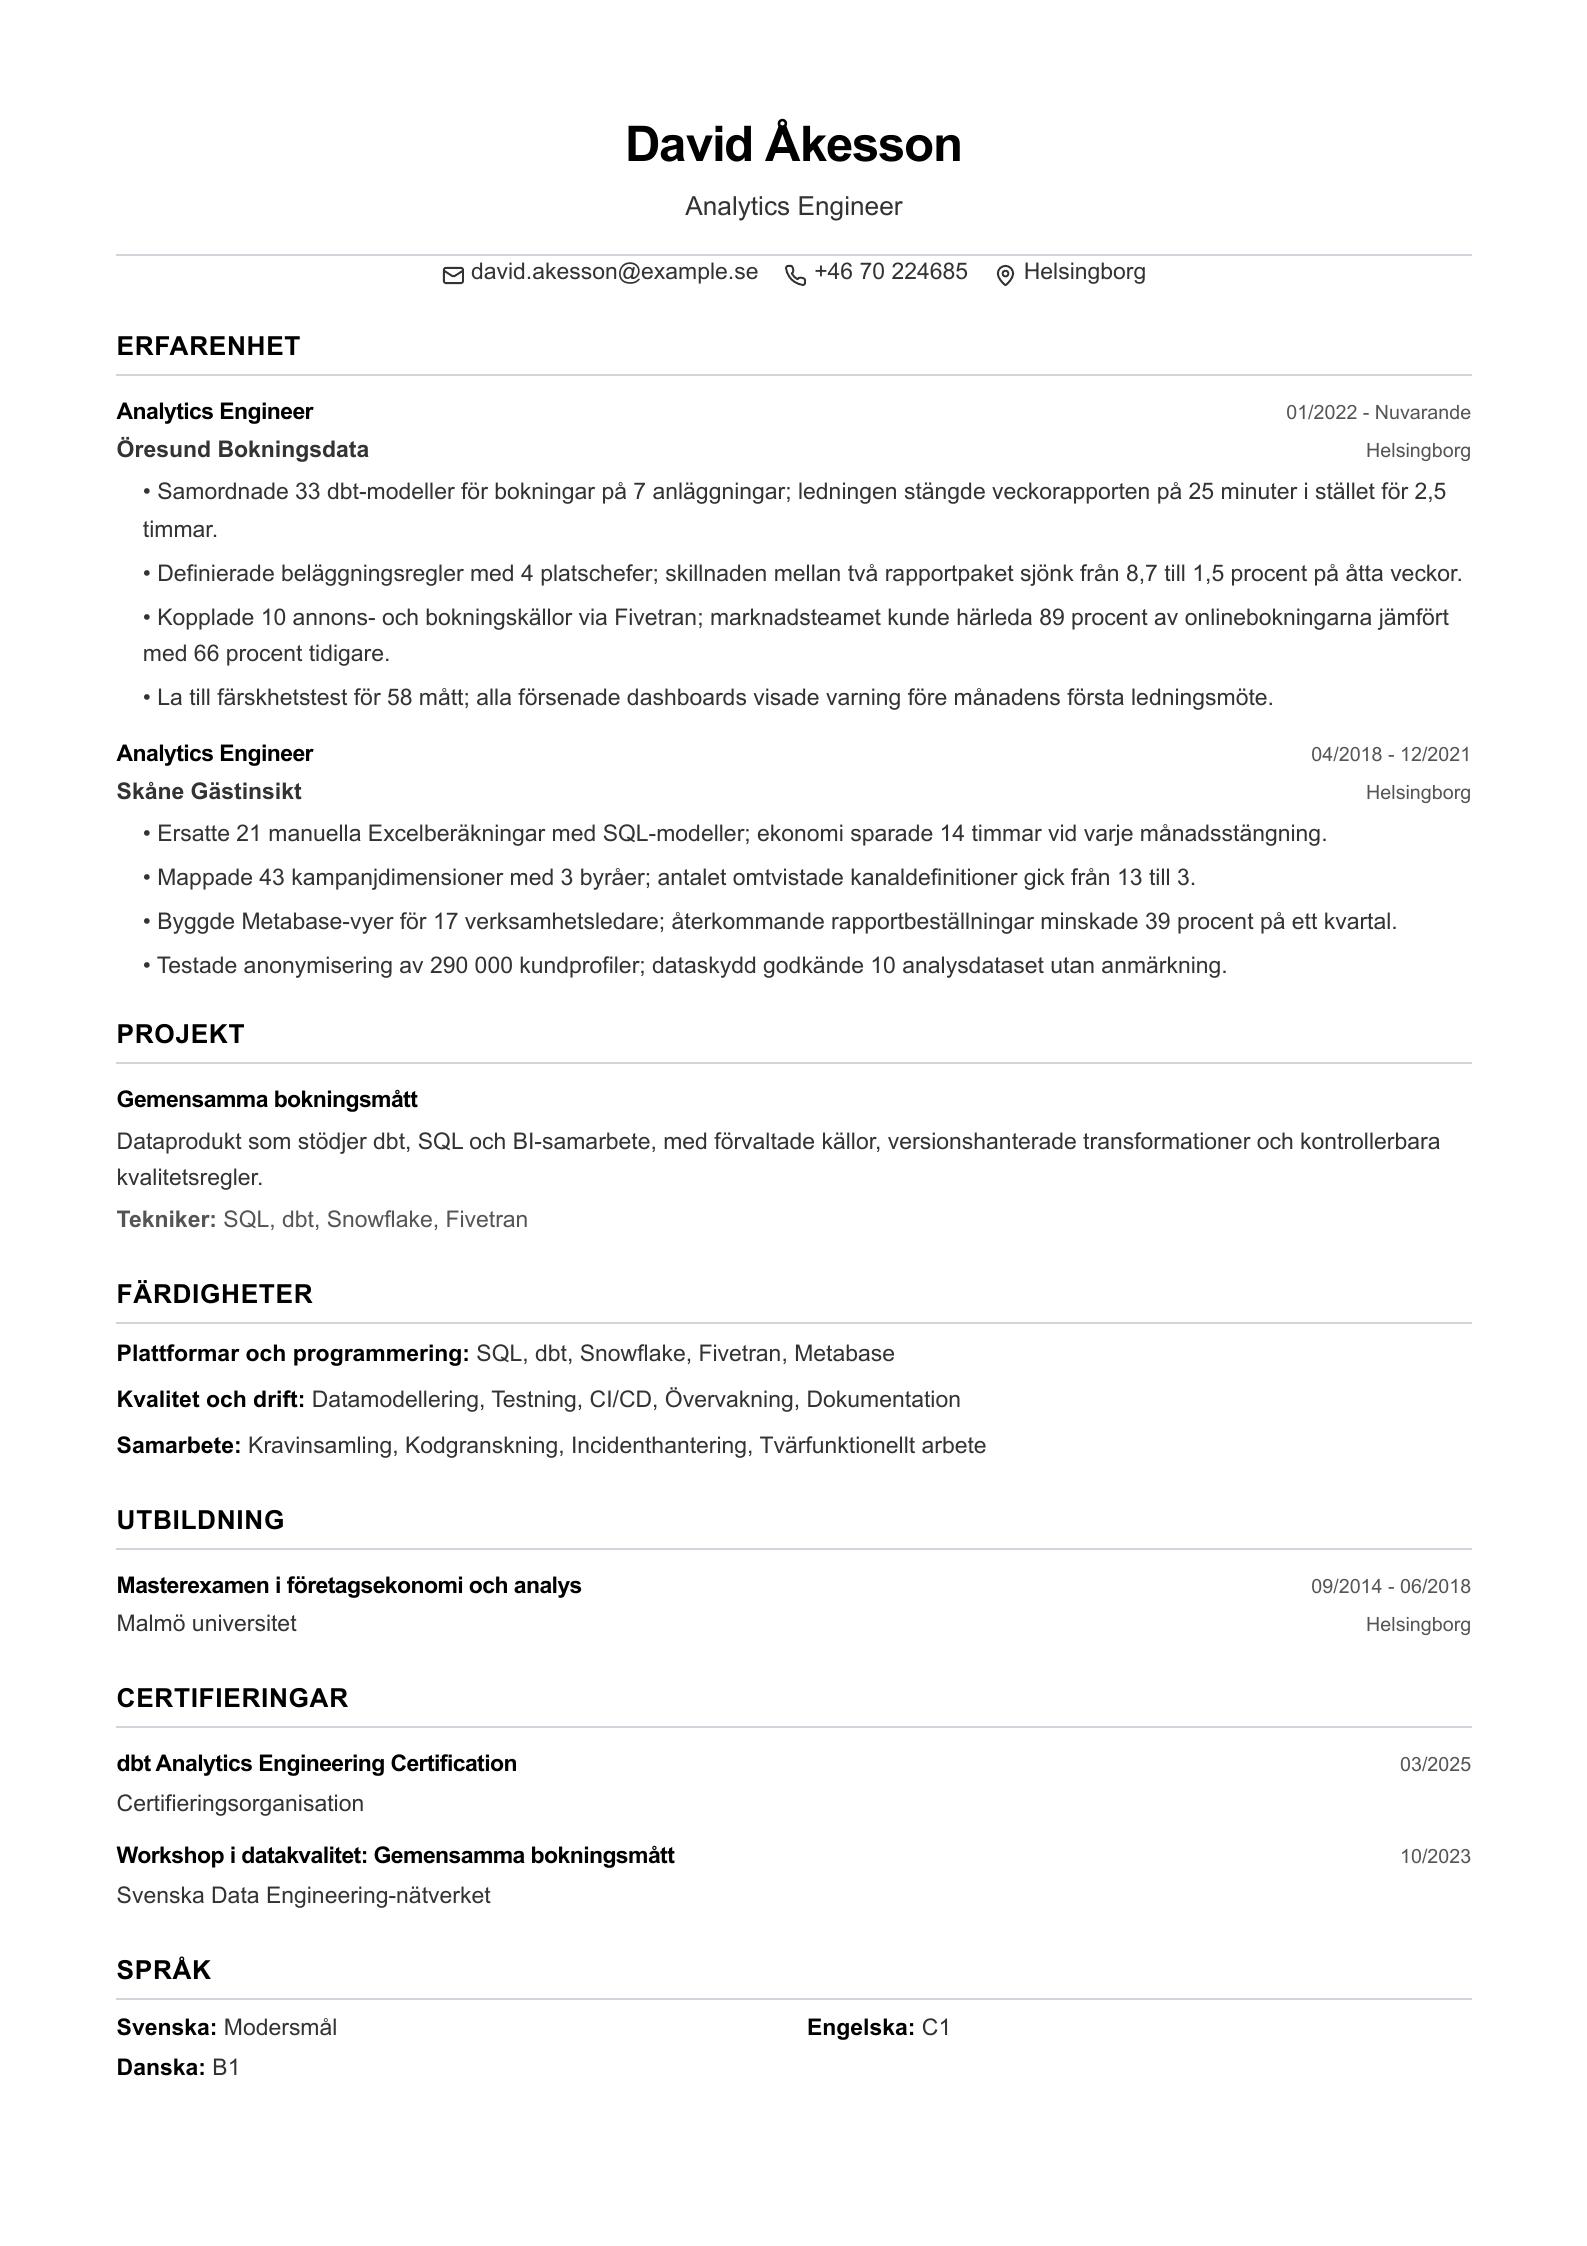
Analytiska modeller, måttdefinitioner och självbetjäning för verksamheten.
Passar dig som: ETL, ERP och batchbearbetning
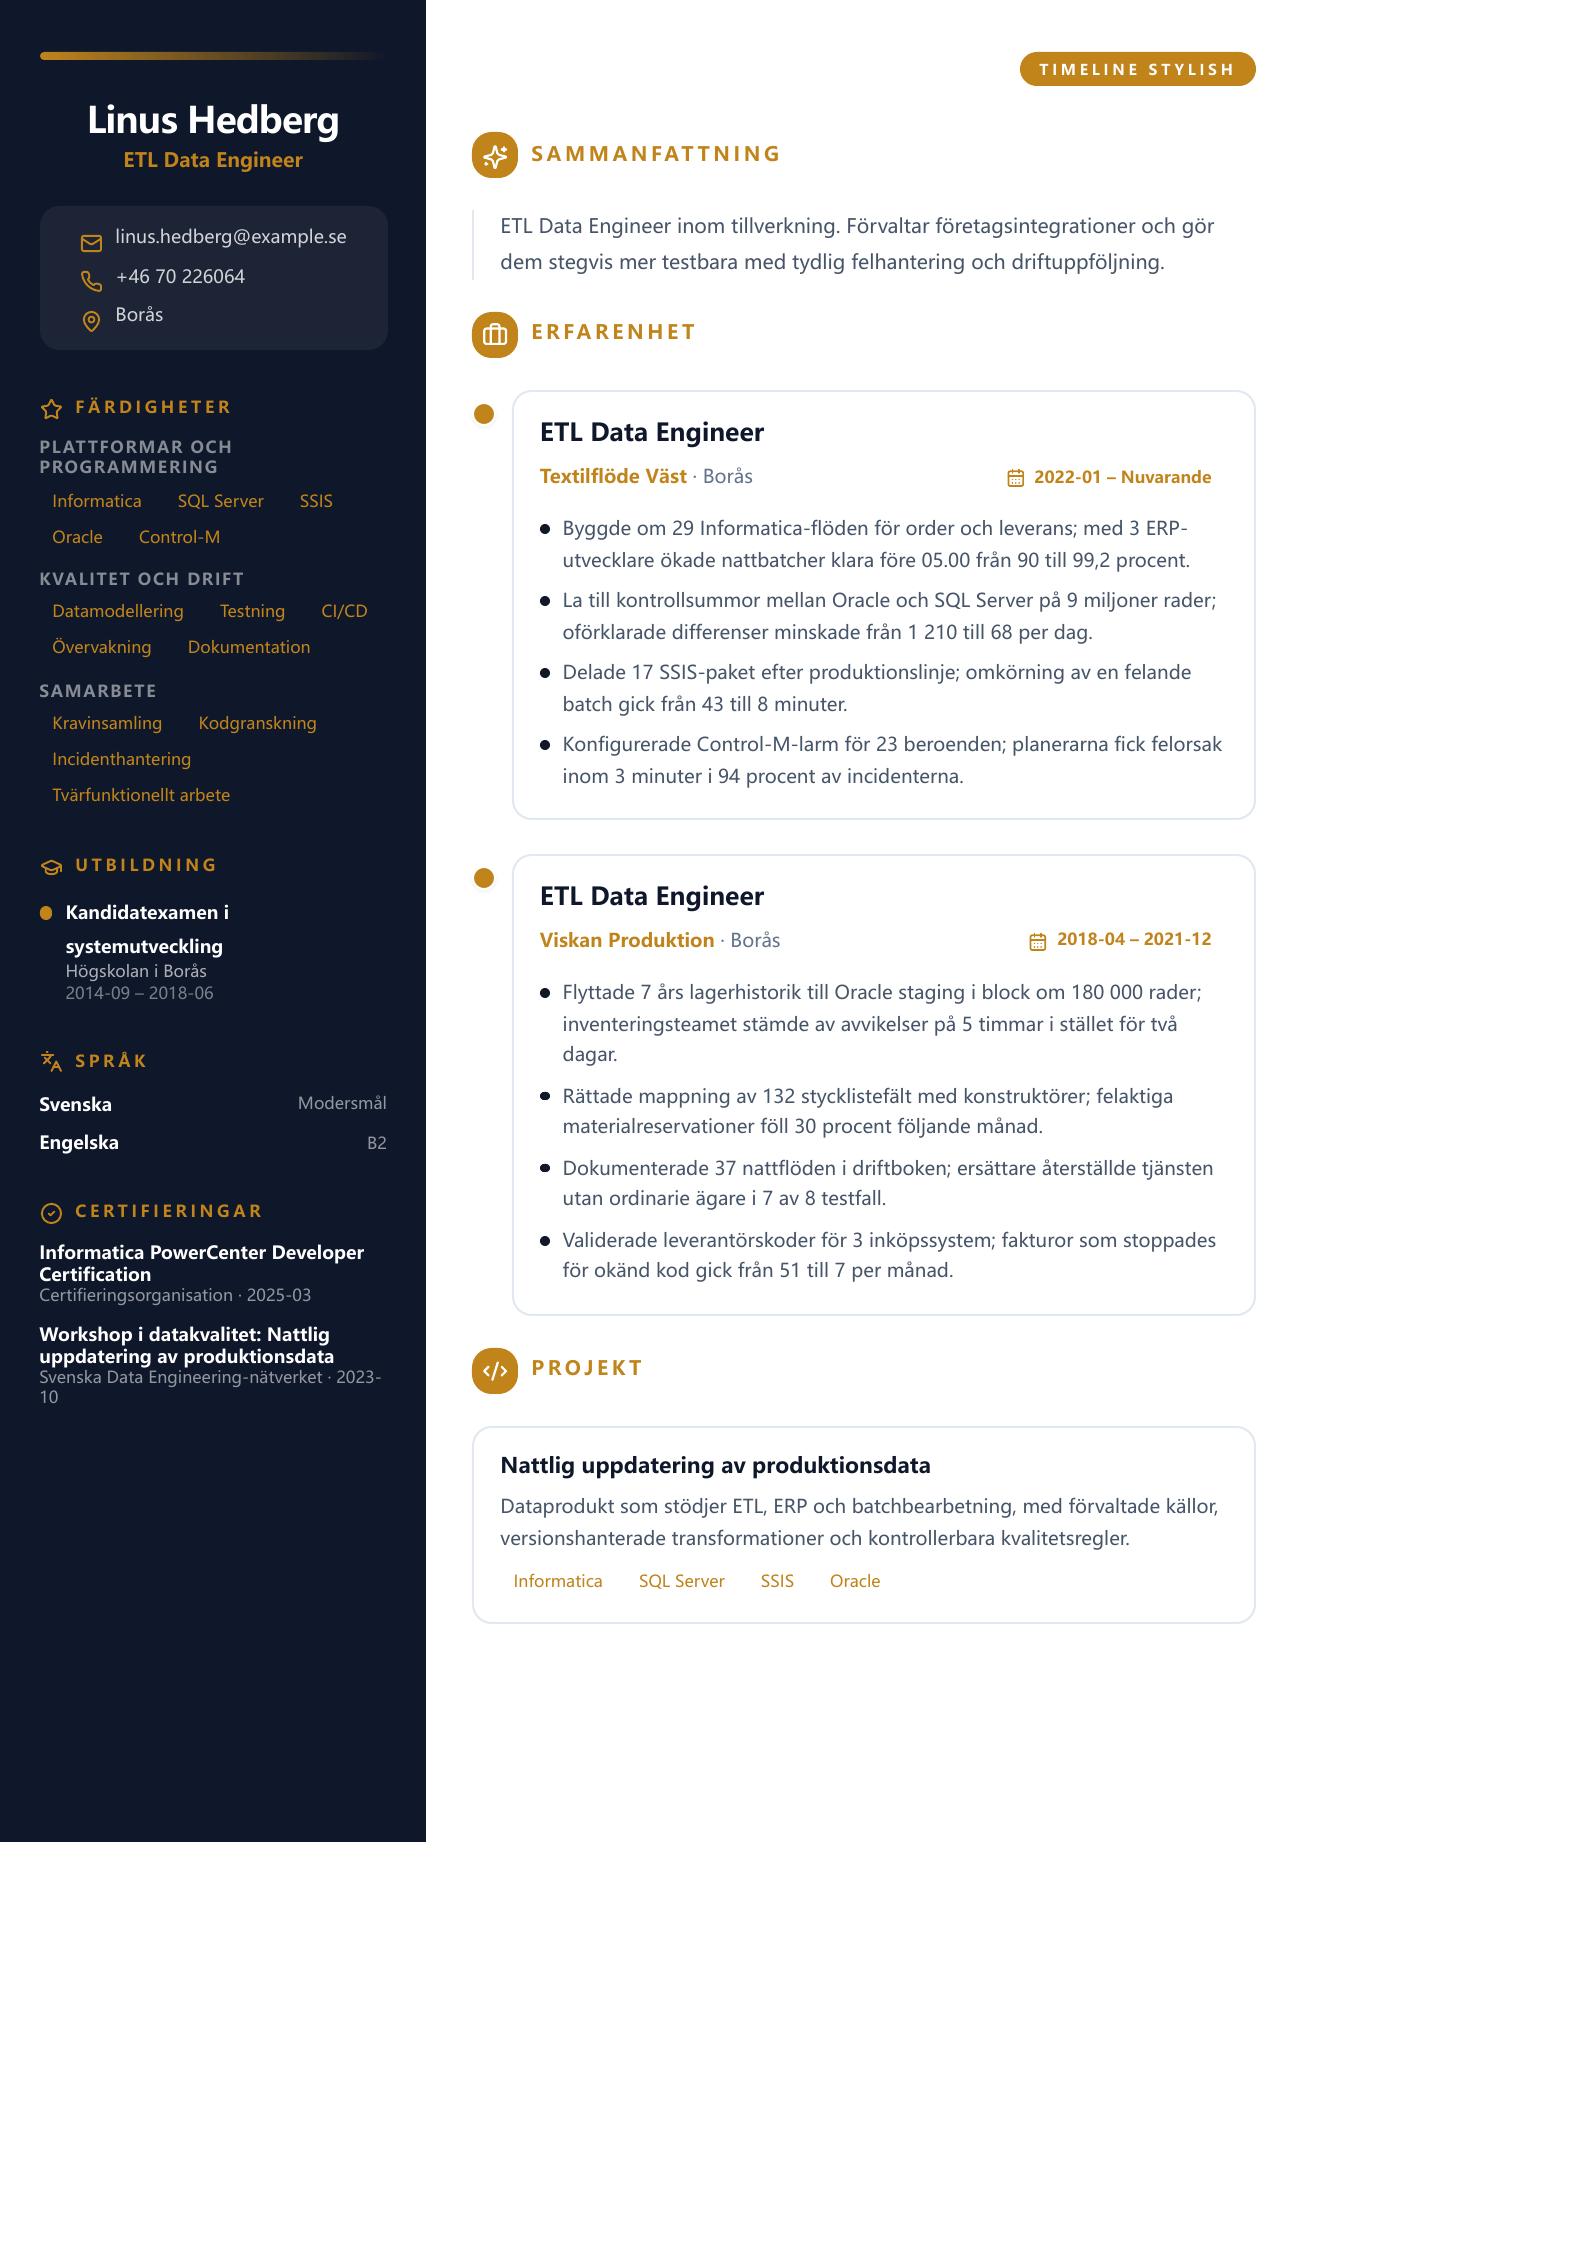
ETL, ERP-integrationer och schemalagda företagsflöden.
Passar dig som: bilddata, annotering och träningsflöden
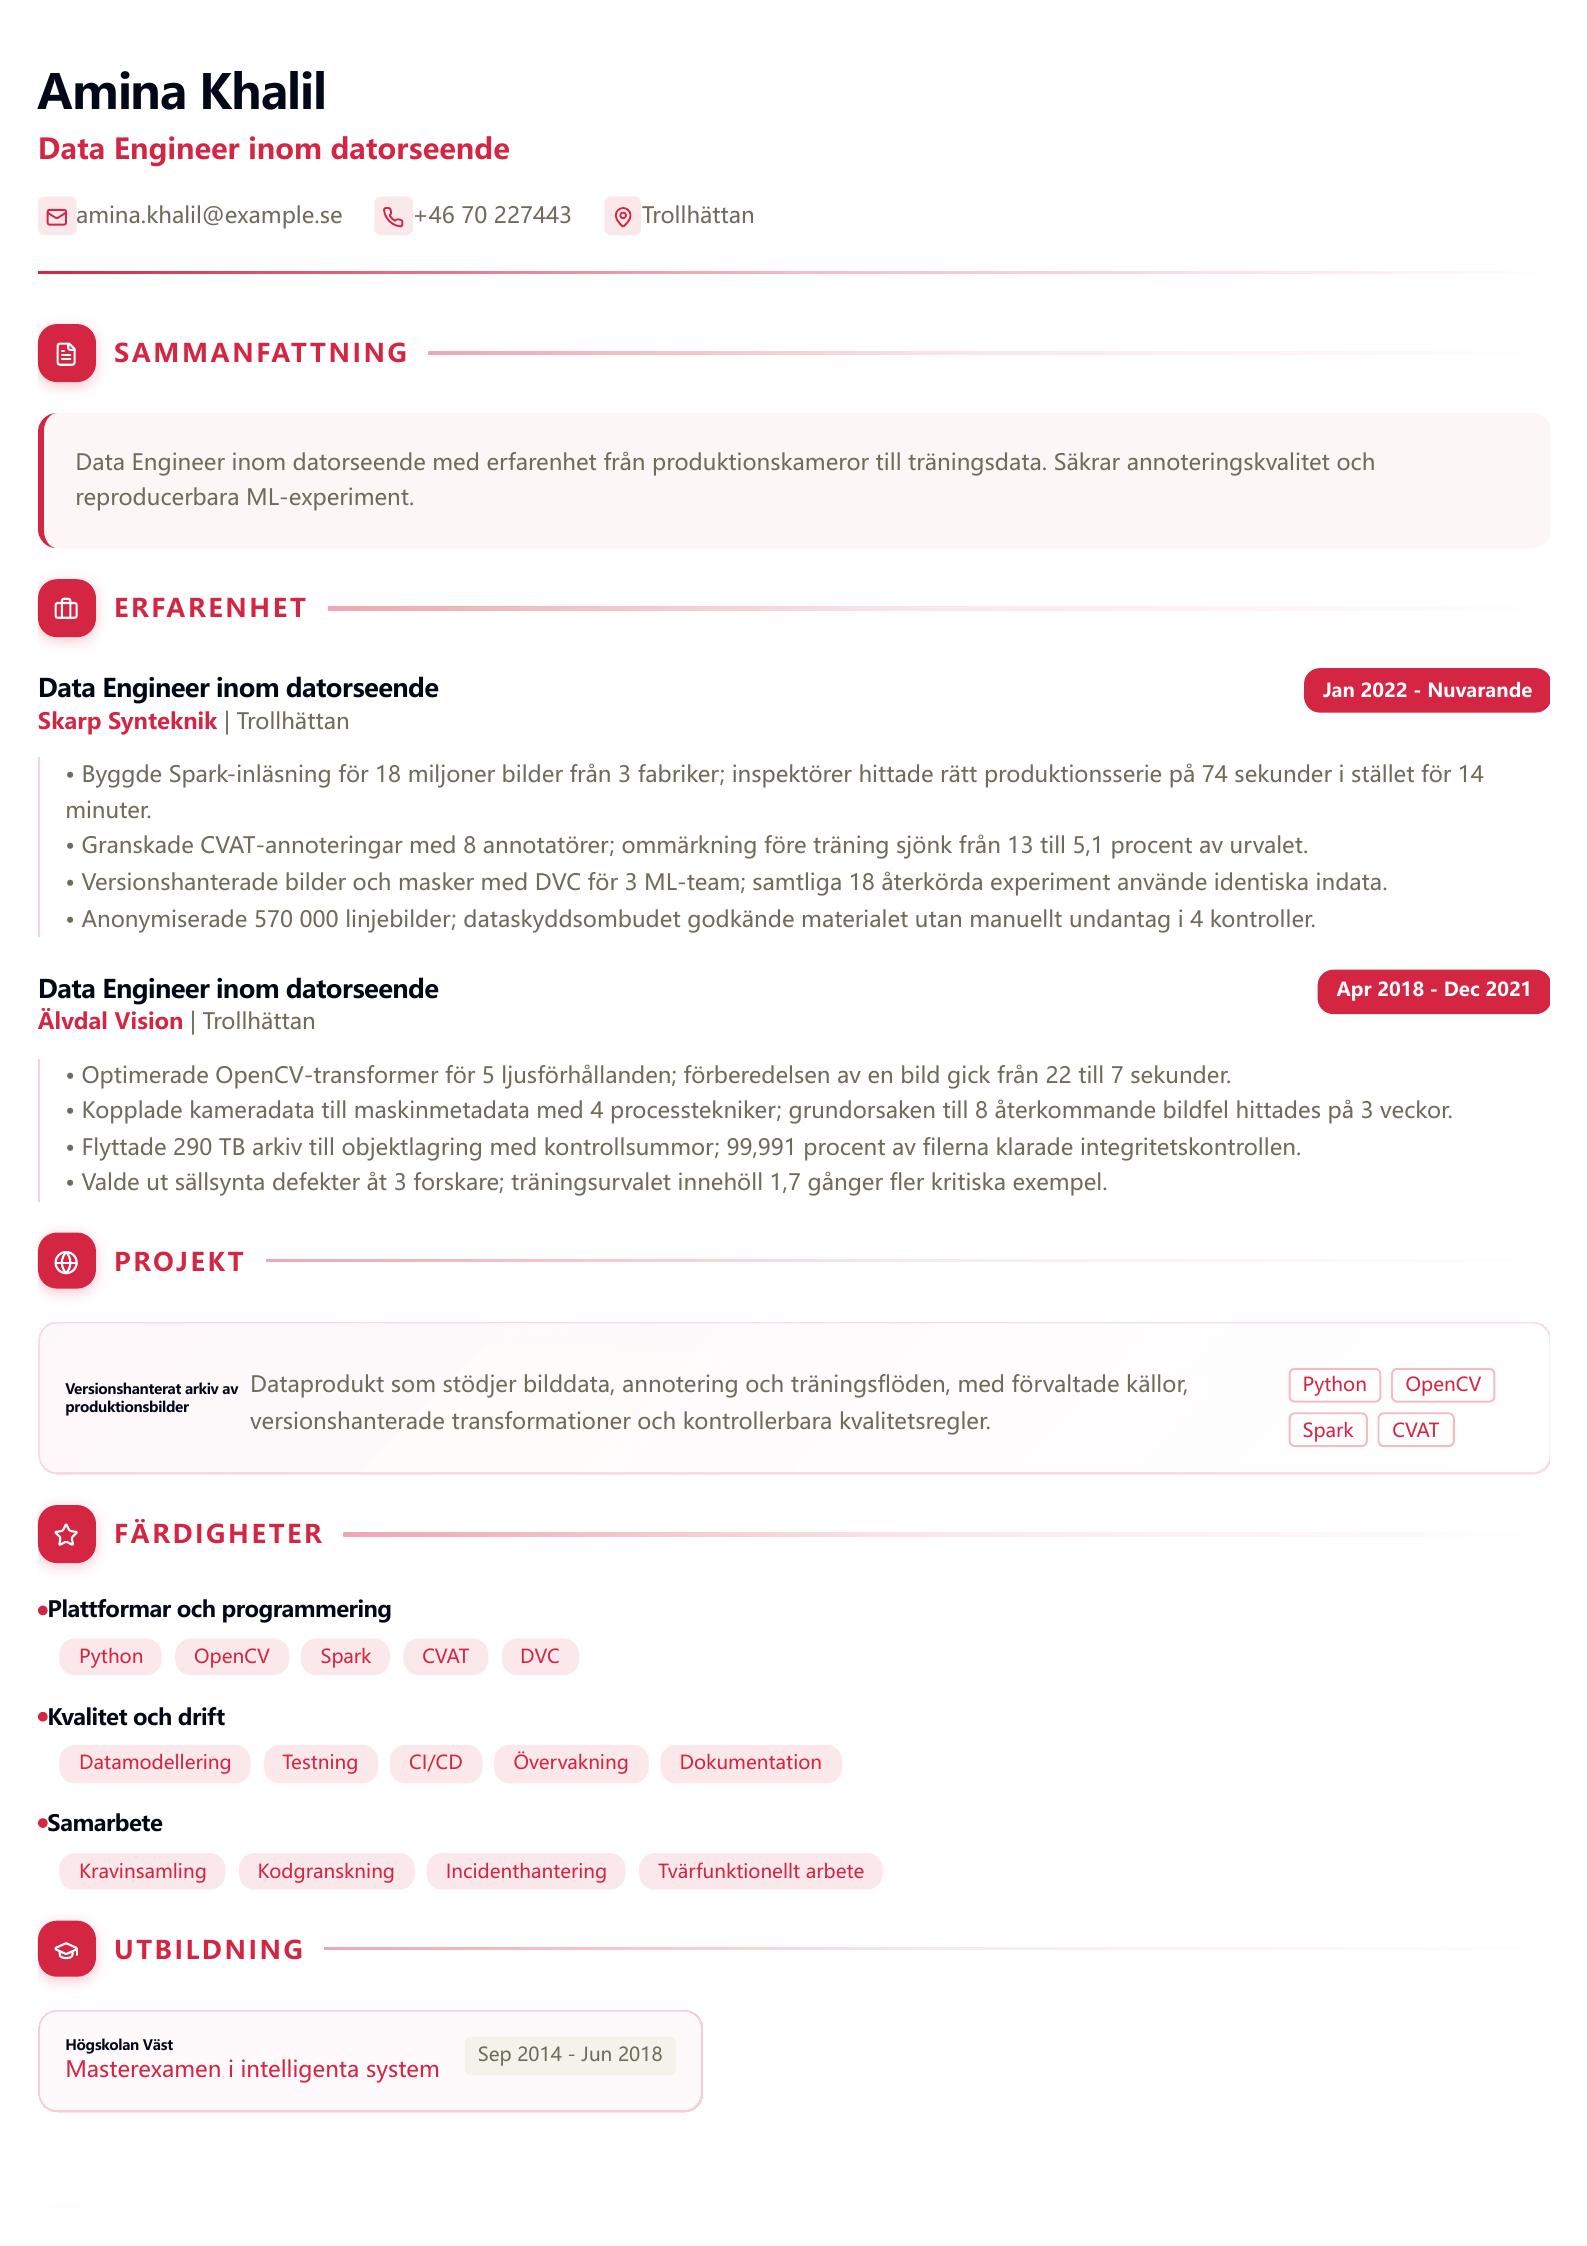
Insamling, annotering och versionshantering av industriella bilder.
Skriv först vad som förändrades: laddtid, datakvalitet, kostnad eller antal fel. Beskriv sedan vilken ändring i flödet som gav resultatet.
Nämn källor, transformationer, partitionering, CDC, orkestrering och kontroller som du faktiskt satte upp. En verktygslista förklarar inte vad du gjorde.
Ange antal rader, system, marknader eller användare. Berätta också om samarbetet med utvecklare, analytiker, ekonomi, säkerhet eller drift.
Skriv utgångsvärde, nytt värde och mätperiod. Använd siffror från loggar, kostnadsrapporter, kvalitetskontroller eller SLA som du kan stå för på en intervju.
Exempel på en konkret punkt
• Delade upp nattlig bearbetning av 128 miljoner sensormätningar i inkrementella PySpark-jobb; med fyra plattformsutvecklare minskade uppdateringen från 52 till 16 minuter på sex veckor.
En sida räcker ofta i början av karriären. Har du flera produktionssystem, plattformar eller ett tydligt driftansvar kan två sidor göra erfarenheten lättare att förstå.
Välj programmeringsspråk, databaser, molntjänster, bearbetningsmotorer och verktyg för orkestrering eller testning som du verkligen har använt. Visa i erfarenhetsdelen vad du byggde med dem.
Ta med praktik, examensarbete eller ett eget dataflöde. Beskriv källor, transformationer, tester och vem som använde resultatet.
Titta på bearbetningstid, datans aktualitet, molnkostnad, felfrekvens eller tillgänglighet. Ange period och mätkälla och skilj ditt bidrag från teamets gemensamma resultat.